SpecOpt:用智能体优化药物分子的靶向特异性

SpecOpt框架通过残基感知接触分析与LLM推理,将现有药物的靶点特异性系统性提升。
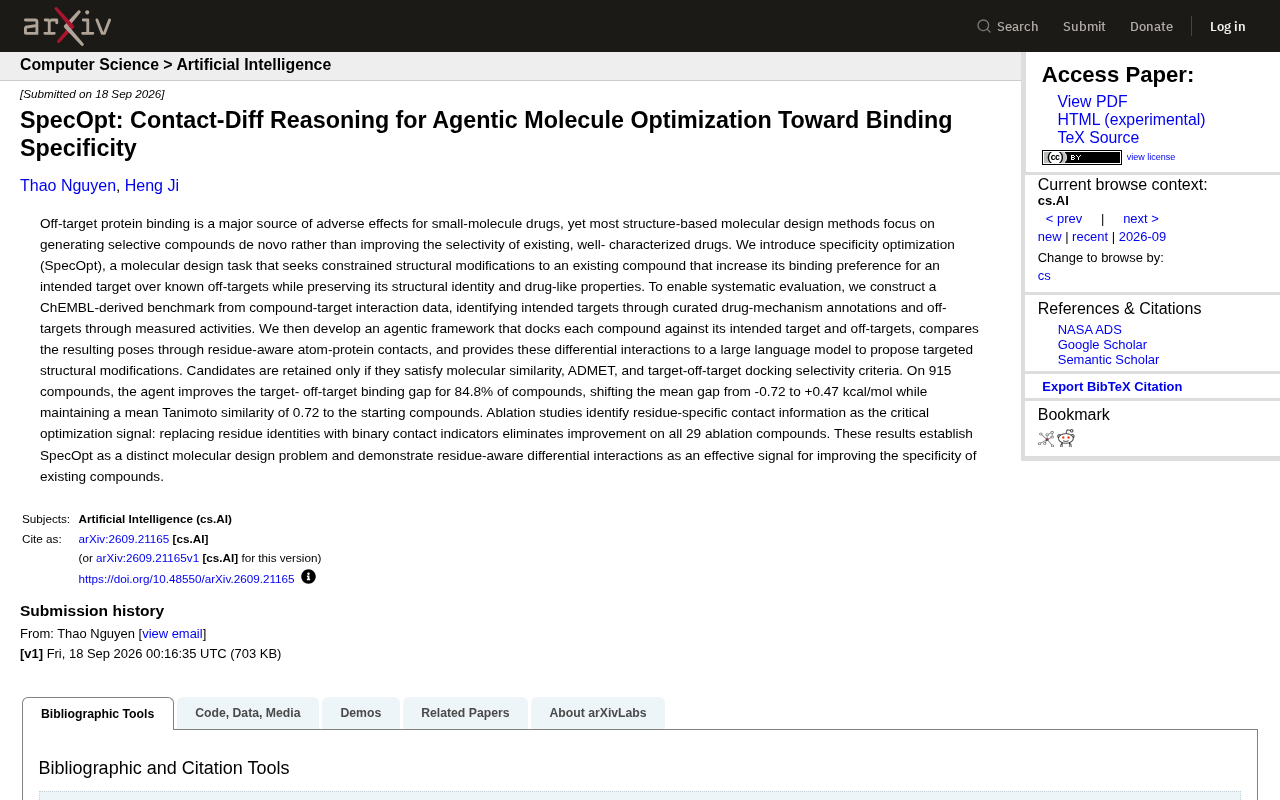
SpecOpt 是一个专门针对"提升现有药物靶点特异性"的AI智能体框架,填补了从头分子设计之外的方法空白。其核心流程是:先将化合物分别对接到预期靶点和脱靶蛋白,提取残基感知的差异化接触信息,再将这些信息输入大语言模型生成针对性结构修饰建议,最终通过分子相似性、ADMET性质及对接选择性三重筛选保留合格候选物。研究者基于ChEMBL构建了包含915个化合物的基准测试集,结果显示84.8%的化合物改善了目标-脱靶结合差距(平均从-0.72升至+0.47 kcal/mol),同时保持平均0.72的Tanimoto相似度。消融实验进一步证明,残基特异性接触信息是优化成功的决定性信号——一旦去除,29个测试化合物的改善效果全部消失。
小分子药物的脱靶结合(off-target binding)是导致不良反应的主要来源之一。传统的结构导向分子设计方法往往聚焦于从头(de novo)生成全新的选择性化合物,却忽视了一个更实际的问题:如何在保持现有成熟药物结构身份的前提下,提升其对目标靶点的结合偏好。arXiv 上一篇最新论文提出的 SpecOpt 框架,正是针对这一空白展开的系统性探索。
什么是特异性优化(SpecOpt)
SpecOpt(specificity optimization,特异性优化)被定义为一项全新的分子设计任务:对已有化合物进行受约束的结构修饰,使其相对于已知脱靶蛋白更倾向于结合预期靶点,同时保留其原有的结构特征与类药性质(drug-like properties)。
这与主流做法形成鲜明对比。多数现有方法关注的是生成全新的选择性分子,而 SpecOpt 关注的是改良已被充分表征的现有药物。这一转向具有明确的现实意义——对已知安全性和药代动力学特征的药物做小幅优化,比推倒重来开发全新分子的风险与成本要低得多。
基准数据集与评估体系
为了让这一任务能够被系统性地评估,研究者基于 ChEMBL 的化合物-靶点相互作用数据构建了一个专门的基准。其中,预期靶点通过经过整理的药物机制注释(curated drug-mechanism annotations)来识别,而脱靶蛋白则通过实测活性数据来确定。
这种数据构建方式的价值在于,它把"特异性"从一个抽象概念转化为可量化、可复现的评测标准。有了明确的预期靶点与脱靶清单,才能真正衡量一个修饰方案是否"更专一"。
ChEMBL 是由欧洲生物信息学研究所(EMBL-EBI)维护的大型开放生物活性数据库,收录了超过 230 万个化合物与逾万个靶点的实验结合活性数据(主要以 IC₅₀、Ki、Kd 等形式呈现)。其"药物机制"(drug mechanism)注释模块专门整理了已上市药物的主要作用靶点及作用方式,数据经人工审核,可信度较高。利用这一模块识别预期靶点,再结合原始活性数据确认脱靶蛋白,使得构建的基准既有明确的生物学意义,又具备大规模、可复现的特点。这种将公开数据库与机制注释结合的构建思路,也为后续研究在更大范围内验证 SpecOpt 方法提供了可扩展的基础。
智能体框架如何工作
SpecOpt 的核心是一个智能体(agentic)框架,其工作流程可拆解为几个关键环节:
对接与姿态比较
框架首先将每个化合物分别对接(dock)到其预期靶点和脱靶蛋白上,然后通过残基感知的原子-蛋白接触(residue-aware atom-protein contacts)比较由此产生的结合姿态(poses)。这一步生成的是差异化相互作用信息——即化合物在目标靶点与脱靶蛋白上接触模式的具体区别。
分子对接(molecular docking)是计算化学中的核心技术之一,用于预测小分子配体与蛋白质受体结合时的三维空间构象及结合能。对接程序通常通过搜索配体在蛋白结合口袋中的旋转、平移和构象变化,找到能量最低的结合姿态(pose),并以结合自由能估计值(单位 kcal/mol)对这些姿态评分——数值越负代表预测结合越强。残基感知的原子-蛋白接触分析则更进一步:它不仅记录配体原子与蛋白质是否存在接触,还具体标注接触发生在哪个氨基酸残基上(如 Asp189、His57 等)。这种精细度对于识别靶点与脱靶蛋白之间的结合差异至关重要——两个蛋白可能拥有相似的口袋几何形状,但关键残基的化学性质(电荷、疏水性、氢键供受体)往往存在微妙差别,这正是特异性优化可以着力的空间。
大模型驱动的结构修饰
这些差异化相互作用随后被提供给一个大语言模型(LLM),由模型提出有针对性的结构修饰建议。换言之,LLM 在这里扮演的是"化学推理引擎"的角色,依据接触差异去判断应该在分子的哪个位置做怎样的改动。
多重筛选把关
生成的候选分子并非全部保留,只有同时满足三项标准的才会被采纳:分子相似性、ADMET(吸收、分布、代谢、排泄、毒性)性质,以及靶点-脱靶对接选择性。这套筛选机制确保了优化后的分子既提升了特异性,又不至于偏离原始药物太远或丧失成药性。
Tanimoto 相似度(Tanimoto similarity,也称 Jaccard 系数)是化学信息学中最常用的分子相似性度量方式,基于分子指纹(molecular fingerprint)进行计算。分子指纹将化合物的结构特征编码为二进制位串,Tanimoto 系数等于两个分子指纹中共同为"1"的位数除以至少一个为"1"的总位数,取值范围 0 到 1。通常认为 Tanimoto ≥ 0.85 代表高度相似,≥ 0.7 代表结构骨架基本保留。ADMET 是评价候选药物成药性的综合指标体系,涵盖口服吸收(Absorption)、体内分布(Distribution)、代谢稳定性(Metabolism)、排泄速率(Excretion)和毒性预测(Toxicity)五个维度。在先导化合物优化阶段同步考察 ADMET,能有效避免"提升选择性却牺牲药代动力学"的常见陷阱,是现代 AI 辅助药物设计的重要质控环节。
实验结果:84.8% 的化合物获得改善
在包含 915 个化合物的测试集上,SpecOpt 智能体为其中 84.8% 的化合物改善了目标-脱靶结合差距(binding gap)。具体数字上,平均结合差距从 -0.72 kcal/mol 提升至 +0.47 kcal/mol——由负转正意味着分子的结合偏好从倾向脱靶转为倾向预期靶点。
更难得的是,在实现这一提升的同时,优化后分子与起始化合物的平均 Tanimoto 相似度维持在 0.72。这说明修饰是克制的,保留了原分子的主体骨架,符合"保持结构身份"的设计初衷。
消融实验揭示的关键信号
论文中最具启发性的发现来自消融研究(ablation studies)。研究者验证了究竟是哪种信息真正驱动了优化效果,结论指向残基特异性接触信息(residue-specific contact information)。
当把具体的残基身份替换为二元的接触指示符(即只标记"有没有接触"而不说明是哪个残基)时,全部 29 个消融化合物的改善效果完全消失。这一对照极为清晰地表明:大模型需要知道分子究竟与哪些残基发生相互作用,才能做出有意义的结构判断。仅仅知道"存在接触"是远远不够的。
意义与展望
SpecOpt 的贡献可以从两个层面理解。其一,它将"提升现有药物特异性"确立为一个独立的分子设计问题,填补了从头设计之外的空白。其二,它证明了残基感知的差异化相互作用是提升化合物特异性的有效信号,为后续研究提供了明确的方法论方向。
将结构对接、接触分析与大语言模型推理结合成智能体流程,也代表了 AI 在药物设计领域一种越来越常见的范式——让 LLM 不是凭空生成分子,而是基于结构化的物理化学证据进行有依据的推理。对于制药研发而言,这类能对已知药物做精准改良的工具,或许比追求全新分子更具落地价值。
相关推荐
AWS MCP Server新增6大区域:AI编程智能体的基础设施提速
AWS将托管MCP服务器扩展至新加坡、悉尼、东京、爱尔兰、伦敦和俄勒冈六个新区域,为AI编程智能体提供统一接口发现、调用和运维AWS服务,降低延迟并满足数据驻留需求。
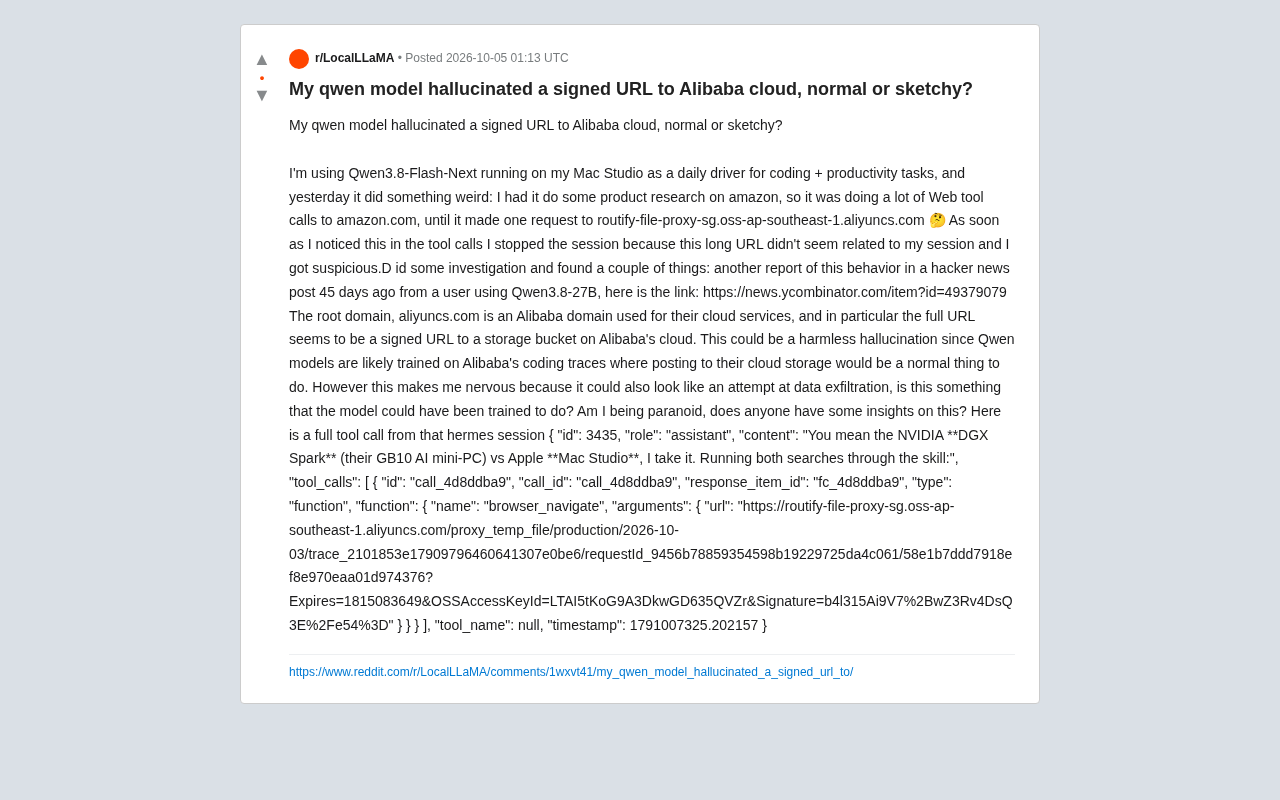
Qwen模型凭空生成阿里云签名URL:幻觉还是数据外泄隐患?
Reddit用户报告Qwen模型在工具调用中凭空生成指向阿里云OSS的签名URL,引发数据外泄担忧。本文结合多份独立报告,分析这究竟是训练数据导致的模型幻觉还是安全风险,并给出Agent工具调用的安全防护建议。
多模态AI转录开罗genizah:右向左语言的VLM微调实践
一篇技术文章探讨如何通过微调多模态视觉语言模型(VLM)自动转录开罗genizah中世纪手稿,解决希伯来语等右向左语言的OCR难题,为数字人文研究提供新工具。