提示词工程入门:从写Prompt到系统化协作
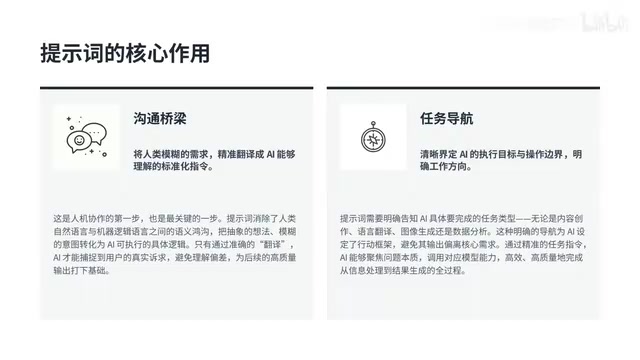
提示词是单次输入,提示词工程是可复用方法体系,有流程、验收标准与明确边界。
文章拆解了一套广受关注的提示词工程课程框架,核心判断是:提示词只是单次输入,提示词工程才是一套可复用的方法体系,区别在于解决一个问题还是一类问题。文章先给出提示词的四层作用——沟通桥梁、任务导航、风格控制、边界约束,再介绍工程化的六步流程(需求拆解、方案设计、执行测试、评估效果、策略迭代、沉淀复用)与四项验收标准(准确率、幻觉、稳定性、成本)。随后文章用相当篇幅讨论局限:提示词无法突破模型能力上限,幻觉只能减少不能消除,上下文长度与长期记忆受技术底层限制,纯提示词难以工程化,还要警惕 Token 成本陷阱。结论是建立正确认知比收藏模板更有价值。
很多人把提示词工程等同于“会写几句好用的Prompt”,这个理解偏差,恰恰是大多数人用不好AI的根本原因。B站一套广受关注的提示词工程系列教程开篇就点破了这件事:提示词是单次输入,提示词工程是一套可复用的方法体系。这篇文章把课程的核心框架拆解出来,并补上一些实际落地时的判断。
提示词到底是什么:不只是“发消息”
课程给出的定义很朴素:你发给AI的任何文字,无论是问题还是描述,都是提示词。但真正有价值的是后半句——提示词是你控制AI最直接的手段,没有之一。
同一个模型,有人只能让它写小学生作文,有人能拿到专业的行业报告。差别不在模型,而在输入。课程用了一个好懂的比喻:提示词像发给AI的神经元信号,你发什么信号,它就往哪个方向思考。
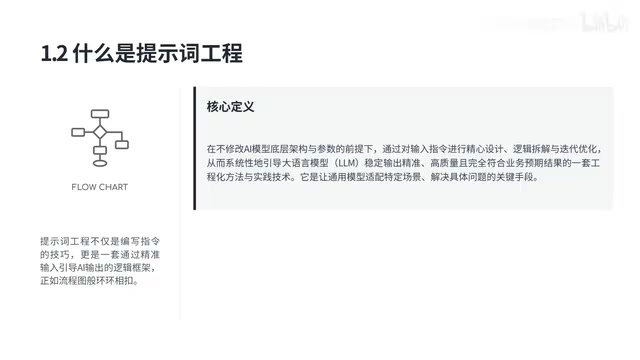
提示词的四个实际作用
课程把提示词的作用拆成四层,这个拆法比笼统说“会提问”要清晰得多:
- 沟通桥梁:把脑子里模糊的需求翻译成AI能听懂的明确指令。外卖不能只说“来份吃的”,AI也一样。
- 任务导航:告诉AI具体做什么。“帮我处理一下这份文件”是无效指令,AI只能随机选一种处理方式,大概率不是你想要的。
- 风格控制:让同一个模型输出商务邮件、朋友圈文案或学术论文的不同语气,减少后期返工。
- 边界约束:这是压制AI“胡说八道”最有效的手段之一。限定分析范围、限定数据口径,输出才会聚焦。
提示词与提示词工程:单次技巧 vs 方法体系
课程反复强调的一个判断是:不存在万能提示词,只存在适合特定场景的提示词。这是两个概念最直接的分界线。
提示词是单次的,像写一行代码执行一次,换个问题可能就失效。提示词工程则是一套完整流程:不修改模型参数,只通过设计输入指令,让通用模型稳定解决具体业务问题。它解决的不是一个问题,而是一类问题。
六步流程
课程给出的工程化路径是:需求拆解 → 设计方案 → 执行测试 → 评估效果 → 策略迭代 → 沉淀复用。前两步把大问题拆成AI能处理的小任务,中间两步验证效果,最后两步把好用的方案固化下来。这套流程和软件开发很像,只不过写的是自然语言。
四个验收目标
判断一个提示词方案做得好不好,课程给了四条标准:提升准确率、减少幻觉、增强稳定性、降低成本(用最少的Token拿到最好的效果)。这四条同时成立,方案才算成功。
Token 是大模型处理文本的基本计量单位,既不完全等于“字”也不完全等于“词”。英文中一个 Token 大约对应 0.75 个单词,中文里一个汉字通常会被切分成 1 到 2 个 Token,具体取决于模型的分词器(Tokenizer)设计。模型并不是按字符理解文本,而是先把输入切分成 Token 序列再编码成向量,因此提示词的长度、结构的复杂度都会直接反映为 Token 数量。这带来两个实际影响:一是成本,主流 API 按输入与输出的 Token 总量计费,提示词越长单次调用越贵;二是上下文窗口,模型一次能处理的 Token 总数有硬上限,超出部分会被截断或报错。理解 Token 是理解“提示词要简洁”“长提示词会丢信息”这些结论的前提。
为什么现在要学:门槛低,但红利真实存在
课程引用的一个数据是,超过90%的用户只会用AI做基础问答。这个比例意味着,多数人手里握着的能力远未被释放。
提示词工程的门槛确实低——不需要编程,不需要懂算法,能把事情说清楚就能上手。课程提到的收益分三个层次:效率上,原本一天的工作可能压缩到一小时;商业上,帮企业优化提示词、用AI批量生产内容,都是可切入的副业方向;创业和自媒体场景下,一个人能完成过去一个团队的产出,试错成本大幅下降。这些说法带有课程推广的乐观色彩,但方向本身不算夸张。
必须承认的局限:提示词不是万能钥匙
这是整节课最值得重视的部分,也是很多教程会略过的内容。
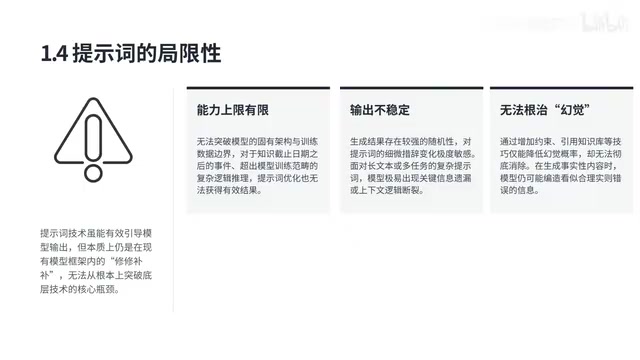
能力上限无法突破
模型的训练数据有截止时间,超出范围的事件它不知道;复杂数学计算它算不出来。再怎么优化提示词,也改变不了模型本身的能力边界。
输出不稳定与幻觉残留
改一个字,结果可能完全不同;提示词太长,模型会“忘事”,前面的要求后面就不记得了。幻觉问题上,提示词优化只能减少、不能彻底消除——只要是大模型就一定会编,重要事项必须人工核实。
幻觉(Hallucination) 指大模型生成看似合理、实则与事实不符或凭空捏造的内容,例如虚构的文献、数据、法规条款或人物言论。它的根源在于模型的生成机制:模型是在根据上下文概率逐 Token 预测下一个词,追求的是“看起来最连贯”,而不是“事实上最正确”。当训练数据中没有覆盖某个问题时,模型并不会主动说不知道,而是倾向于补全一个语义上通顺的答案。常见缓解手段包括:限定信息来源、要求模型在不确定时明确声明、提供参考资料让其基于材料作答(即检索增强生成 RAG)、以及降低采样随机性。但这些手段都只能压低幻觉概率,无法从机制上根除,所以涉及数据、法律、医疗等高风险场景必须保留人工核验环节。
三个技术层限制
上下文长度受限,类似手机运行内存,开多了会清后台;复杂多步骤任务容易跳步骤、断逻辑,必须先拆成小任务;没有真正的长期记忆,每次对话都是全新的,记不住你的偏好和背景,只能靠外部数据库补充。这三个问题由技术底层决定,提示词只能缓解,不能根治。
上下文窗口(Context Window) 指模型在一次对话中能够同时“看到”的 Token 总量上限,包括系统提示、历史对话和当前输入。可以把���理解为模型的工作记忆容量:超出窗口的早期内容会被挤出,模型就表现为“忘了前面说过什么”。不同模型的窗口大小差异很大,从几千到上百万 Token 不等,但窗口大不等于注意力均匀,长上下文中间部分的信息容易被忽略,业界称之为“迷失在中间”(Lost in the Middle)。这也是为什么多轮长对话中要定期复述关键约束、把重要指令放在开头或结尾,以及把复杂任务拆成多个短会话处理。上下文窗口与“长期记忆”是两回事,后者需要外部存储与检索机制来补足。
三个落地层问题
安全与对齐存在误判,完全合法的需求也可能被拦截;纯提示词无法工程化,个人用没问题,做成产品给成百上千人用就缺少版本管理和问题回溯能力,企业级应用一定是提示词加代码;成本陷阱,Token按量计费,提示词越长越贵,高频调用时隐性成本会失控,所以提示词要尽量简洁。
建立正确认知比背模板更重要
这节课的价值不在于教你几个模板,而在于把提示词工程放回它该在的位置:一种与AI高效协作的核心能力,有方法、有流程、有验收标准,也有明确的边界。承认局限,才能在该用人工的地方用人工,在该工程化的地方上代码。对刚入门的人来说,这个认知框架比收藏一百条“神级Prompt”有用得多。
相关推荐
Anthropic招股书深度拆解:8500亿算力赌局与AI新估值逻辑
深度解读Anthropic招股书:2026上半年收入162亿美元、毛利率85.4%、净亏损807亿的真相、8500亿算力承诺拆解,以及AI公司估值的新逻辑——刚性成本与弹性收入的时序错配。
Anthropic招股书9大观察:营收暴增与千亿算力赌局
Anthropic招股书深度解读:营收从0.41亿增至162.86亿美元,净亏损807亿中724亿为公允价值变动,实际经营亏损仅6.93亿。核心风险在于收入按月波动、算力成本按年刚性锁定,7800亿美元合同不可撤销。公益架构下A类股东权利受限,市场面临成长股与周期资产两种定价叙事。
B站最全提示词工程解析:从理论到实战,学会高效沟通大模型
B站UP主系统解析提示词工程:从提示词本质、首尾效应到推理模型与通用模型的策略差异,结合OpenAI六策略与高质量提示词五原则,手把手教你高效沟通大模型。