田渊栋谈ML for Systems:从游戏搜索到系统优化

强化学习可为系统优化提供高效启发式,通过迭代精炼在多个案例中超越传统方法。
文章基于田渊栋在NeurIPS 2021 MLFS研讨会的分享,提出强化学习在复杂游戏中成功的关键是为搜索提供高效启发式,这一思路可迁移到系统优化。系统优化不关心求解路径而只关心最终解,因而可采用一步预测、渐进预测、迭代精炼等参数化方式。文章重点介绍三项迭代精炼工作:网络规划用强化学习智能体迭代生成可行解,再作为LP求解器起点,在大规模拓扑上优于传统求解器;代码反编译通过汇编转图、解码为AST、编译比对迭代修正的两阶段框架,在token与程序准确率上显著优于序列到序列基线;后续Code Breif进一步统一流程并提升性能。最后指出状态动作空间巨大、动作相关、评估缓慢等挑战,并介绍CompilerG环境以降低编译器优化的领域知识门槛。
在NeurIPS 2021 MLFS研讨会上,Facebook AI Research的研究科学家兼经理田渊栋(Yuandong Tian)分享了一个核心洞察:强化学习在围棋、国际象棋、Dota、星际争霸等复杂游戏中取得的巨大成功,关键在于它学会了为搜索提供高效的启发式引导。那么,同样的思路能否迁移到系统优化领域?
系统优化通常面临海量设计选择——可能有数万甚至数十万个参数需要调优。传统方式依赖人类专家理解系统、花费大量时间调参,本质上是在一棵巨大的搜索树中依靠人类知识寻找路径。田渊栋认为,机器学习完全有能力在不那么依赖人类知识的情况下,找到通往系统优化目标的路径。
系统优化与游戏搜索的本质差异
将强化学习用于系统优化,一个有趣的差异在于:我们并不关心“如何得到”解,只关心最终的解是什么。例如面对100个参数旋钮,先调哪个并不重要,重要的是最终配置是否满足所有约束。这为优化问题的参数化方式提供了不同于传统强化学习设定的选择空间。
田渊栋列举了几种可能的策略:一步预测(从问题描述直接预测解)、渐进预测(逐步预测部分解)、以及迭代精炼(从一个初始解出发不断改进,直到陷入局部最优)。甚至还可以学习动作空间本身,即从系统描述中自动找出最佳优化参数化方式。受限于演讲时间,他重点介绍了“迭代精炼”方向下的三项工作。
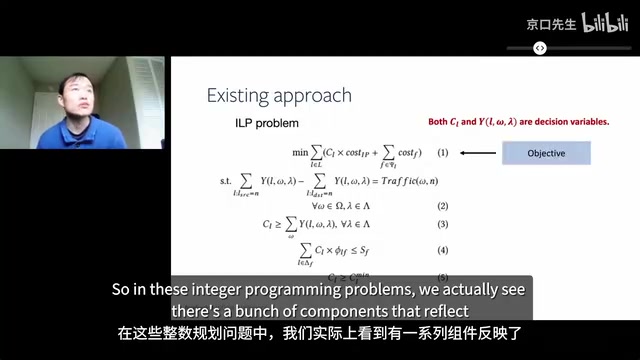
案例一:神经网络规划中的两阶段求解
网络规划是数据中心互联中的典型难题:给定若干数据中心节点,需要决定光纤容量的购买方案,在满足所有流量需求的同时控制成本,并保证对潜在故障的鲁棒性。这类问题可以建模为线性规划(LP),原则上可用Gurobi或CPLEX等求解器解决,但可扩展性堪忧——求解动辄需要数天甚至数周。
实践中人类会设计启发式方法来处理拓扑约束,将问题按地理结构分解后分别求解。但这类方法的核心痛点在于难以找到可行解。田渊栋团队提出了两阶段方案:第一阶段用强化学习智能体从零开始迭代精炼解,每次为某条边增加少量容量,直到整个网络配置满足所有流量约束;第二阶段将这个初始可行解交给LP求解器,作为极佳的起点以加速最终求解。
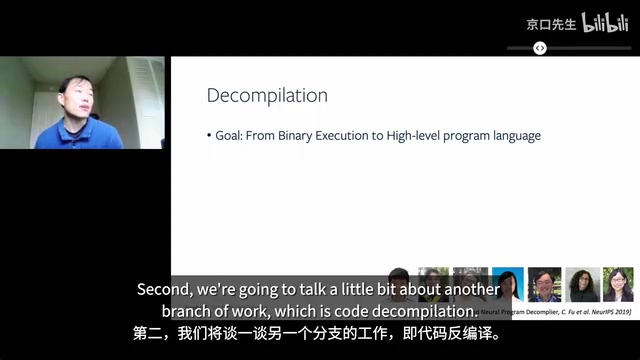
这一方案能够奏效的关键在于:检查解的可行性远比寻找最小成本解容易。团队还引入了两项加速技术——源聚合(合并多个节点以缩小图规模)和状态化故障检查(由于每次只增加容量,已通过的故障场景无需重复检查)。实验结果显示,被称为Neural Plan的方法在小型拓扑上与LP求解器成本相当,而在更大的拓扑上,LP求解器已经超时无法给出有意义的结果,Neural Plan 仍能输出良好成本。代码已开源。
线性规划(Linear Programming, LP)是运筹学中的经典建模框架:在若干线性不等式约束下,最大化或最小化一个线性目标函数。其标准形式可写为 min cᵀx s.t. Ax ≤ b, x ≥ 0,其中 x 为决策变量向量,c 为目标系数,A、b 描述约束。LP 的重要性质是可行域为凸多面体,最优解必出现在顶点上,单纯形法和内点法即基于此设计。Gurobi、CPLEX 是工业级 LP/MILP 求解器,对小规模问题可在秒级求解,但其分支定界等算法在最坏情况下呈指数复杂度,面对网络规划中数万条边、海量故障场景的大规模实例时,求解时间会急剧膨胀。这正是文章提出用学习型启发式为求解器提供高质量初始可行解、从而剪枝加速的现实动机。
案例二:代码反编译的迭代重写框架
第二项工作聚焦代码反编译——从二进制可执行代码还原出高级编程语言源码,这是编译的逆过程。挑战在于硬件架构和编程语言繁多,传统方法每支持一种新语言都需要大量人工重写整个反编译框架。团队的目标是构建一个端到端的通用框架,同时兼顾二进制程序的功能与语义。
他们的方案同样分两阶段。第一阶段从汇编代码生成代码草图:将汇编代码转化为图结构,用N叉树编码器捕捉底层代码的指令间与指令内依赖关系(如共享内存、分支跳转等),再通过注意力机制解码为抽象语法树(AST),而非直接生成token级别源码,从而利用源码的语法结构。这一阶段能产出语法正确但可能包含错误的程序,例如错误识别的token、缺失行或冗余行。
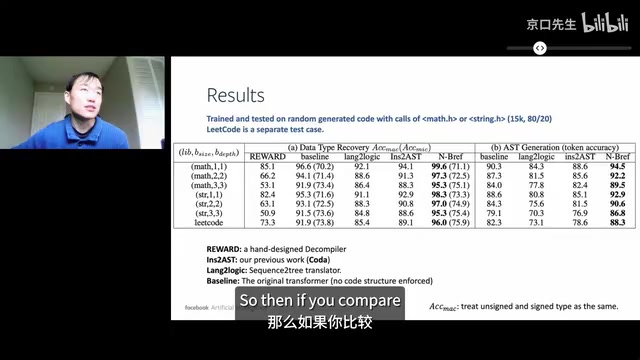
第二阶段是迭代重写:利用编译器将生成的源码重新编译回汇编,与输入汇编比对,发现错误后修正并重复该过程。实验在Clang O0配置下、多个合成程序基准上进行。结果显示,结合AST与注意力机制的方案在token准确率上优于朴素的序列到序列模型,而加入错误修正后性能进一步提升。在更严格的程序准确率指标上,错误修正带来的增益尤为显著,例如在某个数学库程序上从64%一路提升到100%。
后续版本Code Breif(Code First 2.0)进一步统一了流程:从空AST树开始迭代精炼,将汇编图建模为包含数据流边、指令结构和控制流边的多类型图,训练时利用已知的汇编与源码对,让每一步输出匹配源码AST。在包含库函数调用的更难数据集上,性能相比前代进一步提升。消融研究确认了图神经网络编码程序结构、位置编码和记忆增强等组件的必要性。此外,数据类型恢复作为并行过程,同样采用迭代精炼结构,进一步提升了反编译性能。
抽象语法树(Abstract Syntax Tree, AST)是编译器前端对源码语法结构的树状表示:内部节点对应运算符、语句或声明等语法构造,叶子节点对应标识符、字面量等词法单元。与原始 token 序列相比,AST 显式编码了嵌套与优先级关系,例如表达式 a+bc 在树中 bc 位于更深的子树,从而无需括号即可表达结合性。正因如此,让模型直接解码为 AST 而非逐 token 生成源码,可以把语法合法性作为结构约束内建于输出中,显著降低生成非法程序的概率。同时,AST 与源码之间可双向转换,便于在迭代重写阶段将生成结果还原为源码、再编译回汇编做比对,这构成了文章两阶段框架的关键接口。
挑战与展望
田渊栋总结道,机器学习用于学习系统优化的启发式方法已被证明可行,但前路仍有诸多挑战。首先是巨大的状态-动作空间难以处理,需要精心设计状态与动作表示;其次真实系统中存在大量相关动作;再者系统优化的评估速度缓慢,严重制约强化学习的应用。
在网络规划案例中,团队通过状态化故障检查和源聚合来加速可行性评估。但对于某些系统问题,系统本身运行就可能耗时数天乃至数周,此时如何学习良好的价值函数来加速评估就成为关键问题。
演讲最后,田渊栋介绍了团队的新工作CompilerG——一个面向编译器优化的鲁棒、高性能强化学习环境。编译器中有大量旋钮可调,用于让程序运行更快或二进制更小,但调优极其耗时且依赖领域专业知识。CompilerG旨在让机器学习或强化学习发挥作用,而不要求使用者具备编译器的领域知识。
强化学习中的价值函数(value function)用于估计从某状态出发的长期回报,是策略评估与改进的核心组件。在系统优化场景下,若一次真实评估需要运行系统数天,智能体就无法像在游戏中那样通过海量试错来学习。此时可行的思路是用学到的价值函数或代理模型(surrogate model)替代真实评估,对候选动作的收益做快速预测,仅在关键节点调用昂贵仿真。这与 AlphaGo 中用价值网络评估棋局胜率、减少蒙特卡洛 rollout 次数的逻辑一脉相承,也是文章将“为搜索提供启发式”从游戏迁移到系统优化的深层技术对应点。
相关推荐

Cloudflare开源AI代码安全审计工具,获6万星
Cloudflare开源Security Audit,为AI编码Agent提供免费安全审计。三步工作流:应用测绘、多Agent对抗找Bug、三级分类报告,源自内部漏洞狩猎系统,近6万星标。

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。