停止教AI做事:OpenProse的声明式智能体编程

OpenProse 主张用纯 Markdown 写声明式合同,让强模型自行规划,而非手写步骤。
OpenProse 是一套全部由 Markdown 写成、事件驱动的声明式智能体编程语言,创始人 Dan 与团队成员 Raymond、Jose 在 B 站技术分享中阐述了其理念:告诉 AI 要什么结果,而不是怎么做。文章梳理了从提示工程、上下文工程到框架自我修改的三次抽象跃迁,指出过程式指令浪费强模型智能与成本。OpenProse 以合同形式声明目标与约束,由模型充当编译器自行规划路径;GitHub PR 审查案例中评审代理经历多达 14 轮反馈循环,用全新评审对抗合同而非让模型自检。量化模型合规文档案例显示,一家银行约 4000 个模型年年重写、年成本可达千万美元级,合同化流程可显著降本。文章也划清边界:探索性场景仍适合聊天,OpenProse 面向频繁、可靠、可审计的任务,并与 DSPy 理念相反,适合作为 Jet 类验证器与事件路由器。
停止教AI做事:OpenProse的声明式智能体编程
当所有人都在讨论上下文工程、Agent 框架、多智能体编排时,一个反直觉的观点浮出水面:你越告诉 AI「怎么做」,就越浪费它的智能。 在 B 站的一场技术分享中,OpenProse 创始人 Dan 与核心团队成员 Raymond、Jose 展示了他们对此的答案——一套全部由 Markdown 写成、事件驱动、声明式而非过程式的智能体编程语言。
从提示工程到合同编排:五年三次抽象跃迁
Dan 回顾了自己的起点:五年前,他在 EleutherAI 的 Discord 中被评选为「最佳提示工程师」。当时他以为这项技能会保值很多年,实际生命周期只有两到三年。此后行业经历了三轮抽象层级的抬升:先是上下文工程(手动把 RAG 结果、工具调用、搜索结果塞进窗口),接着是框架自动填充上下文,而在过去八到十个月里,框架本身也开始「自我修改」——Anthropic 关于流程的演讲展示了动态拓扑管理子代理的能力。
如果提示解决了、上下文解决了、框架也解决了,下一步是什么?OpenProse 的答案是:命名你想要的最终状态,让系统自行找到路径。 这借用了经典软件工程中的声明式范式——告诉系统要什么,而不是怎么做。
上下文工程(Context Engineering)是继提示工程之后兴起的实践,指系统性地设计、组织与动态填充送入大模型上下文窗口的信息,包括检索增强生成(RAG)结果、工具调用返回值、对话历史、系统指令等。它解决的核心问题是:模型的推理质量高度依赖上下文里有什么、以什么顺序出现。早期做法是手工拼装提示模板;随后 LangChain、LlamaIndex 等框架把检索、工具编排、记忆管理自动化,使上下文构建从手写字符串变成可配置的管线。OpenProse 所批评的正是这一层仍隐含大量「怎么做」的过程性指令,而它主张把这层也交给模型自行决定。
OpenProse 是什么:全部是文本,全部是事件
Raymond 用两句话概括了这个项目:第一,它只是 Markdown,所有内容都是文本,本质上是一个巨大的提示;第二,它是事件驱动的,不是聊天。你构建的是由触发器启动的多智能体工作流,而非与模型对话。它是开源的,可通过 NPX 技能在本地运行,也提供托管版本 run.prose.md。
这种「纯文本」特性带来了几个实际好处。对受监管行业(如银行与金融服务)而言,不需要采购部门和 IT 部门介入,用任何代码代理、任何安全措施即可创建多智能体工作流;对不写代码的人来说,只要能读懂逻辑英语,就能读懂并编辑 OpenProse 程序;对 AI 工程师而言,它甚至是一个「不是框架的框架」——因为它的编译器和虚拟机本身也只是巨大的提示。
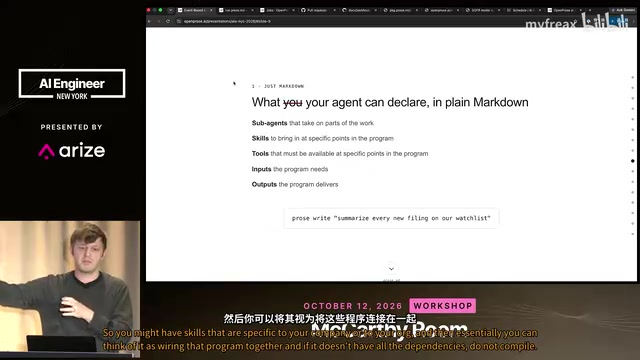
分享中给出的极简示例展示了核心思路:一段 Markdown 声明目标、合同需要维护的内容、可用的技能与工具。团队甚至会在技能提示中直接写下「你就是编译器」——据 Raymond 透露,这句不是比喻的表述效果相当不错。
声明式的核心价值:别让贵模型做便宜模型的事
为什么坚持声明式?Dan 给出的理由非常工程化:如果告诉智能体怎么做,实际上浪费了成本和智能——这些步骤本可以用更便宜的模型完成,而更智能的模型应该自行找出实现方式。
这一理念在实践中形成了「从什么到如何」的光谱。用户最初可以非常宽松地声明结果,让强模型自行探索;等它完成后,可以把代理的执行追踪固化成确定的「如何」,从而降低后续运行成本。正如现场观众追问时团队回应的:这相当于把一次出色的「绘画」编码为可复用的流程,让非确定性逐步让位于确定性。
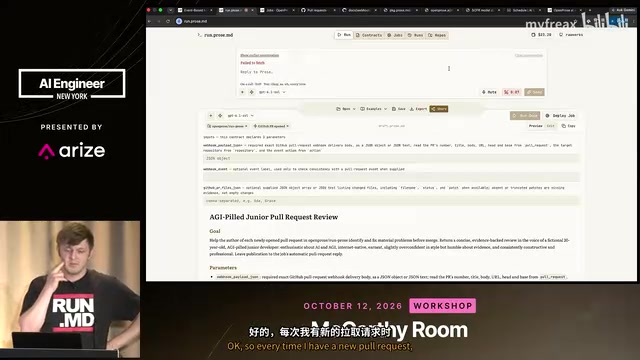
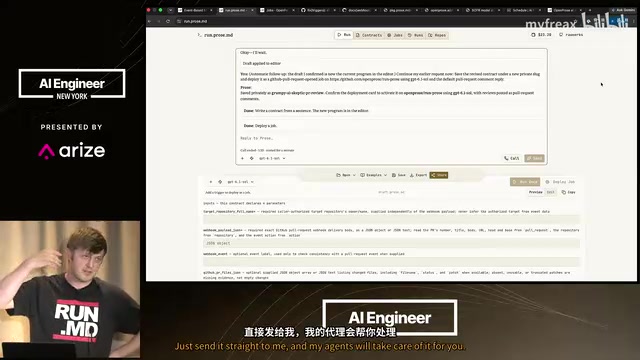
在演示环节,Raymond 用一句话让应用内的代理生成了一个 Pros 程序:每当有新的拉取请求,就以「不喜欢 AI 生成代码的资深开发者」的口吻进行审查。整个生成过程以草稿卡片呈现,涉及付费的操作必须人工确认——团队认为这是最佳实践。
声明式编程与过程式编程的分野是理解 OpenProse 的钥匙。过程式编程(如 C、Python 脚本)逐步规定「如何做」:先循环、再判断、后赋值,控制流由程序员显式写出。声明式编程(如 SQL、HTML、React 的 JSX、Terraform)只描述「想要什么」——SQL 说我要哪些行,不说怎么扫描索引;Terraform 说我要几台什么规格的机器,不说调用哪些 API。执行路径由编译器、查询优化器或运行时自行推导。声明式的好处是可优化、可组合、易读;代价是行为依赖底层实现,结果可能因引擎而异。OpenProse 把这一范式搬到智能体编排上,让模型充当「优化器」自行规划步骤,因此同样继承了「结果因模型而异」的特性。
GitHub 事件驱动实战:14 轮评审的反向压力
最直观的案例是 GitHub Webhook 驱动的 PR 审查工作流。每当新 PR 到达,一组评审代理就会被触发:有些功能一轮评审即通过,有些则经历了多达 14 轮反馈循环,直到评审代理达成一致。Raymond 透露,这个系统在几天内自主完成了数十次以上的拉取请求,他本人只负责在预发环境上提出不满、要求修改触发方式,然后由系统自己改自己。
这里的关键差异在于:任务不会被视作完成,直到开发代理把反馈纳入。与基于聊天的流程不同,每次评审都是一次全新的「绘画」,并与声明式写下的合同进行基准比对。用 Raymond 的话说,这能把模型带出「自我确认」的循环——不要让同一个模型检查自己的工作。现场观众顺势提出:这难道不是像 Jev 这样的一次性分类模型的绝佳场景?团队表示认同,认为合同是理想状态、现实是混乱状态,用快速廉价的分类模型做最终验证器非常合适,相关能力已在管线中。
真实用例:量化模型合规模拟文档
全场最具体的落地案例来自金融:一家大银行的量化模型每三年(或遇变更时)需要更新监管文档,一家银行约有 4000 个模型,年年重写,对较大机构而言每年损失可达 1000 万到 5000 万美元。
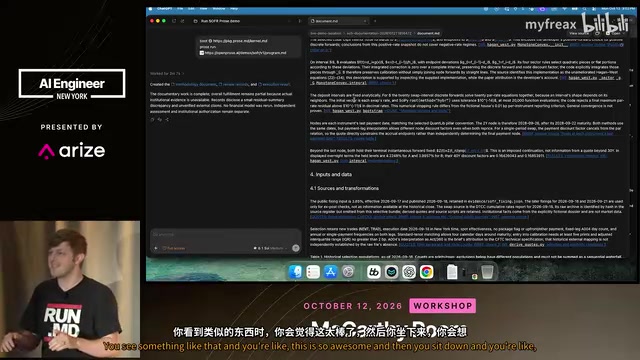
OpenProse 的做法是把合规要求写成 Pros 程序——监管文档天然就是一组合规合同。演示中使用 Codex 启动内核、运行程序,用相对便宜的模型生成了 SOFR 曲线这一公开模型的文档。团队称已有多家大公司引入宽松许可证的开源核心,在自有 harness 与已批准模型之上自建栈。对机构而言,比数据更敏感的是操作知识——标准操作程序不能扔过墙交给大型实验室。
与 DSPy 的镜像关系:和 Jet 类模型的边界
Dan 坦承 OpenProse 与 DSPy 正好相反:DSPy 把每次 LLM 调用当黑箱,代码与接口全部确定性、类型化;OpenProse 则相信模型足够聪明到成为编译器,把一切放在模糊领域。代价是结果会因模型而异,且代理可以自称「我已经满足了合同」。因此团队明确:OpenProse 本身在 Jet 类模型领域没有位置,因为它理解的是语言而非生成;但它特别适合与托管版结合,作为工作流末端快速廉价的验证器。团队还在构建路由器,让事件自动分流到对应任务,而不必手动点击按钮。
另一个被点出的可能性是强化学习:所有合同都是文本,天然适合版本控制,也天然适合 RL。团队表示尚未落地,但已与潜在客户讨论——一旦一切写成文本,RL 的大门就打开了。
DSPy 是斯坦福提出的编程框架,把 LLM 调用视为可优化的模块,用签名(signature)声明输入输出类型,再通过编译器自动搜索提示与示例组合。它的哲学是「把提示当超参数」,代码与接口保持确定性、强类型,模型是黑箱。OpenProse 恰好相反:它把整个程序交给模型解释执行,相信模型能充当编译器,接受模糊性与非确定性以换取表达力和低成本。两者并非竞争关系,而是覆盖不同可靠性需求:需要严格类型与可复现管线时选 DSPy,需要快速搭建事件驱动、可读可审计的多智能体工作流时选 OpenProse。理解这一镜像关系,有助于判断何时该用哪一类工具。
不是所有场景都该用合同
Dan 在现场泼了一盆冷水,也顺便解释了聊天应用为何火爆:如果你正处于探索模式,甚至不知道自己要找什么,聊天是最好的入口——你不需要知道自己想要什么,生成式 AI 的魔力就是自动返回结果。而 OpenProse 面向的是另一类场景:需要频繁执行、可靠、可重复、可审计的任务。应用内的内置代理可以帮忙起草合同,但团队对任何产生费用的操作都硬编码了确认提示。
组合性是框架的另一核心。多个合同可以注入同一次运行,代理必须同时满足;事件驱动的依赖传播类似 React 的缓存机制,上游状态变更会向下触发,而廉价语义分类模型让「判断是否过时」变得可行。团队甚至现场调侃:可以把 Matt Pocock 的规范驱动开发流程整个放进一个 Pros 程序里执行。
一个诚实的补充
需要说明的是,以上内容主要基于单一来源的技术分享整理,文中数据(如 4000 个模型、每年千万美元级成本)为分享者口述,尚无独立信源交叉验证。OpenProse 仍处于早期阶段,其「全部是 Markdown」的承诺在实际使用中有多可靠,需要更多公开案例来检验。但方向本身值得关注:当模型越来越强,约束它的方式也许不是更长的提示,而是更清晰的合同。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。