同一个本地AI为何在不同电脑上体验天差地别?
本地AI选型没有唯一答案,硬件、内存、速度与任务需求共同决定最优解。
这篇文章以一个开票应用开发场景为线索,系统拆解了本地大模型选型的核心变量。文章指出,模型下载大小并不等于实际显存需求,量化、上下文和运行时开销都会额外占用内存;不同硬件路线(NVIDIA独显、Mac统一内存、纯CPU)各有能力边界,不能套用同一套逻辑。Qwen、Gemma、DeepSeek等主流模型各有侧重,但公开benchmark只能用于初筛,真正有意义的测试必须在自己的硬件上用相同条件跑真实任务。最终建议是:挑三个候选模型(一个快、一个通用、一个专才),用真实提示比较首token时间、生成速度和答案质量,选那个能找到正确原因、装得进内存、响应快到愿意持续使用的模型。
同一个本地大模型,在一台电脑上响应即时,在另一台上慢得让人抓狂,到了第三台甚至完全跑不起来。更麻烦的是,能写出最佳答案的那个模型,未必适合你真正要做的工作。海外博主的这段深度解析,用一个假想的场景把本地AI选型的所有关键变量都串了起来——而结论出人意料地朴素:不存在唯一的"最强本地模型"。
一个开票应用引出的真实抉择
设想你在开发一个小型开票应用。你希望有个助手帮你解释报错、审查客户导入数据,甚至读一张截图。你的Windows笔记本有8GB显存,朋友的Mac有32GB共享内存,还有人根本没有独立显卡。哪个本地AI适合你?答案远不止看模型名字那么简单。
博主强调,选择会随着工作内容、内存容量、你能忍受的速度、以及你愿意投入多少配置时间而改变。所谓本地AI,指模型运行在你能掌控的硬件上——游戏PC、Mac、Linux工作站,甚至只靠CPU的笔记本。模型文件下载到本地,提示词可以留在机器上,前提是应用和相连的工具也做了相应配置。
这里有个容易忽视的细节:本地推理让你掌控模型的运行,但并不会自动让每一个集成都变得私密。一个连接了云端搜索工具的本地模型,仍然会把搜索请求发到你的电脑之外。本地的三大实际优势是:客户数据留在设备上、没有按token计费的API账单、以及在云服务不可用时仍可使用。代价则是你自己变成了基础设施团队——内存、散热、电力、下载和更新的时间,全得你来扛。
显存陷阱:下载大小不等于运行需求
最常见的第一个坑,是看着模型下载体积就以为这就是电脑需要的全部。事实并非如此。模型权重需要内存,对话上下文、临时可视化、操作系统和你正在用的应用,同样都要占内存。
量化(Quantization)会压缩模型权重。4-bit版本比高精度版本占用少得多的内存,代价是一些质量损失。这正是那些本来太大的模型能跑在消费级GPU上的原因。但博主提醒,4-bit的文件大小只是起点,不是显存需求的保证。
上下文(Context)是模型一次能考虑的文本量。短问题占用很少,一旦你喂进一个长源文件、几段错误日志和来回对话,内存占用就会飙升。以一个14GB的模型下载为例:这并不意味着它能干净地塞进16GB显卡还剩2GB余量,上下文和运行时也需要空间。如果溢出到系统内存,它或许还能跑,但速度会因为数据要在不同类型内存间搬运而急剧下降。
反向的意外同样真实:32GB的Mac并没有32GB专用显存。苹果芯片采用统一内存,由CPU、GPU、操作系统和应用共享。这个共享池让部分Mac能跑更大的模型,但模型仍要和其他一切争抢空间。所以比较机器时要问三个问题:模型可用多少内存?你需要多少上下文?模型有多少部分真正被GPU加速?这三个答案比单一的下载数字有用得多。
量化的技术本质值得稍作展开。神经网络的权重原本以32位或16位浮点数存储,4-bit量化将每个权重压缩到4个二进制位,体积缩小约4-8倍。这带来的质量损失在小模型上较为明显,在参数量足够大的模型上则相对有限——这也是为什么"大模型的4-bit版"往往比"小模型的全精度版"更受推荐。常见的量化格式包括GGUF(llama.cpp使用)和GPTQ,不同格式在不同运行时上的兼容性和速度表现也有差异。选择量化等级时,Q4_K_M、Q5_K_M这类标注中的字母和数字代表具体的量化策略,K系列在相同大小下通常比早期方案质量更好。
硬件路线图:从8GB显存到无显卡
博主把选择映射到不同硬件上。在配备NVIDIA显卡的Windows或Linux桌面,专用显存是快速GPU推理的主要约束。8GB的RTX 4060能很舒服地跑紧凑模型,但它不会因为电脑有额外系统内存就变成32GB显卡。12GB打开了更多能力较强的量化模型的大门,但长上下文仍可能挤占它们;16GB则给模型和工作上下文留出更多余地。
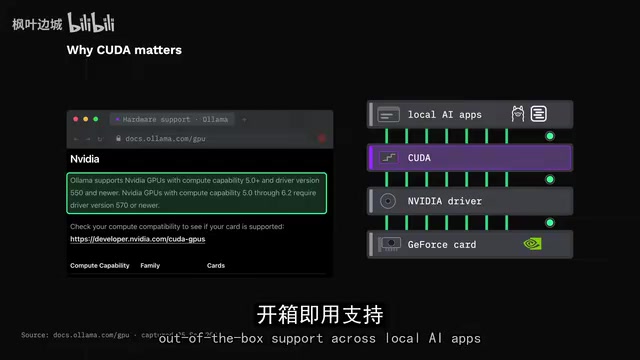
NVIDIA因为CUDA被广泛支持,往往在各类本地AI应用中兼容性最好。AMD显卡性价比可以很高,尤其在软件栈对显卡支持良好时,Linux上的ROCm是一条重要路径。llama.cpp项目列出了NVIDIA的CUDA、AMD的HIP、苹果芯片的Metal、Intel GPU的SYCL,以及更通用的Vulkan——但它的特性矩阵也警告:后端支持和速度并不一致,被支持的GPU不等于就能轻松跑快。
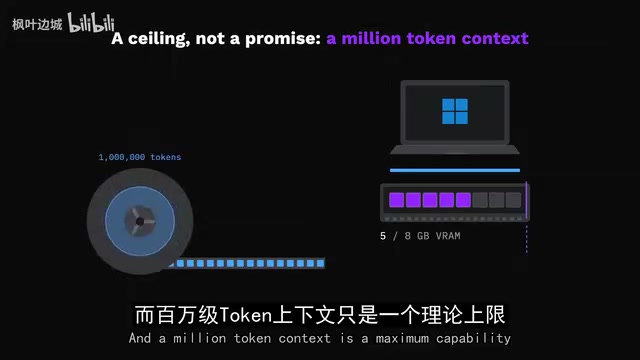
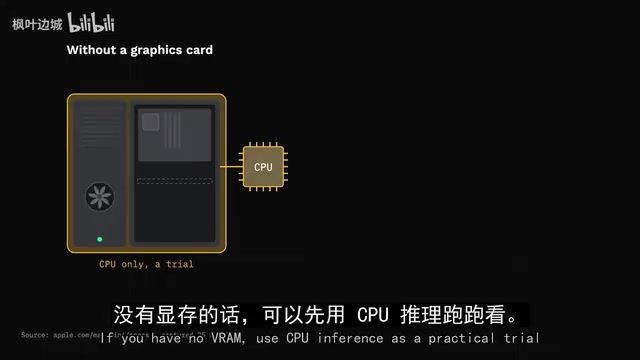
在Mac上,统一内存容量往往比熟悉的显存标签更重要。32GB的苹果芯片系统能加载12GB GPU装不下的模型,但如果模型勉强塞进去,生成速度可能仍慢于跑在快速独立GPU上的小模型。而如果完全没有独立GPU,配16或32GB系统内存的现代CPU也能跑小的量化模型——总结短错误日志、重写函数、学习本地推理如何工作都够用,只是长代码审查和高速agent循环会慢得像等一个加载不出来的网页。
博主的核心结论是:没有唯一的硬件赢家。容量决定什么能装下,带宽决定生成每个下一token的速度快慢。如果模型在GPU和CPU间被拆分,两个内存池之间的连接也成了性能的一部分。
候选模型:Qwen、Gemma、DeepSeek各有取舍
给开票应用一个真实工作负载:先解释Python导入错误并给出修复,再看一张损坏表单的截图,最后审查几个文件并产出一份谨慎的改动。这测试了通用推理、视觉、编码、上下文和工具调用——没有任何单一排行榜能覆盖全部。
Qwen家族提供了最广泛的尺寸阵容,从零点几B到几十B乃至更大变体,支持文本和图像输入,还有紧凑的量化下载。优势是灵活,可以随硬件逐级升档。但博主警告:一个2B模型和一个35B模型在质量、内存和速度上差异巨大,别拿最大模型的benchmark去预测最小模型。
Google的Gemma家族同样是严肃的通用选择,定位于推理、编码、agent工作流和多模态理解,小模型在机器受限或追求低延迟时尤其有意思。DeepSeek广告则打出另一张牌:Flash版主打高效推理并宣传百万token上下文,Pro版是更大的专家混合模型。但博主特别指出一个关键区别——模型出现在本地模型管理器里,不代表列出的标签就能在你电脑上跑;如果标签写着Cloud,推理是托管的,那就不是私密的本地推理。
视觉能力也不能忽视:如果那张损坏表单截图很重要,纯文本模型不会因为应用有个图片按钮就能检查它。要确认具体模型在你打算用的运行时里确实接受图像输入,而图像理解还会增加内存占用和延迟。
MoE(混合专家,Mixture of Experts)架构是理解DeepSeek Pro等模型的关键。传统密集模型的每个token都要经过所有参数计算,MoE模型则将参数分成多个"专家"子网络,每次只激活其中一小部分。这意味着一个标称参数量很大的MoE模型,实际推理时激活的参数量远小于总量,理论上在相同质量下需要更少计算资源。然而,MoE模型需要将所有专家的权重都加载到内存中——总参数量仍决定内存占用,只有计算量减少了。对本地部署而言,这意味着一个671B参数的MoE模型依然需要数百GB内存,消费级硬件只能运行其小型量化版本。
别被跑分骗了:什么才是有意义的benchmark
Benchmark是针对一组定义好的任务的测量。HumanEval或SWE-bench这类编码benchmark测的东西各不相同——一个在短函数问题上表现好的模型,可能仍然搞不定编辑真实仓库、保留既有行为或正确调用工具。博主举例:如果模型拿了高编码分,却没发现导入错误其实来自空白的发票日期,那这个分数根本没回答你的问题。
Token/秒也有两层含义:提示处理(Prompt processing)衡量读取输入的速度,生成速度(Generation speed)衡量写出答案的速度。长提示可能要等很久才出第一个token,即便生成很快。一个每秒80 token的模型未必好过每秒35 token的,如果前者给的是错误修复、要你花10分钟去纠正。
博主给出的方法论清晰实用:用公开benchmark做初筛,然后用相同的提示、模型量化、上下文长度、运行时和硬件来比较入围者。测量首token时间、生成速度、总完成时间,以及答案是否真正解决了你的任务,并且多跑几个例子——单次幸运回答不算benchmark。量化是另一个隐藏变量,4-bit模型更小更快,但答案可能和高精度版本不同,全精度模型的benchmark不能给每个压缩版背书。
运行软件与最终建议
模型只是配置的一半,你还需要东西来下载、运行并提供可用界面。Ollama是Mac、Windows、Linux上直接的起点,提供简单命令行、本地API和庞大模型库,代价是命令行和标签初看会晦涩。LM Studio给你图形化模型浏览器、聊天界面和本地服务器,其系统要求note指出8GB的Mac可能只适合小模型和适中上下文——这是个好提醒:别把应用的最低要求当成舒适体验。Jan则是另一款平易近人的开源风格桌面应用。
对进阶用户,llama.cpp是许多本地方案底层的灵活引擎,支持广泛后端和量化格式,让你掌控上下文、GPU层数和服务器行为,但它对你要求也更多。苹果芯片上基于MLX的工具能很好利用统一内存架构。
博主的最终建议按需求分层:追求速度就优化一个完全驻留在快速内存里的较小模型,首token快速到达会让交互助手感觉响应灵敏得多;追求答案质量就往上加尺寸或用更强的推理模型,同时确保上下文装得下。选型方法是挑三个候选而非三十个——一个小而快的、一个逼近内存上限的通用模型、一个针对主任务的专才,给它们同一个真实提示,记录四件事:是否找到真正原因、多久开始回复、多久出完整答案、是否舒适装下而没把电脑逼进内存压力。
对开票应用的开发者,博主会选一个完全装进机器快速内存的本地通用模型,只有当仓库级编码是主要用途时才加编码专才。归根结底,对那个空白发票日期而言,正确的模型就是那个能找到原因、装得下电脑、且响应快到你愿意一直用下去的模型。8GB显卡用户、Mac用户和无显卡的人都能到达终点——他们只是不该指望同一套配置对三者都最优。
GPU层数卸载(GPU Layer Offloading)是本地推理中一个重要的性能调节手段。当模型太大无法完整装入显存时,运行时可以将模型的部分层加载到GPU、其余层留在系统内存,由CPU处理。Ollama和llama.cpp都支持通过参数指定卸载到GPU的层数。卸载的层越多,GPU加速的比例越高;一旦超出显存容量,超出部分回落到CPU,整体速度取决于两者中较慢的那个,以及GPU与系统内存之间的数据传输带宽。因此,同一个模型在不同层数配置下的速度差异可能相当显著,值得在自己硬件上实际测试几组参数,找到显存刚好装满而不溢出的最优点。
相关推荐

无GPU也能跑大模型?老旧DDR3服务器的本地推理性价比探讨
一场Reddit讨论探讨了无GPU本地部署大模型的可行性:用老旧DDR3多路服务器靠内存带宽跑Qwen 3.8 Flash,以及4bit量化、KV缓存与上下文长度的实用权衡与电费成本争议。

拓扑域外泛化:让AI预测系统从未见过的动力学突变
NeurIPS论文提出拓扑域外泛化方法,通过特征分离与物理稀疏先验修复分层DSR模型缺陷,使AI能在不知控制参数的情况下预测系统分岔与动力学突变,适用于PLRNN和Neural ODE。

用不好AI Agent是你的错吗?破解AI工具焦虑的实用指南
用不好AI Agent是你的能力问题吗?本文从产品成熟度、使用预期和场景匹配三个角度剖析AI工具使用困境,提供破解AI焦虑的实用方法与选型建议。