托管AI的隐私警示:当Claude聊天记录被人工审查并上报警方

Anthropic人工审查团队将用户私聊上报执法部门,引发本地部署社区对托管AI隐私边界的强烈反思。
近期,Anthropic被曝由内部人工审查团队(而非自动化机制)将一名用户与Claude的对话上报给执法部门,该用户将AI当作私人日记使用。这一事件在本地部署LLM社区引发强烈共鸣,成为自托管方案支持者论证其选择合理性的典型案例。文章分析了两类核心风险:知识产权泄露(托管模型可窥探高价值研究输入)和隐私安全风险(私人倾诉可能被人工审阅并上报)。作者同时指出,"我不重要所以没人会看"是一种误区,并呼吁理性区分合规的安全审查机制与隐私侵犯边界。文章的核心结论是:任何经过第三方服务器的内容都不应被视为绝对私密,重视隐私的用户应优先考虑本地开源模型方案。
一则引发本地部署社区热议的事件
近日,Reddit本地大模型(LLM)社区中流传着一则颇具争议的讨论。帖子起因于Anthropic被曝向执法部门上报了一名佛罗里达州女性与Claude的交互内容——这些内容被该用户当作某种"日记"式的私人倾诉,却最终触发了对执法机构的转介。
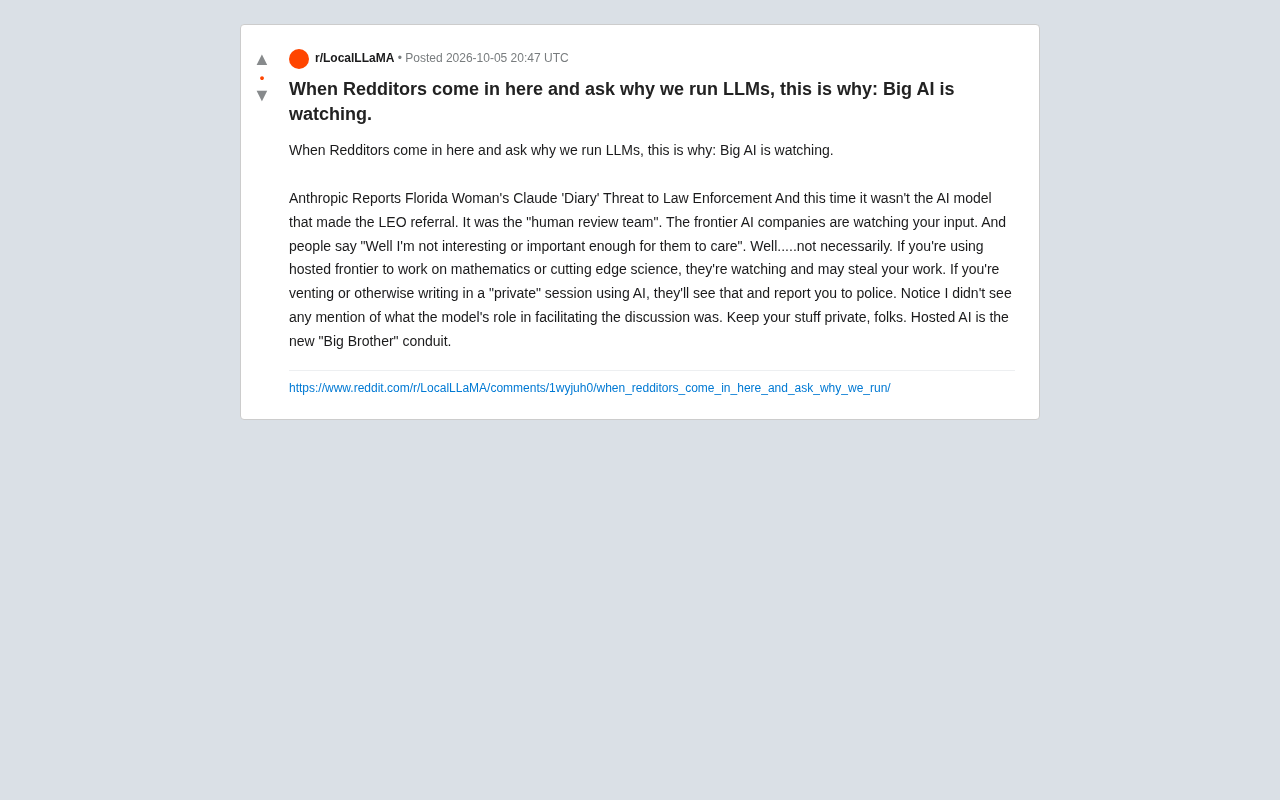
值得关注的一个细节是:这次向执法机构(LEO, Law Enforcement Officer)发出转介的,并非AI模型本身的自动化安全机制,而是公司内部的"人工审查团队"(human review team)。换句话说,有真实的人在查看用户与模型的对话。这一点正是引发社区强烈反应的核心——它直接撕开了很多人对"私人会话"的想象。
为什么本地部署社区如此在意
这篇帖子的标题本身就带有强烈的立场:"当有人问我们为什么要自己跑LLM,这就是原因。"对于长期在本地运行开源模型的用户而言,这类事件恰恰印证了他们选择自托管方案的理由。
帖子作者提出了两个层面的担忧。其一是知识产权风险:如果你使用托管的前沿模型来处理数学难题或前沿科学研究,公司有能力看到这些输入,理论上存在成果被窥探甚至占用的可能。其二是隐私与安全风险:当你把AI当作情绪宣泄或私人书写的工具时,这些内容同样可能被人工团队看到,并在特定情况下被上报给警方。
作者特意指出一个被忽略的问题:在这起事件的报道中,几乎没有人提及模型本身在这场对话中扮演了什么角色——是模型主动引导、放大了相关内容,还是仅仅被动记录?这个空白值得追问。
本地部署(Local Deployment)在这里指将大语言模型的权重文件下载到自己的硬件上运行,整个推理过程在本机完成,数据不经过任何外部服务器。推动这一生态的核心项目包括 Ollama、llama.cpp、LM Studio 等工具,它们大幅降低了在消费级 GPU 甚至 CPU 上运行开源模型(如 Llama、Mistral、Qwen 等)的技术门槛。对研究人员、开发者或处理敏感业务数据的企业而言,本地部署意味着完整的数据主权:提示词(prompt)和模型输出均不离开自己的网络边界,也不受服务商服务条款或隐私政策的约束。这正是此次事件在本地部署社区引发强烈共鸣的结构性背景——他们的技术路线选择本身,就是对托管服务数据风险的一种"投票"。
"我又不重要"是一种误区
面对隐私担忧,常见的反驳是:"我没什么特别的,他们不会在意我。"帖子作者直接反驳了这种心态。问题的关键不在于你是否"重要",而在于托管服务的数据流向本身是不透明且不可控的。
无论你是在做尖端研究,还是只是在深夜向AI倾诉,这些数据都经过了第三方的服务器,并可能被人工审阅。这意味着"私人"二字在托管AI的语境下并不成立。作者将托管AI形容为新时代的"老大哥"(Big Brother)通道,强调它正在成为一条潜在的监控管道。
需要理性看待的几点
尽管帖子观点鲜明,但在传播这类信息时也应保持审慎。
首先,主流AI公司通常在服务条款中会说明安全审查机制的存在,针对涉及人身安全、自残或威胁等极端情形触发人工介入,这在行业内有一定普遍性。帖子中提到的事件究竟是常规威胁检测流程,还是异常的隐私侵犯,仍需结合完整的事实背景判断——而原帖本身也承认关键细节(如模型的实际作用)尚不清晰。
其次,"窃取研究成果"这一说法更多是一种风险推演,而非已被证实的行为。它反映的是用户对数据主权的焦虑,而非确凿案例。
不过,这些保留并不削弱帖子的核心提醒:任何经过第三方服务器的内容都不应被当作绝对私密。
主流AI服务商通常会在隐私政策或使用条款中保留"安全审查"(Trust & Safety review)的权利,并将其定性为保护用户免受自我伤害或防止平台被滥用的必要机制。这类机制在互联网平台行业并不新鲜——社交媒体、电子邮件服务商和云存储提供商均有类似实践。关键区别在于:用户与AI的对话往往具有更强的"私人日记"属性,心理预期上更接近私密通讯而非公开平台内容。当用户的主观隐私预期与服务商的实际数据处理方式之间存在落差时,即便服务条款在法律层面合规,也会产生信任危机。因此,评估此类事件时,不仅要看行为是否违规,还要审视行业惯例与用户认知之间的透明度鸿沟是否已被充分弥合。
对普通用户的实际启示
这起讨论给使用AI工具的人提供了几条务实的参考:
- 涉及敏感、机密或高价值的内容,优先考虑本地部署的开源模型,让数据不出本机。
- 不要把托管AI当作完全私密的"日记本"或情绪树洞,默认它可能被审阅。
- 处理前沿研究或商业机密时,评估服务商的数据使用与保留政策。
- 理解人工审查机制的存在——自动化并非唯一的内容触达方式。
本地运行LLM近年来门槛不断降低,开源模型的能力也在快速逼近部分闭源方案,这为重视隐私的用户提供了现实的替代路径。这则Reddit讨论的价值,不在于它给出了多少确凿证据,而在于它再次提醒我们:在便利与隐私之间,用户需要主动做出知情的权衡。
相关推荐

单步99%准确的浏览器Agent,百步后为何只剩36%成功率?
BrowserBase工程师Derek Megan解析浏览器Agent生产化难题:单步99%成功率为何百步后只剩36%。本文拆解成本累积与价值终端实现的核心矛盾,并给出按事务衡量成功、允许重试、工具封装、技能约束关键路径等破局方法。

AI Agent上线一周被回滚:链式衰退如何毁掉自动化
一位开发者分享AI Agent上线一周即回滚的真实复盘:业务成功率链式衰退导致端到端成功率不足60%。本文剖析根因,并给出精简步骤、确定性收敛进代码、增加人工卡点三大优化方案。

AI数字员工系统拆解:Agent工作流真能平替基础岗位吗?
一篇关于AI数字员工系统与Agent自动工作流的深度拆解,分析智能体、数字人、短视频矩阵、智能获客与AI员工等功能的真实能力与风险,帮你理性看待"一键平替岗位"的营销话术。