Vercel AI SDK:用流式响应告别AI聊天转圈等待
Vercel AI SDK 用流式响应和类型化工具调用改善 AI 聊天体验,但需权衡付费网关与频繁破坏性升级。
文章介绍了 Vercel AI SDK 这一 Apache 许可的 TypeScript AI 开发工具包,GitHub 星标超过 27,000。其核心机制是服务端以流的形式持续推送模型回复,浏览器端 React chat hook 即时追加渲染,实现“边生成边显示”,解决用户等待整段回答的糟糕体验。功能分三层:流式聊天快速上手、用 Zod schema 做类型化输出校验、以及由描述、输入 schema 和执行函数组成的工具调用。文章也直白点出三个代价:普通模型名会走付费的 Vercel AI Gateway;一年三个大版本均含破坏性变更;不具备团队级网关能力,后者应转向 LiteLLM。目标用户是给应用添加 AI 功能的 TypeScript 开发者。
用户向你的AI聊天应用提问,屏幕却只有转圈动画——一秒、两秒、十秒,然后整段回答突然弹出。这种体验正在劝退大量用户。视频中提出的解决方案是 Vercel AI SDK:一个开源的 TypeScript 工具包,让模型回复像电话通话一样边说边到,而不是像寄信一样等全部写完才送达。
它到底是什么:Apache 许可的 TypeScript AI 工具包
Vercel AI SDK 的定位很清晰——给 TypeScript 开发者用的 AI 应用开发套件,GitHub 星标已超过 27,000,采用 Apache 许可。它的核心机制分两端:服务端把模型的回复以流的形式持续推送给浏览器;浏览器端的 React chat hook 则负责把每一小段内容即时追加到屏幕上,并且能准确判断回答何时结束。
模型兼容性覆盖 OpenAI、Anthropic、Google 等主流提供商。这意味着开发者不必为每家厂商写一套适配逻辑,切换模型时上层代码基本不用大改。
三个值得关注的功能层级
1. 流式聊天:快速上手的主路径
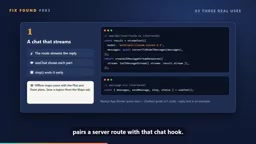
官方 quick start 把服务端路由和 React chat hook 配对使用,这是最典型的接入方式。开发者只需定义一条服务端路由负责调用模型并返回流,前端用 hook 消费流并渲染,就能得到"边生成边显示"的效果。对于已有 Next.js 项目的团队,这条路径的改造成本最低。
流式响应(Streaming) 指的是服务端不等待大模型生成完整回答,而是每产生一个 token 就立即通过 HTTP 分块传输(chunked transfer)或 Server-Sent Events 推送给客户端,前端逐段追加渲染。相比传统“请求-等待-完整返回”,流式响应把首字节时间(TTFB)从数秒降到数百毫秒,显著改善等待感知。AI SDK 在服务端封装了各家提供商的流式接口差异,统一成可读流(ReadableStream),React hook 则负责消费该流、维护消息状态并识别结束标记,开发者无需手写分块解析与拼接逻辑。
2. 类型化数据:不只是文本
AI 应用常见的痛点是模型返回的结构不可控。SDK 的做法是让你用 Zod schema 描述期望的数据结构,当模型输出不符合 schema 时,SDK 直接抛出错误。这把"运行时才发现格式错了"提前到了明确的校验环节,对需要把模型输出接入下游业务逻辑的场景尤其有价值。
Zod 是一个 TypeScript 优先的运行时 schema 校验库,开发者用链式 API 声明对象结构、类型与约束,再通过 z.infer 自动推导出静态类型。它弥补了 TypeScript 类型在编译后被擦除、无法校验运行时数据的短板。在 AI 场景中,模型输出本质上是不可控的字符串,Zod schema 既可作为提示词的一部分约束模型按结构生成,也可在收到结果后执行运行时校验;校验失败即抛错,避免脏数据流入下游。AI SDK 将 Zod 与模型的结构化输出能力(如 JSON mode、工具调用参数)打通,使“声明 schema → 生成 → 校验”成为一条链路。
3. 工具调用:让模型分步解决问题
每个工具由三部分组成:一段描述、一个输入 schema、一个执行函数。模型可以按步骤调用这些工具,直到得出最终答案。这是构建 agent 类应用的基础能力,也是当前 AI 应用从"聊天"走向"干活"的关键一环。
工具调用(Tool Calling / Function Calling) 是大模型的一项协议能力:开发者向模型提供一组工具的名称、自然语言描述和参数 schema,模型在推理时若判断需要外部能力,会返回一个结构化的调用请求(工具名 + 参数),由宿主程序实际执行后将结果回传给模型,模型再继续推理,如此循环直至给出最终回答。它让模型突破“只会生成文本”的边界,能查询数据库、调用 API、执行计算。AI SDK 把这一多轮循环抽象为统一接口,屏蔽了不同提供商在消息格式与调用协议上的差异,开发者只需定义工具三要素,循环调度由 SDK 处理。
需要提前知道的三个代价
视频在这里没有回避问题,反而把坑讲得很直白。
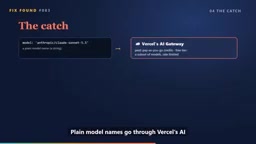
第一,模型调用不是免费的。 如果直接使用普通模型名称,请求会走 Vercel 的 AI Gateway——这是一项付费服务,只有有限的免费额度。想绕过也很简单:改用提供商自己的包和密钥,直接对接 OpenAI 或 Anthropic。库本身开源免费,但 token 费用该付还得付,区别只在付给网关还是付给提供商。
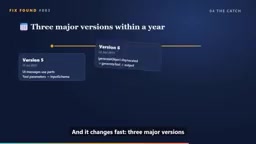
第二,版本变化快。 一年之内发布了三个大版本,每个版本都带破坏性变更。这对追求稳定的生产项目是实实在在的维护负担,锁定版本、关注迁移指南是必要的功课。
第三,它不是团队级网关。 如果你需要的是统一的网关、按团队分配密钥和预算,视频明确建议转向 LiteLLM,而不是用这个 SDK 硬凑。
谁该用,谁该绕道
目标用户是"给自己的应用加 AI 功能的 TypeScript 开发者",无论应用是否部署在 Vercel 上。判断标准其实很简单:如果你正在为 AI 聊天的等待体验发愁,或者需要类型安全的模型输出与工具调用,这个 SDK 值得一试——按文档的 Next.js quick start 走一遍,装包、配上网关或提供商密钥、启动开发服务器即可。
反过来,如果你要的是多团队共享的密钥与预算管理,或者无法承受频繁的破坏性升级,那么它可能不是最优解。视频末尾把问题抛给了观众:下一个该修什么问题?这种开放姿态本身也说明,这个工具仍在快速演进中。
背景补充
LiteLLM 是一个开源的 LLM 网关/代理层,位于应用与各家模型提供商之间,对外暴露统一的 OpenAI 兼容接口,对内负责密钥管理、按团队或用户的配额与预算控制、速率限制、失败重试、成本追踪与日志审计。它与 AI SDK 的定位互补而非竞争:AI SDK 解决的是应用侧的流式渲染、类型化输出与工具调用编排;LiteLLM 解决的是组织侧的统一接入与治理。当需求从“单个应用接入模型”升级为“多团队共享模型资源并核算成本”时,网关层才是正确的抽象层级。
相关推荐

64G内存笔记本跑大模型,实际可用仅46.7G
华硕ProArt创16实测:64G内存标称值下模型可用仅46.7G,128G版官方上限1200亿参数。本文拆解9000元内存差价、统一内存占用真相、续航表现,并给出三步自查方法,帮你判断本地跑大模型该买多大内存。
Ollama零基础教程:本地部署大模型入门指南
Ollama零基础入门教程:了解Ollama是什么、核心特点与本地部署大模型的价值。涵盖开源免费、跨平台、CPU/GPU调度、API集成等关键信息,助你快速上手本地大模型管理工具。

LangGraph 实战:开发者真实工作流与技术栈剖析
从 Reddit 开发者提问切入,剖析 LangGraph 在实际生产中的工作流设计、技术栈组合、图结构模式与调试痛点,总结从教程走向落地的关键实践与可观测性需求。