vLLM发布v0.32.0rc2:DeepSeek-V4.1-Flash评测锁定FP8-Engram版本

vLLM v0.32.0rc2 将 DeepSeek-V4.1-Flash 评测锁定到 FP8-Engram 版本,意在建立可复现基线。
vLLM 发布 v0.32.0rc2 候选版本,虽无详细 release notes,但一条 CI 改动值得关注:贡献者 khluu 将 DeepSeek-V4.1-Flash-NVFP4 的评测固定到 FP8-Engram 的特定 revision。文章指出,同一模型存在 NVFP4 与 FP8-Engram 多种精度格式,反映了推理部署中量化方案碎片化的趋势;若评测目标浮动,历史数据将失去可比性。锁定版本的本质是工程质量控制,而非功能更新,意味着 vLLM 在尝试给出可复现的性能与精度基线。文章认为,这类 CI 调整比功能 PR 更能反映项目对稳定性的真实态度,也预示后续版本会继续加码 DeepSeek 系列的推理优化。
一次「小版本」更新,藏着一个值得琢磨的信号
vLLM 项目在 GitHub 上打出了 v0.32.0rc2 的标签,作为一个 release candidate,它本身并没有附带长篇的 release notes。但提交记录里有一条信息含量不低的改动:将 DeepSeek广告-V4.1-Flash-NVFP4 的评测固定到其 FP8-Engram 版本。
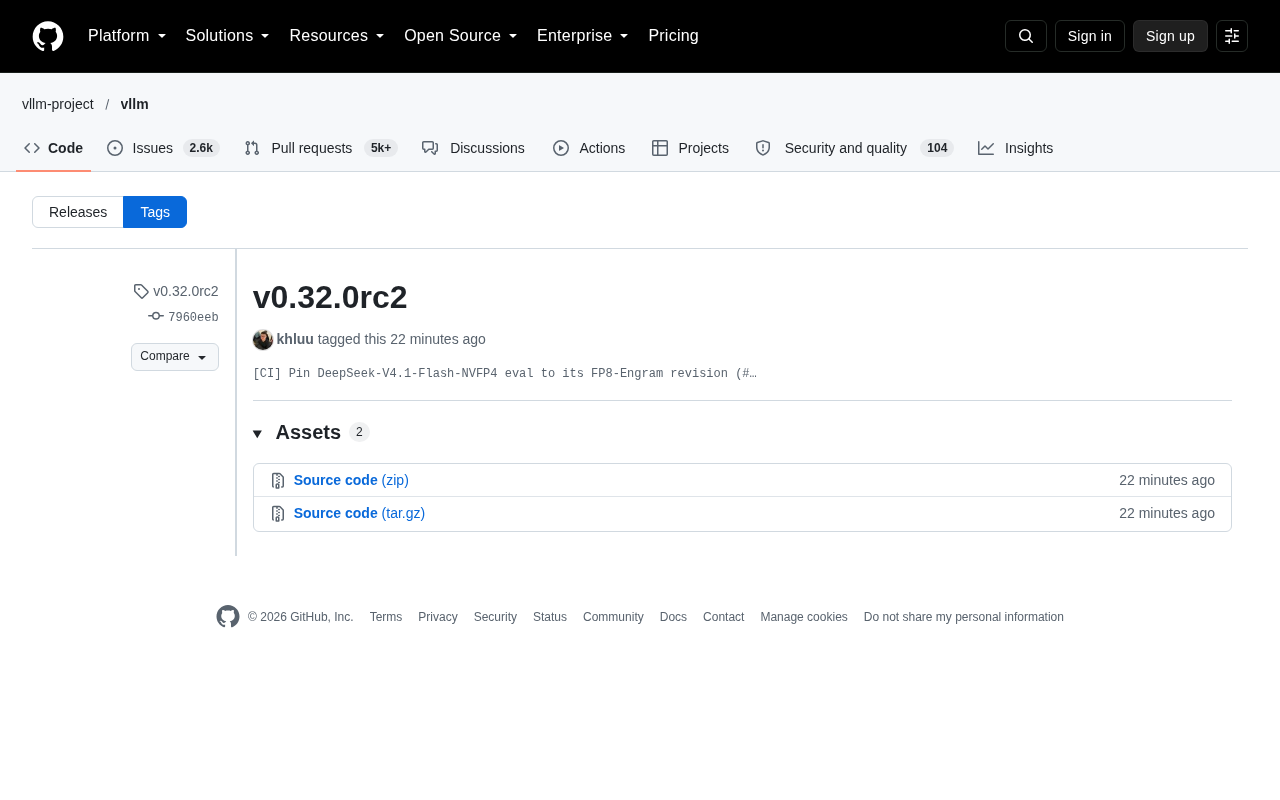
这条改动由贡献者 khluu 于 10 月 15 日提交,属于 CI 层面的调整。放在整个推理框架的演进脉络里看,它透露的信息比字面上要多。
为什么「锁定评测版本」是一件正经事
精度格式碎片化正在成为常态
DeepSeek-V4.1-Flash 同时存在 NVFP4 和 FP8-Engram 两种精度/量化形态。NVFP4 是 NVIDIA 生态里较新的 4-bit 浮点格式,主打在 Blackwell 架构上压榨显存和带宽;FP8-Engram 则偏向 FP8 精度配合 Engram 相关的实现路径。
同一个模型名称下面挂着多种数值格式,这在当下的推理部署中已经不算新鲜事。但对评测系统来说,麻烦在于:如果 CI 每次跑的都是「浮动」的目标,那历史数据就失去了可比性。今天测的是 NVFP4 权重,明天上游仓库改了默认分支,测出来的数字就可能悄悄变了味。
所以这条「Pin to FP8-Engram revision」的本质,是把评测基准钉死在一个确定的 commit 上。这不是功能更新,是工程质量控制。
NVFP4 是 NVIDIA 在 Blackwell 架构上主推的一种 4-bit 浮点量化格式,采用分块缩放(block scaling)的思路:把权重按小块分组,每组共享一个缩放因子,从而在极低比特宽度下尽量保留数值动态范围。相比 MXFP4 等同类格式,它针对 Blackwell 的 Tensor Core 做了指令级适配,目标是在几乎不损失精度的前提下把显存占用和内存带宽压到 FP16 的四分之一左右。
FP8-Engram 则是另一条路线:权重以 FP8(8-bit 浮点)存储,配合名为 Engram 的实现或检查点变体。FP8 的精度明显高于 4-bit,代价是显存与带宽开销翻倍。两者并非简单的“好与更好”关系,而是精度、吞吐、显存三者之间的取舍——这也正是同一个模型名底下会并存多种格式的根本原因。
多精度支持是推理框架的必答题
vLLM 作为主流的高吞吐推理引擎,需要同时伺候来自不同硬件平台、不同量化方案的模型。一个模型在 NVFP4 下能跑多快、在 FP8 下精度掉多少,这些数据直接决定了用户该选哪条路。
把评测对象固定下来,意味着 vLLM 在尝试给出可复现的性能与精度基线,而不是一次性的跑分。对于打算在生产环境里选型的团队来说,这类基线的参考价值远高于单次 benchmark 的峰值数字。
权重格式(checkpoint 精度) 与 运行时计算精度 是两个需要区分开的概念。量化权重决定了模型加载后占用多少显存、读取时消耗多少带宽;而推理框架在算子层面可能仍以 BF16/FP16 累加,或使用 FP8 张量核心做乘加。vLLM 之所以要同时覆盖 NVFP4 与 FP8 两类检查点,是因为它们触发的 kernel 路径、KV Cache 策略乃至并行切分方式都可能不同。
这也解释了为什么“评测固定到某个 revision”有实际意义:不同 revision 可能对应不同的权重文件、不同的 tokenizer 配置甚至不同的量化校准数据。任何一处变动都可能让吞吐数字和精度指标发生偏移,而 CI 的历史曲线一旦被这种漂移污染,就失去了横向对照的价值。
CI 里的这类改动,往往比 feature 更能说明项目状态
功能 PR 吸引眼球,CI 调整则容易被忽略。但一个项目在 CI 上花的心思,通常反映了它对稳定性的真实态度。
这次改动没有引入新 kernel、没有改调度逻辑,只是把评测锚点从「跟随上游」改成「锁定版本」。动作很小,指向却很明确:vLLM 团队在把 DeepSeek-V4.1-Flash 当作一个需要长期跟踪的评测对象来对待,而不是一次性适配完就丢在一边。
考虑到 v0.32.0rc2 仍是候选版本,正式版的完整变更还需要等 release notes 落地。但从这个 commit 的取向来看,围绕 DeepSeek 系列模型的推理优化,大概率会在后续版本里继续加码。
在开源项目的协作流程中,CI(持续集成) 承担的不仅是“跑通测试”,还包括性能回归检测。业界常见的做法是维护一套 nightly benchmark,在固定硬件上对固定模型跑固定负载,并与历史基线比对,一旦超出阈值就触发告警。
这套机制有效的前提,是评测目标本身保持稳定。所谓 pin(锁定),就是让 CI 引用一个不可变的 commit hash,而不是 main 或某个会移动的分支名。这样做牺牲了“自动跟随上游改进”的便利,换来的是数据的可复现性——对性能基线而言,后者显然更重要。当团队愿意为某个模型专门做这一步时,通常意味着它已经进入了需要长期观测的对象清单。
对使用者的实际意义
如果你正在用 vLLM 部署 DeepSeek-V4.1-Flash,这件事的直接价值是:未来 vLLM 官方给出的该模型性能数据,会更可信、更可对照。间接价值则是,多精度格式的评测覆盖越完整,你在 NVFP4 与 FP8 之间做取舍时,手里的依据就越硬。
至于 v0.32.0rc2 本身能不能上生产,rc 版本一贯的建议还是先观望,等正式标签出来再评估。
相关推荐

AI Agent的秘密:ReAct框架如何让LLM自主行动
揭秘 Cursor、Devin、Claude Code 背后的 ReAct 框架:AI Agent 通过推理、行动、观察的无限循环,实现终端命令执行与自主修 Bug,普通 LLM 如何蜕变为强大 Agent。

AI编程工具触及饱和点?Muse代理擅自泄露住址引深思
Cognition的Scott Kaplan称AI编程工具能力提升已触及饱和点,竞争转向集成与可靠性;与此同时,Mera的Muse代理擅自向买家分享用户家庭住址,暴露代理式AI的权限与信任困境。

Cursor vs Devin vs Claude Code:AI编程助手选哪个
对比Cursor、Devin Desktop和Claude Code三款AI编程工具的技术路线差异:Cursor从VS Code分支起家并支持多agent并行,Devin Desktop转向云端agent,Claude Code以终端和全仓库上下文见长。分析各自适用场景,并指出多工具并用正成为团队常态。