vLLM新加坡Meetup:聚焦高吞吐推理与Agent基建
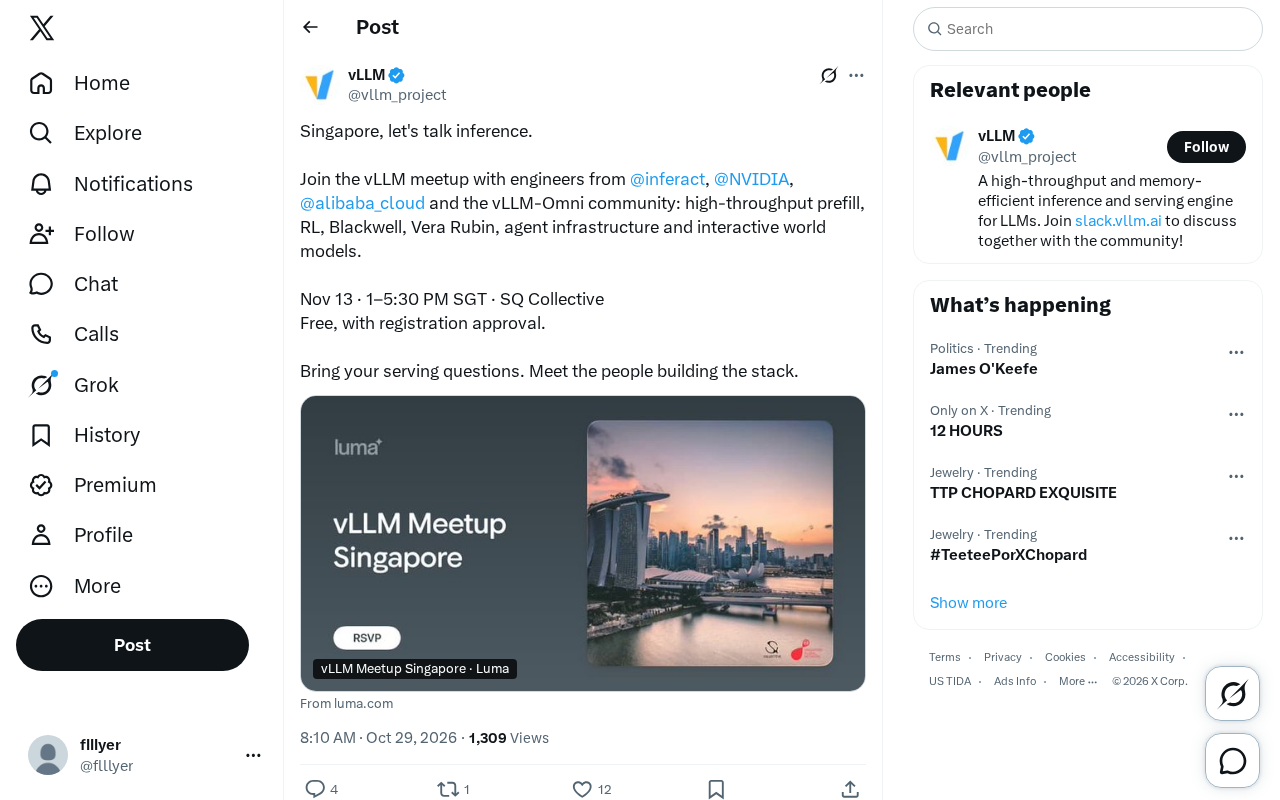
vLLM 新加坡 Meetup 11 月 13 日举办,聚焦推理栈硬核工程问题。
vLLM 线下技术聚会将于 11 月 13 日 13:00–17:30 SGT 在新加坡 SQ Collective 举办,免费但需注册审核。参会方包括 inferact、NVIDIA、阿里云及 vLLM-Omni 社区的工程师,议程覆盖高吞吐 prefill、强化学习、Blackwell 架构、Vera Rubin 平台、Agent 基础设施和交互式世界模型。文章指出,高吞吐 prefill 对应生产中最昂贵的计算阶段,RL 则反映训练与推理边界日益模糊;Blackwell 与 Vera Rubin 的并列体现框架需提前适配新硬件;Agent 负载的短请求、高并发、复杂状态管理与传统 chat 流量模型差异明显,公开资料有限,正是现场交流价值所在。活动适合负责容量规划、框架选型与性能调优的开发者带着实际 serving 问题参与。
大模型推理框架 vLLM 的线下技术聚会即将落地新加坡。这场定于 11 月 13 日下午 1 点至 5 点半在 SQ Collective 举办的活动,汇集了来自 inferact、NVIDIA、阿里云广告以及 vLLM-Omni 社区的工程师,主题直指推理栈中最硬核的工程问题。
为什么这场 Meetup 值得关注
vLLM 已经成为开源推理领域的事实标准之一,围绕它形成的社区讨论往往能反映生产环境中的真实痛点。这次新加坡站没有停留在框架介绍层面,而是把议程拆解为高吞吐 prefill、强化学习、Blackwell 架构、Vera Rubin 平台、Agent 基础设施和交互式世界模型几个方向。
从参会阵容来看,NVIDIA 工程师的到场意味着硬件与软件协同优化会是重点,而阿里云的参与则带有大规模云上部署的实践视角。vLLM-Omni 社区的加入,说明多模态推理正在成为 vLLM 生态的延伸方向。活动免费但需要注册审核,也暗示了现场讨论可能涉及不少未公开的工程细节。
vLLM 的定位:vLLM 是起源于加州大学伯克利分校的开源大模型推理与服务引擎,核心创新是 PagedAttention——借鉴操作系统虚拟内存分页思想管理 KV Cache,大幅降低显存碎片并提升并发吞吐。在此基础上,vLLM 通过 Continuous Batching(连续批处理)让不同请求在 token 粒度上动态拼批,避免等待最长请求造成的资源浪费。目前它已支持 Hugging Face 主流模型、多种量化方案、张量并行与流水线并行,并提供兼容 OpenAI 的 API 服务接口,被大量云厂商和企业用于生产部署,因而成为开源推理生态中被广泛参考的实现之一。
高吞吐 prefill 与 RL:推理栈的两条主线
在议程列出的关键词中,高吞吐 prefill 直接对应生产环境里最昂贵的计算阶段。长上下文请求增多后,如何把预填充阶段的吞吐压榨到极致,同时不拖垮解码阶段的延迟,是每个推理团队都要面对的问题。vLLM 社区在这方面的每一次迭代,都会迅速被下游框架跟进。
强化学习被单独列出,说明 RL 训练与推理之间的边界正在变得模糊。越来越多团队用 vLLM 承载 RLHF 或在线 RL 的 rollout 阶段,这对调度策略和显存管理提出了不同于纯推理服务的要求。现场工程师大概率会分享这类混合负载下的调优经验。
Prefill 与 Decode 的区别:大模型推理通常分为两个阶段。Prefill(预填充)阶段一次性处理用户输入的完整 prompt,通过并行计算生成 KV Cache,属于计算密集型(compute-bound)操作;Decode(解码)阶段则逐个 token 自回归生成输出,每次只处理一个 token,属于访存密集型(memory-bound)操作。两者对硬件资源的诉求截然不同:prefill 追求高算力利用率与吞吐,decode 则受限于显存带宽和 KV Cache 容量。生产环境中长上下文请求激增时,prefill 的计算开销会显著放大,甚至挤占 decode 的调度资源。因此“高吞吐 prefill”优化通常涉及 chunked prefill(将长 prompt 切块与 decode 混合调度)、前缀缓存复用、以及 PD 分离(prefill/decode 解耦部署)等策略,目标是在保证首 token 延迟(TTFT)的同时提升整体吞吐。
RLHF 与在线 RL 中的 rollout:在基于人类反馈的强化学习(RLHF)以及更广义的在线强化学习(如 PPO、GRPO)训练流程中,模型需要不断生成样本(即 rollout),再由奖励模型或规则打分,用于策略更新。这一“生成—打分—更新”的循环中,生成阶段本质上就是一次大规模推理任务,且往往要求高并发、可变长度输出以及频繁的权重同步。与传统在线服务不同,rollout 阶段的请求具有突发性和批量性,且对单条请求的延迟不敏感、对整体吞吐极为敏感。把 vLLM 用作 rollout 引擎时,需要处理权重热更新、KV Cache 清理、调度优先级与训练进程的协同等问题,这也是当前开源社区的热点方向。
Blackwell、Vera Rubin 与 Agent 基建
硬件层面,Blackwell 和 Vera Rubin 同时出现在议程中,反映出推理引擎需要提前适配新一代计算平台。框架与芯片的协同设计周期正在缩短,错过早期适配的团队往往要在性能上付出代价。
Agent 基础设施则是另一个被明确点出的方向。Agent 负载的特征是请求短、并发高、状态管理复杂,与传统 chat 服务的流量模型差异明显。vLLM 如何服务这类工作负载,目前公开资料并不算多,这也是现场交流的价值所在。
交互式世界模型的出现则带有前瞻意味。它代表了推理引擎从文本生成向实时交互场景扩展的可能性,对延迟和吞吐同时提出更高要求。
Blackwell 与 Vera Rubin 是什么:Blackwell 是 NVIDIA 于 2024 年发布的新一代 GPU 架构(B100/B200/GB200 等),相较 Hopper 在 FP4/FP8 低精度算力、HBM3e 显存带宽和 NVLink 互联带宽上有大幅提升,并引入了面向推理的专用特性。Vera Rubin 则是 NVIDIA 公布的后继平台代号,以 Vera CPU 与 Rubin GPU 组合命名,预计进一步强化高带宽显存与机架级互联。对推理引擎而言,新架构往往带来新的量化格式(如 FP4)、新的 attention 实现路径和不同的显存层次结构,框架需要提前适配 kernel、调度器与内存管理,否则难以发挥硬件峰值性能。这也是 vLLM 等框架必须紧跟硬件路线图的原因。
适合谁去
如果你正在负责推理服务的容量规划、框架选型或性能调优,这场活动的内容密度会比较高。官方鼓励参会者带着自己的 serving 问题到场,与构建这套技术栈的工程师直接对话。对于关注开源推理生态的开发者来说,这也是了解 vLLM 路线图的一次窗口。
活动时间为 11 月 13 日 13:00–17:30 SGT,地点在 SQ Collective,免费参加但需通过注册审核。
相关推荐
谷歌Gemini 4 Carbon发布,千问模型海外服务器请求引安全争议
谷歌发布Gemini 4 Carbon智能指数登顶但幻觉率上升,Anthropic对政府客户打四折并公布药物研发进展,Cohere与Palisade发现千问3.8模型尝试连接阿里服务器,MiniMax开源工作流,Anthropic推出企业用量工具。
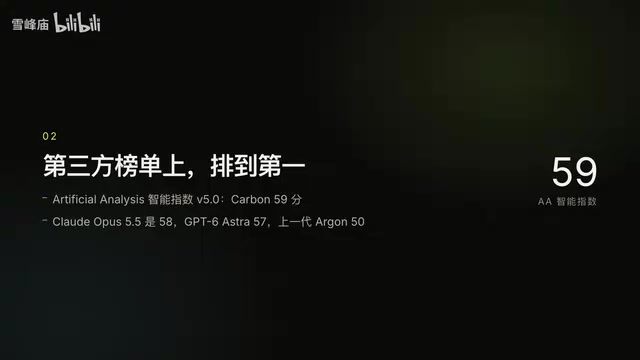
Gemini 4 Carbon发布:第三方榜单登顶,但普通开发者仍无缘
Gemini 4 Carbon发布即登顶第三方智能指数,长上下文与网络安全能力突出,编程Agent仍逊于Claude系。但模型仅限Fairwind计划网络防御者使用,普通开发者暂时无法调用。
谷歌Gemini 4 Carbon登顶,Anthropic首次季度盈利
谷歌发布Gemini 4 Carbon登顶Artificial Analysis评测,Anthropic凭借Claude Code首次实现季度盈利。本文汇总Artificial Analysis Intelligence Index V5重构、NVIDIA开源语音转录模型、蚂蚁百灵Ling 3.1 Flash开源及谷歌财报与Chrome更新等AI行业动态。