微软BitNet:1-bit LLM官方推理框架,CPU也能跑大模型

微软开源 BitNet 推理框架,让 1-bit 大模型在普通 CPU 上高效运行。
BitNet 是微软官方开源的 1-bit 大语言模型推理框架,GitHub 星数已超 4 万。它用 C++ 编写,专注于模型训练完成后的高效推理,而非训练本身。1-bit 量化把权重压缩到 FP16 的约 1/16,从根本上改变推理的内存占用和计算模式,使大模型得以在无 GPU 的普通笔记本和边缘设备上运行。文章分析了 BitNet 在内存、能耗和 CPU 可移植性上的优势,指出它对开发者、研究者和硬件工程师各有价值,并从社区热度看出低成本大模型推理正成为与模型能力同等重要的议题。
什么是 BitNet?
BitNet 是微软开源的官方推理框架,专门为 1-bit 大语言模型(1-bit LLMs)设计。在 GitHub 上,这个项目已经斩获 40728 颗 Star 和 3796 次 Fork,单日新增 195 颗 Star,热度持续攀升。
传统大模型通常以 FP16 或 INT8 精度运行,而 1-bit LLM 将模型权重压缩到极致的二值化表示(-1 或 1),从根本上改变了推理的计算模式和内存占用。BitNet 作为官方推理框架,用 C++ 编写,目标就是让这类极端量化模型在各种硬件上高效运行——包括没有 GPU 的普通 CPU。
1-bit 量化(二值化)的技术含义:传统的模型量化通常指把 FP32 或 FP16 权重压缩为 INT8(8 位整数),压缩比约为原始精度的 4 倍,精度损失相对可控。1-bit 量化则走得更极端——每个权重只保留两种取值(通常表示为 -1 和 +1),单个参数仅占 1 个比特。这样一来,权重存储体积理论上只有 FP16 的 1/16、INT8 的 1/8。
但二值化带来的真正变化不只是省内存。当权重只能取 ±1 时,矩阵乘法可以退化为加法与符号翻转的组合,避免了大部分浮点乘运算,这对 CPU 这类擅长整数运算、缺乏大规模并行浮点单元的硬件尤其友好。代价是模型表达力受限,因此 1-bit LLM 通常需要在训练阶段就采用量化感知的方式(例如微软此前提出的 BitNet 架构与 BitLinear 层),而不是在训练完成后简单地对权重做“四舍五入”。
为什么 1-bit 推理值得关注
内存与能耗的双重突破
大模型部署的最大瓶颈往往不是算力,而是内存带宽和显存容量。1-bit 量化将权重体积压缩到 FP16 的约 1/16,这意味着同样的内存可以容纳更大的模型,或者在同等模型规模下大幅降低硬件门槛。
对于边缘设备和本地部署场景,这种压缩比带来的收益非常直接:不需要高端显卡,一台普通笔记本就能加载并运行原本需要服务器级别硬件才能承载的模型。
CPU 推理的可行性
BitNet 用 C++ 实现,天然适合在 CPU 上执行。它避开了对 CUDA 或特定加速器的强依赖,让推理框架的可移植性大幅提升。对于希望在本地跑模型、又不想投入 GPU 成本的开发者和研究者来说,这是一个务实的选择。
为什么推理对内存带宽如此敏感:大模型的推理过程可以分为两个阶段——预填充(prefill)和逐 token 解码(decode)。在逐 token 解码阶段,每生成一个词都需要把模型的全部权重从内存读入计算单元一次,而计算量本身很小。这就使解码阶段成为典型的“内存带宽受限”(memory-bound)任务:瓶颈不在算力,而在权重搬运速度。
因此,把权重从 FP16 压缩到 1-bit,等于直接减少了每次解码需要搬运的数据量,推理速度可能提升数倍。对 GPU 而言,这意味着显存压力下降;对 CPU 而言,则意味着原本因带宽不足而无法在本地流畅运行的模型变得可行。这也解释了为什么 1-bit 量化在端侧和边缘场景中格外有吸引力。
BitNet 框架的技术定位
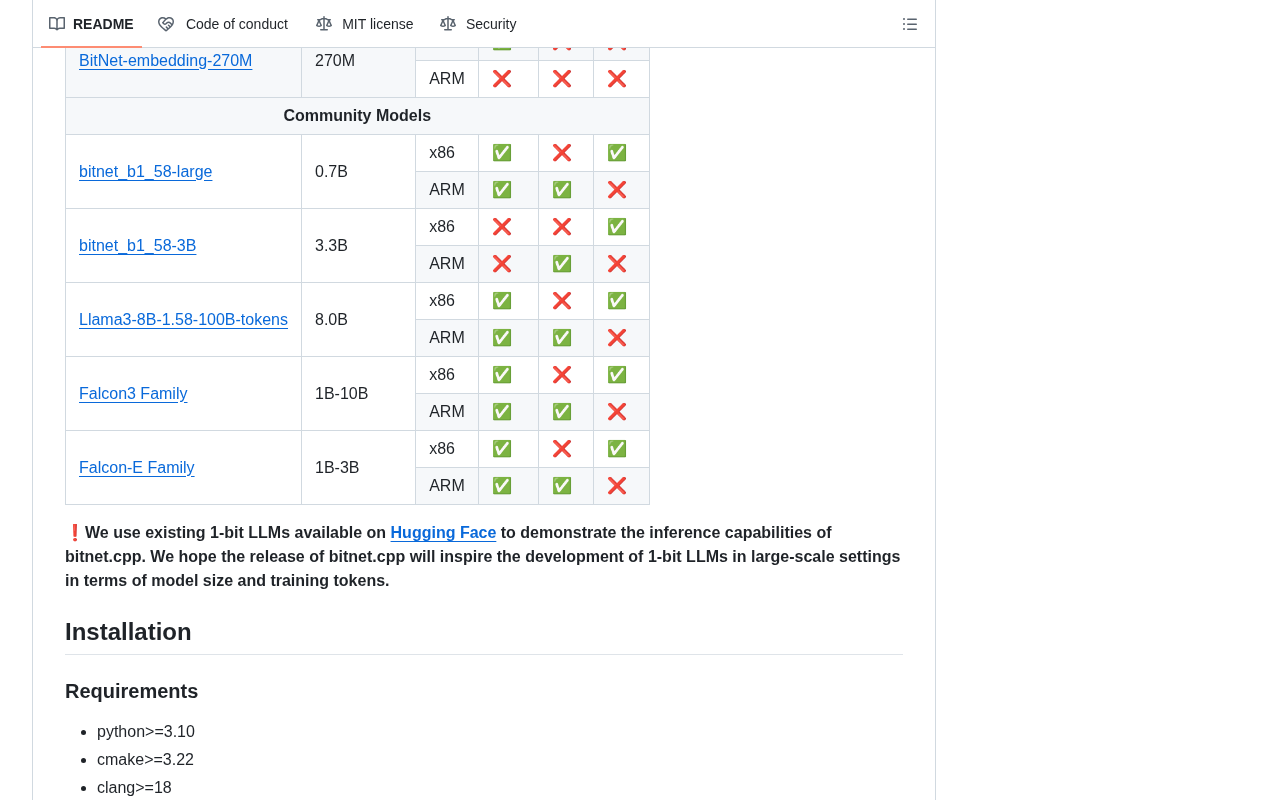
从仓库信息来看,BitNet 的定位是“官方推理框架”,而非训练框架。核心关键词是 inference——它解决的是模型训练完成之后,如何高效地把 1-bit LLM 跑起来的问题。
C++ 作为实现语言,说明项目对性能和底层控制有明确追求。相比 Python 推理栈,C++ 版本在启动速度、内存占用和跨平台部署上都有先天优势。
推理框架与训练框架的分工:在 AI 工程中,训练框架(如 PyTorch、TensorFlow)负责通过反向传播调整模型参数,对算力、显存和数值精度要求极高;推理框架则专注把已经训练好的模型高效执行,优化重点在于低延迟、低内存占用和跨平台部署。
BitNet 明确站在推理一侧,意味着它不负责训练 1-bit 模型,而是为已有的 1-bit 权重提供高效的执行引擎。这种定位与 llama.cpp、vLLM 等项目类似,只是它专门服务于 1-bit 这一极端量化场景。因此,使用者的典型路径是:先用支持 1-bit 训练的方法得到模型权重,再交给 BitNet 在目标硬件上运行,而不是指望它把普通模型“压缩”成 1-bit。
开发者能从中得到什么
对于 AI 应用开发者,BitNet 提供了一个探索极低精度推理的入口。你可以用它来验证 1-bit 模型在实际任务中的表现,评估量化对输出质量的影响,以及测试不同硬件平台上的推理效率。
对于研究者,这个框架是研究 1-bit LLM 推理特性的实验平台。它把底层实现开放出来,方便分析二值化权重在真实推理管线中的行为。
对于硬件和系统工程师,BitNet 展示了在资源受限环境下运行大模型的可能性,这对边缘计算和端侧 AI 有直接的参考价值。
社区热度说明了什么
40728 颗 Star 是一个相当可观的数字。它反映出开发者社区对“低成本跑大模型”这件事的强烈需求。在模型规模不断膨胀的同时,如何让推理变得轻量、可及,正在成为和模型能力同等重要的议题。
BitNet 的流行也说明,1-bit LLM 不再只是论文里的概念,而是有了官方工程实现和活跃的社区关注。对于关注模型压缩、高效推理和端侧部署的人来说,这是一个值得持续跟踪的项目。
相关推荐

3分钟看懂DeepSeek:从量化私募到开源AI领跑者的崛起之路
3分钟看懂DeepSeek发展史:从幻方量化的算力积累,到V2的MLA推理降本、V3的557.6万美元训练账单、R1开源引爆全球,再到V4与70亿美元A轮融资,梳理深度求索的关键节点与技术路线。

本地文学创作模型PK:Qwen3.8 27B微调版胜出,DeepSeek v4.1表现平淡
B站UP主横向测评七款本地文学创作模型:海明威、HumanLike Chat基于Qwen3.8 27B微调表现最佳,DeepSeek v4.1叙事平淡,东方朔角色混乱垫底。附三道测试题评分与使用建议。

梁文锋的三次豪赌:DeepSeek为何将82%毛利开源?
DeepSeek为何把82%毛利的推理框架DeepInfer开源,又启动千亿融资?从技术路线、国产芯片到组织纯粹性,解析梁文锋的三次豪赌与开源战略背后的商业与理想逻辑。