微软Outlook/365宕机超12小时:云依赖的脆弱性再引热议
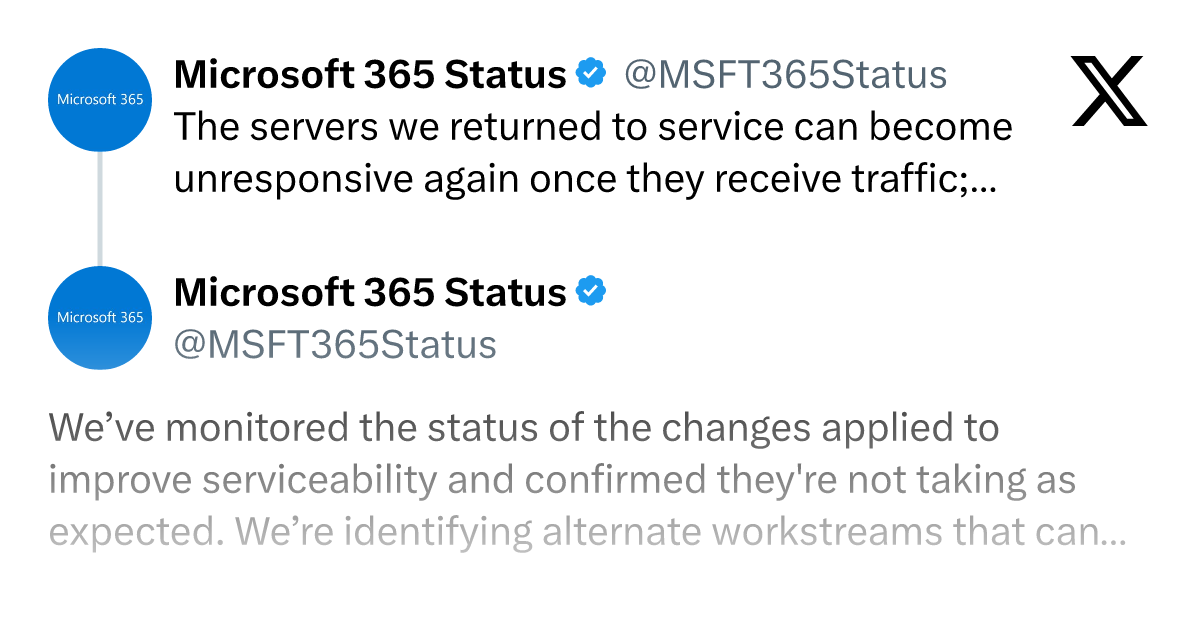
Microsoft 365与Outlook中断超12小时,引发云集中化风险讨论。
微软Microsoft 365和Outlook服务中断超过12小时仍未完全恢复,官方通过MSFT365Status账号持续发布进展,但完整恢复时间线尚不明确。Hacker News讨论帖获得316点热度和222条评论,关注度显著。技术社区讨论的焦点并非仅是恢复时间,而是云服务集中化带来的单点依赖风险:当邮件、日历、文档协作全部托管在少数超大规模云厂商手中,一次故障波及面广且缺乏本地降级方案。长时间宕机对企业核心工作流造成会议改期、审批延迟等连锁影响。事件提醒技术团队需将“供应商长时间不可用”作为必演练场景,准备替代渠道与降级方案,同时云厂商的状态沟通透明度与修复及时性同样影响用户信任。
微软Microsoft 365和Outlook服务在中断超过12小时后仍未完全恢复,这一事件在Hacker News上引发了316点热度、222条评论的广泛讨论。当办公协作高度依赖云端,一次长时间宕机带来的连锁反应,远比一条状态更新复杂得多。
宕机事件概述与官方回应
据微软官方账号MSFT365Status在X平台发布的状态更新,Microsoft 365与Outlook服务出现中断,且问题在约12小时后依然存在。用户在高频使用的邮件与办公套件上遭遇访问异常,影响范围涉及依赖Outlook进行日常沟通和调度的企业及个人用户。
官方通过社交媒体持续发布进展,但截至相关讨论发酵时,服务尚未完全恢复。Hacker News上的讨论帖积累了316点热度和222条评论,说明这一事件在技术社区中获得了相当高的关注度——对于一次云服务中断而言,这个讨论量级反映出用户对长时间宕机的敏感程度。
技术社区的讨论焦点:云集中化的风险
Hacker News评论区的222条讨论,核心并不只是“服务什么时候恢复”,而是对云服务集中化架构的再度质疑。当邮件、日历、文档协作全部托管在少数几家超大规模云厂商手中,一次故障的波及面会覆盖大量组织,且用户几乎没有任何本地降级方案。
这种讨论在每次大型云宕机时都会出现,但此次12小时的时间跨度让“单点依赖”问题更加突出。对于把关键业务流程完全迁移到SaaS的企业来说,宕机期间的可选路径极其有限:等待官方修复,或者临时切换到备用沟通渠道。技术社区中反复出现的观点是,架构设计上应当保留一定的离线或异构备份能力,而不是把可用性完全托付给单一供应商。
单点依赖(Single Point of Dependency) 在云服务语境下,指组织将关键业务能力完全托付给单一供应商或单一服务实例,缺乏冗余路径。不同于传统单点故障(SPOF)多指硬件层面,这里的单点依赖发生在服务层:当Outlook或Microsoft 365不可用时,企业没有本地邮件服务器或异构办公套件可切换,业务连续性直接绑定在供应商的恢复速度上。技术社区常建议的缓解手段包括多云策略、关键数据的本地缓存、以及为认证与通信保留独立于主供应商的备用通道。
长时间宕机对企业协作的实际影响
Outlook和Microsoft 365承载的不只是邮件,还包括日历、会议安排、文档协同等核心工作流。服务中断超过半天,意味着会议改期、审批延迟、跨团队沟通受阻等一系列连锁反应。对于把身份认证和办公套件深度绑定的组织,故障期间甚至可能影响其他依赖同一账号体系的内部系统。
从事件管理的角度看,官方通过社交账号发布状态更新是一种常见做法,但在长时间故障中,用户更关心的是具体的恢复时间窗口和受影响功能清单。Hacker News讨论中体现出的情绪,部分来自信息不确定性带来的焦虑,而不只是服务不可用本身。
SaaS(Software as a Service) 指通过互联网交付、由供应商集中运维的软件模式。Microsoft 365与Outlook是典型的多租户SaaS:全球用户共享同一套后端基础设施与身份体系,因此一次区域性故障可能迅速扩散为跨组织的广泛中断。SaaS的便利在于免运维、自动更新和随处访问,但代价是用户对底层架构、故障修复节奏和数据驻留位置缺乏控制权。当SaaS承载邮件、日历、文档等核心工作流时,其可用性实际上成为企业业务连续性的一部分,这也是长时间宕机比传统软件故障影响更广的结构性原因。
从这次事件中能学到什么
对于技术团队而言,这次宕机提供了一个现实样本:评估关键SaaS依赖时,需要把“供应商长时间不可用”当作一种必须演练的场景。具体做法包括梳理哪些业务在Outlook不可用时完全停摆、准备替代沟通渠道、明确故障期间的信息同步机制。
对于云服务提供商,12小时未完全恢复的中断会直接消耗用户信任。状态沟通的透明度、故障定位的及时性,和最终修复同样重要。技术社区的讨论热度表明,用户对云服务可用性的期待并没有因为云计算的普及而降低,反而在关键业务全面上云后变得更加严苛。
目前服务恢复的完整时间线尚未明确,后续进展值得持续关注。对于依赖Microsoft 365的团队,这次事件是一次提醒:云服务的便利性和集中化风险是一枚硬币的两面。
业务连续性计划(Business Continuity Plan, BCP)与降级方案 是企业应对供应商长时间不可用的核心框架。针对SaaS中断,降级方案通常包括:识别关键业务对特定服务的依赖程度并划分优先级;准备替代沟通渠道(如备用邮件网关、即时通讯工具或电话树);明确故障期间的信息同步与决策机制;定期演练“主供应商不可用”场景。技术社区反复强调,降级方案的价值不在于完全消除中断影响,而在于把恢复时间目标(RTO)从“等待供应商修复”缩短到组织可控的范围内。
相关推荐
Gemini 4 Hydrogen 深度评测:高性价比之外的真实价值
基于 Artificial Analysis 选型数据与实测反馈,拆解 Gemini 4 Hydrogen 的性价比悖论:高分不等于高价值,自动化工作流与代码任务表现分化,定价与 Google 订阅包各算各的账,SynthID 输出标识可能成为一票否决项。
Gemini 4 Hydrogen 五大极限测试:96.7% 准确率与一键建站
YouTube 创作者对 Gemini 4 Hydrogen 进行五项极限测试:单提示词生成游戏、3D 太阳系模拟、30 分钟视频时间戳定位、287 页财报转交互仪表盘,以及抗幻觉测试中 96.7% 的准确率表现。
Gemini 4 Hydrogen发布:速度提升2.5倍的日常AI模型
Google发布Gemini 4 Hydrogen,宣称比Gemini 3.8 Flash快2.5倍,支持四级思考控制、百万token上下文和Orchestrator多模型协作,API定价每百万输入token 1.50美元。