无限参数LLM:从实时数据动态生成与调整模型权重
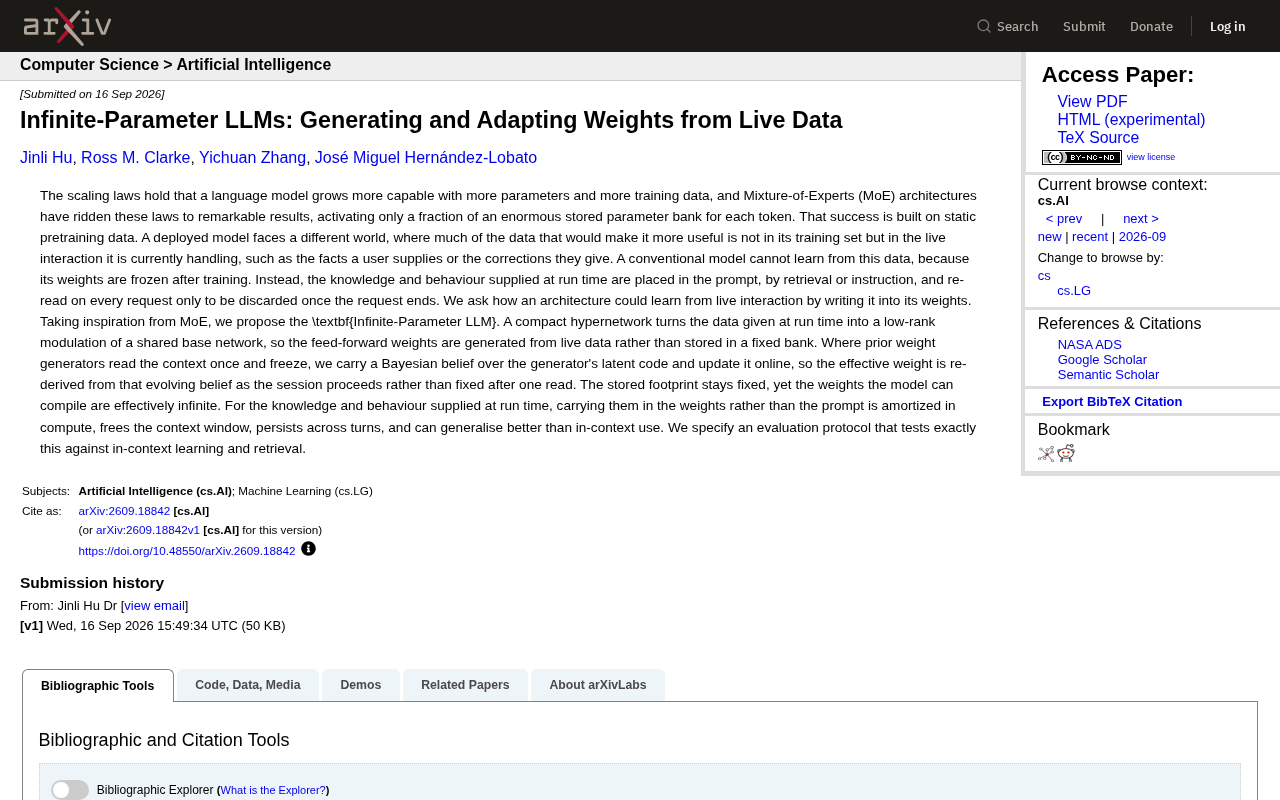
探讨让大语言模型权重从实时数据动态生成而非固定存储的"无限参数"前沿构想及其挑战。
传统大语言模型的参数在训练结束后即被固化,而"无限参数LLM"设想彻底颠覆这一范式:将模型权重视为可由实时数据动态生成的函数输出,而非静态存储的数值矩阵。这一思路是超网络、RAG、LoRA等已有技术的激进延伸,核心价值在于赋予模型持续学习能力、重新分配存储与计算效率,并天然支持个性化与领域适配。然而,动态权重带来的输出稳定性风险、额外推理计算开销,以及持续学习场景下的灾难性遗忘问题,构成了落地的主要障碍。目前该方向仍处于概念探索阶段,"无限参数"的表述带有一定营销色彩,其真正价值或许在于推动业界重新审视"权重究竟应被存储还是被生成"这一基础性问题。
一个大胆的设想:让模型权重不再固定
传统大语言模型(LLM)的参数量在训练完成后就被固定下来。无论是70亿参数还是数千亿参数,模型的"知识"本质上被冻结在权重矩阵中。当我们谈论"无限参数LLM"(Infinite-Parameter LLMs)时,讨论的是一种截然不同的范式:模型权重不再是静态存储的固定数值,而是可以从实时数据中动态生成并持续调整。
这一构想触及了当前深度学习架构的一个根本性约束——参数规模与推理能力、知识存储之间的耦合关系。如果权重能够按需生成,理论上模型就不再受限于训练时确定的固定容量。
什么是"从实时数据生成权重"
这一概念的核心在于将模型权重视为一种"函数输出",而非"存储实体"。换句话说,模型的某些层或全部参数,可以由一个生成机制根据当前输入的上下文、检索到的外部数据或实时信号来产生。
与传统方法的区别
现有的一些技术已经在朝这个方向探索:
- 超网络(Hypernetworks):用一个较小的网络生成另一个网络的权重,这是"权重生成"思想的早期实践。
- 检索增强生成(RAG):通过外部知识库补充模型的静态知识,但并不改变权重本身。
- LoRA 等参数高效微调:在固定主干上叠加可训练的低秩适配层,实现轻量级适应。
"无限参数"的设想比这些方法更激进——它试图让权重生成成为模型运行的常态机制,而非附加模块。当新数据流入时,相关权重可以被实时构造出来,从而突破固定参数量的天花板。
超网络(Hypernetworks) 由 David Ha 等人于2016年正式提出,其核心思想是用一个小型"元网络"输出另一个目标网络的权重,而非直接学习目标网络的参数。这使得同一套元网络参数可以在不同条件下生成差异化的权重配置,本质上是将"参数空间"压缩进一个更紧凑的生成函数中。超网络在连续学习、神经架构搜索和多任务学习等场景中已有实验验证,但受限于生成质量与稳定性,尚未成为主流架构组件。理解超网络是把握"无限参数"概念谱系的重要基础——后者可视为将超网络思想推向极致:不再仅用小网络生成小网络,而是以实时外部数据作为条件信号,持续驱动大规模权重的动态构造。
潜在价值与应用场景
如果这一范式能够落地,其意义是深远的。首要收益是持续学习能力:模型能够在部署后不断吸收新信息,而无需重新训练整个网络。这对于需要处理快速变化领域(如金融、新闻、代码)的应用尤为关键。
其次是存储与计算效率的重新分配。当权重可以按需生成时,模型无需将所有知识都固化在参数中,这可能让轻量级模型在特定任务上展现出远超其"名义参数量"的能力。
此外,这种机制天然契合个性化与领域适配的需求。不同用户、不同场景可以触发不同的权重生成路径,让同一个基础模型呈现出高度定制化的行为。
现实的技术挑战
尽管构想诱人,从设想到工程实现之间横亘着不小的鸿沟。
稳定性问题是首要障碍。动态生成的权重如何保证模型输出的一致性和可靠性?如果每次推理都可能改变有效参数,模型行为的可预测性将大打折扣。
计算开销同样不可忽视。实时生成权重意味着在推理过程中引入额外的计算负担,这与人们追求推理效率的方向存在张力。如何在动态性与速度之间取得平衡,是关键的工程问题。
还有灾难性遗忘的老问题——当模型不断从新数据调整权重时,如何避免丢失已有的核心能力,仍是持续学习领域尚未彻底解决的难题。
理性看待这一方向
补充一点,该话题目前更多停留在概念与探索阶段。原始讨论在技术社区的关注度尚属初期(HackerNews 上仅有少量投票、暂无深入评论),这意味着相关方案的成熟度和可验证性还有待观察。
"无限参数"这样的表述带有一定的营销色彩,实际系统更可能是有限但"可扩展"的权重生成机制,而非字面意义上的无限。对于关注前沿架构的研究者和工程师来说,这一方向值得持续跟踪,但也应以审慎的态度评估其实际落地的可行性与效果。
这类探索的真正价值,或许不在于立刻替代现有架构,而在于推动业界重新思考"参数"这一深度学习的基础概念——权重究竟应该是被存储的,还是被生成的?
背景补充
灾难性遗忘(Catastrophic Forgetting) 是神经网络在持续学习场景下的经典痛点:当网络在新任务上更新参数时,会严重覆盖旧任务所对应的权重分布,导致旧能力急剧退化。这一现象源于神经网络参数的共享性——同一组权重同时承载多项功能,新梯度的写入不可避免地干扰旧知识的存储。学界已提出弹性权重固化(EWC)、渐进式神经网络、记忆回放(Replay)等缓解策略,但在大规模语言模型上彻底解决这一问题仍是开放课题。对于动态权重生成范式而言,灾难性遗忘的风险以更隐蔽的形式存在:实时生成的权重若缺乏对历史知识分布的约束机制,基础模型能力可能在权重刷新过程中被悄然侵蚀,这是该方向在工程落地时必须正面应对的系统性风险。
相关推荐
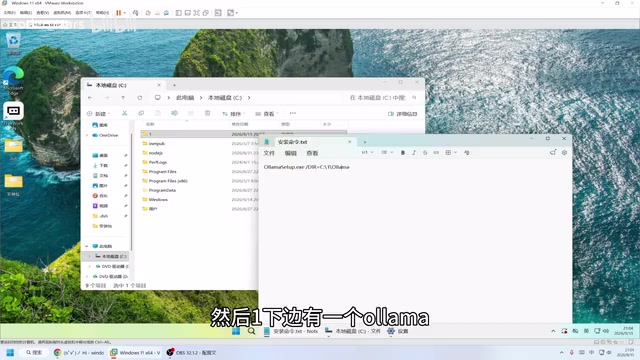
Ollama 换盘安装指南:告别默认C盘占用
Ollama 默认安装到 C 盘怎么办?本文详解通过命令行参数指定安装路径、配置环境变量实现命令全局调用,以及用 where 命令定位软件安装位置的完整方法,适用于 Windows 10/11。
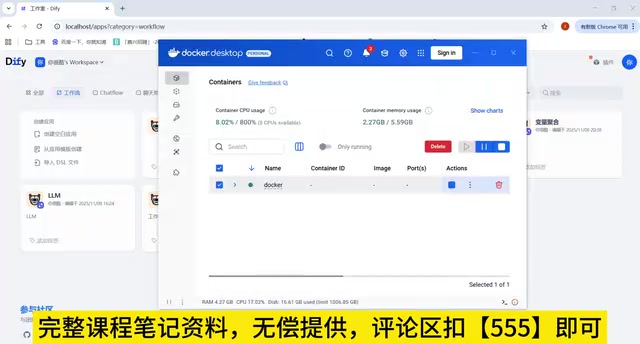
Dify本地部署实战:Docker+Ollama+RAG全流程搭建指南
Dify 本地部署实战教程解析:从 Docker 环境搭建、Ollama 本地大模型部署,到工作流设计、变量管理与 RAG 知识库应用,全流程覆盖,帮助开发者搭建私有化 AI 应用。
本地部署大模型完全教程:Ollama+Qwen 隐私免费方案
手把手教你在本地免费部署大模型:通过 Ollama 运行引擎加载 Qwen 通义千问开源模型,搭配图形客户端实现类豆包体验,数据不外泄、零费用,附完整安装步骤与硬件建议。