无需GPU的本地预训练分类器:轻量化AI部署新思路
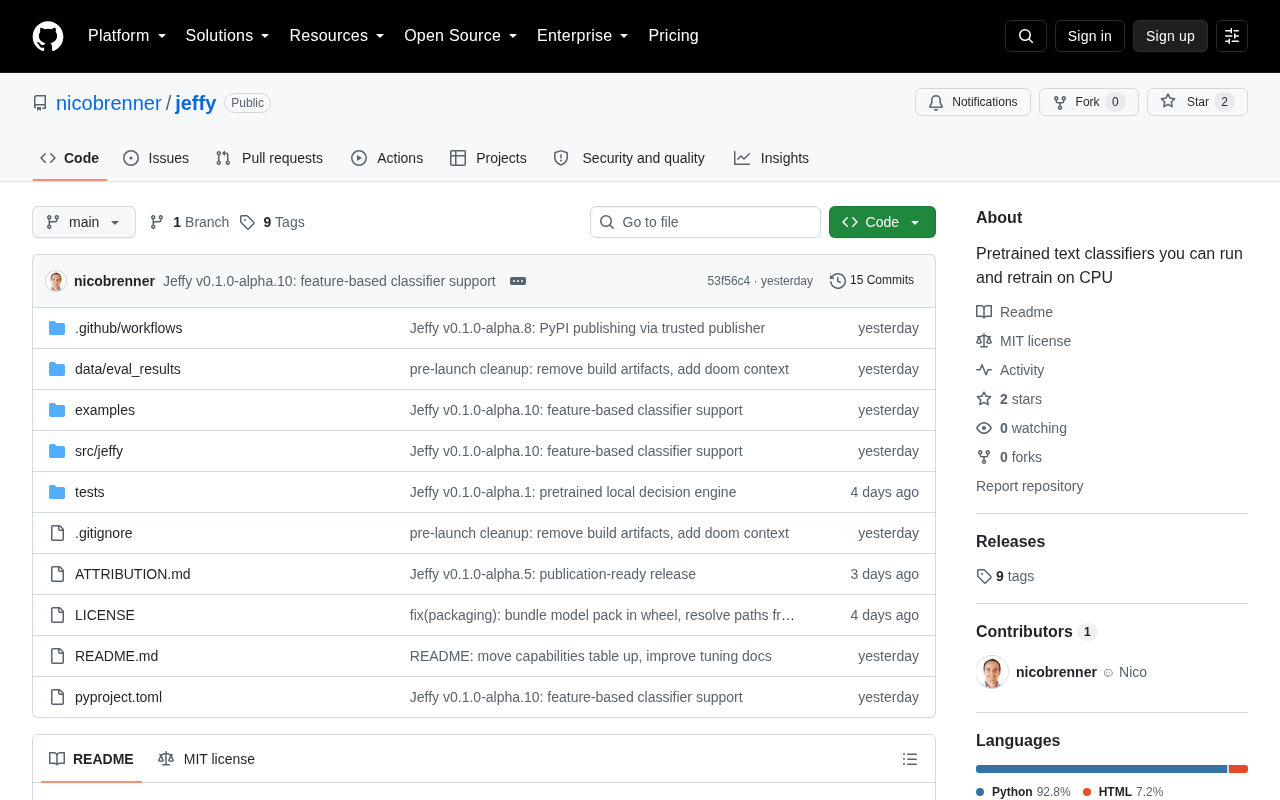
本地预训练分类器无需GPU即可运行,以轻量低成本方式解决结构化分类任务。
一个名为「Local pretrained classifiers, GPU not needed」的项目主张:情感分析、内容审核、意图识别等结构化分类任务不需要生成式大模型,使用轻量预训练分类器在普通CPU上即可完成。该方案的核心优势在于降低硬件成本、简化部署流程、保护数据隐私并提供稳定的本地推理延迟,适合中小团队和对数据合规敏感的场景。其局限同样清晰:面向固定类别体系,面对新领域或高度细分任务时仍需微调,无法替代大模型的复杂语义理解与生成能力。该项目折射出AI工程实践的分层趋势——按任务复杂度匹配合适工具,而非一律追求最大模型。
本地分类器为何重要
在大模型热潮席卷行业的当下,一个名为「Local pretrained classifiers, GPU not needed」的项目在 Hacker News 上亮相,提出了一个与主流叙事相反的方向:并非所有 AI 任务都需要庞大的模型和昂贵的 GPU。这个 Show HN 项目主打本地运行的预训练分类器,强调在无 GPU 环境下即可完成文本或数据分类任务。
对于许多实际业务场景而言,核心需求往往只是「把输入归到正确的类别里」,例如情感分析、垃圾内容过滤、意图识别、内容标注等。这类任务并不需要生成式大模型的复杂推理能力,用经过训练的轻量分类器反而更高效、更可控。
无需GPU的技术价值
该项目最吸引人的卖点是「GPU not needed」。这意味着开发者可以在普通的笔记本、服务器甚至边缘设备上直接运行分类模型,而不必依赖显卡资源或云端 GPU 实例。
这种设计带来几个直接好处:
- 成本降低:省去 GPU 云实例的高昂费用,CPU 推理即可满足需求。
- 部署简化:无需配置复杂的 CUDA 环境和驱动依赖,降低了工程落地门槛。
- 隐私可控:模型在本地运行,数据无需上传至第三方 API,适合对数据合规敏感的场景。
- 延迟稳定:本地推理避免了网络往返,响应时间更可预测。
对于中小团队和独立开发者来说,这种「够用即可」的轻量路线,往往比追逐最大、最新的模型更务实。
从技术实现角度看,「无需GPU」的背后通常依赖两类方案:一是使用经典机器学习方法(如逻辑回归、SVM、朴素贝叶斯)配合预计算的文本特征(如TF-IDF或固定词向量),这类模型参数量极小,CPU推理延迟可低至毫秒级;二是采用轻量级神经网络架构,如蒸馏版BERT(DistilBERT)或专为边缘端优化的模型,通过模型蒸馏、量化(INT8/FP16)等压缩技术将参数量降低至千万级以下,使其在CPU上也能达到可接受的推理速度。相比之下,GPT系列大模型通常拥有数十亿至数千亿参数,即便做推理优化也难以在CPU上实时运行。理解这一技术背景,有助于评估本地分类器的性能上限与适用边界。
适用场景与局限
预训练分类器的定位非常清晰:解决结构化的分类问题,而非开放式生成任务。它适合嵌入到现有业务流程中,作为一个即插即用的判断模块。
典型的应用方向包括:
内容审核与过滤
对用户提交的文本进行快速分类,识别垃圾信息、违规内容或特定主题,无需调用重量级模型。
数据标注与归类
在数据预处理阶段自动打标签,为后续的数据分析或模型训练节省人工成本。
意图识别
在客服、聊天机器人等场景中快速判断用户意图,再决定下一步处理逻辑。
需要清醒认识的是,这类方案的局限同样明显。预训练分类器通常面向固定的类别体系,面对全新领域或高度细分的任务时,仍可能需要微调甚至重新训练。它无法替代大模型在复杂语义理解和生成上的能力,而是定位于「补位」——用更低的代价处理那些被大模型「杀鸡用牛刀」的日常任务。
「预训练」(pretrained)在这里有特定含义:模型已在大规模通用语料上完成初始训练,具备一定的语言理解基础,用户无需从零开始训练即可直接使用。这与「零样本分类」(zero-shot classification)和「少样本学习」(few-shot learning)形成概念上的区分——零样本分类器(如基于CLIP或NLI的方案)允许用户以自然语言描述类别,灵活性更高但通常需要更大的基础模型;而预训练分类器通常已固化类别输出层,使用门槛更低、推理更快,但迁移到新类别时需要微调(fine-tuning)。对于类别固定、数据量充足的业务场景,预训练分类器的性价比往往优于更通用的方案。
轻量化趋势下的理性选择
从行业视角看,这类项目反映出 AI 工程实践正在走向分层。并非每个问题都要用最大的模型解决,合理的架构应该根据任务复杂度匹配相应的工具。本地预训练分类器正是这种「成本—效果」平衡思路的产物。
需要说明的是,该项目目前在 Hacker News 上的关注度仍然有限(仅 4 分、暂无评论),具体的模型架构、支持的分类类型、准确率指标等细节尚未充分展开。感兴趣的开发者在实际采用前,建议结合自身任务对模型的覆盖范围和性能进行验证测试。
无论如何,它所代表的「本地优先、无需 GPU」的理念,为那些被云端 GPU 成本和部署复杂度困扰的团队,提供了一条值得关注的替代路径。
相关推荐

本地AI自主完成42分钟人格测试:持久化智能体架构实测
一位开发者让本地AI智能体Aura自主完成42分钟的荣格人格测试,从预测结果到逐题作答再到自我对比。本文解析这一实验背后关于持久化智能体架构与长程任务连贯性的技术命题。

AI功能何时算「可以上线」?一个被忽视的决策难题
一位ASU研究生在Reddit发起调查,探讨团队如何判断AI功能「可以上线」。本文从验收标准、评估流程摩擦与预算审批三个维度,分析AI产品落地中这一被忽视的决策难题。

Claude Code v2.1.289更新:插件稳定性与安全修复详解
Claude Code v2.1.289 发布,重点修复 Bash 命令安全规则漏洞、插件与 mod 渲染稳定性问题,并新增面向多智能体协作的 agent.spawn 能力。本文详解这次维护型更新的关键变化及其对企业用户的意义。