无需训练即可发现LLM风格轴:采样+PCA的低成本探针方法
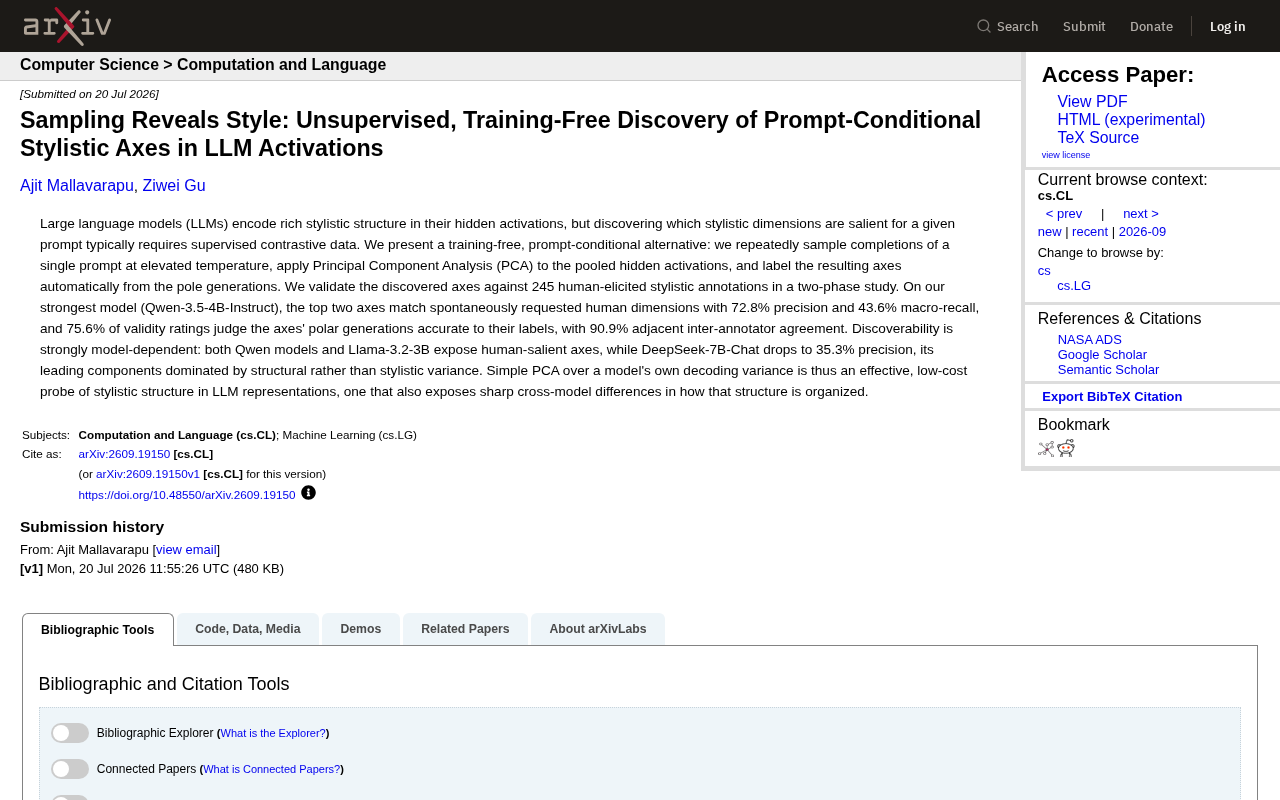
无需训练,对单一提示高温多次采样后做PCA,即可从LLM内部激活中自动发现风格轴。
这篇论文提出了一种免训练的LLM风格轴发现方法:对同一提示词进行高温多次采样,汇聚隐藏激活后做PCA降维,再对主轴两极的生成结果自动打标签,全程无需人工标注或模型微调。在Qwen-3.5-4B-Instruct上,前两条主轴与245条人类自发风格标注的匹配精确率达72.8%,有效性评分75.6%,标注者相邻一致率90.9%。然而方法效果高度依赖模型:Qwen和Llama系列能暴露人类可感知的风格轴,而DeepSeek-7B-Chat的主成分却被格式等结构性方差主导,精确率仅35.3%。这一差异本身即是有价值的发现,揭示了不同模型在内部表征中组织风格信息的方式存在根本性差异,为低成本模型可解释性诊断提供了新工具。
从隐藏激活中读出"风格"
大语言模型(LLM)在生成文本时,其内部隐藏激活里编码了丰富的风格结构——语气正式或随意、叙述详略、情感倾向等。问题在于,要弄清楚对某个特定提示词而言,哪些风格维度最为显著,传统做法往往依赖有监督的对比数据(supervised contrastive data),需要人工标注大量成对样本,成本高且难以规模化。
这篇来自 arXiv 的新论文(arXiv:2609.19150v1)提出了一条截然不同的路径:无需训练、以提示词为条件(prompt-conditional)的风格轴发现方法。核心思路简洁得令人意外——不去构造对比数据集,而是让模型在同一个提示词上反复采样,从它自身的解码方差中"读出"风格结构。
方法拆解:采样、降维、自动标注
该方法的流程可以概括为三步,且全程不涉及任何模型参数更新:
第一步:高温采样
对单个提示词,在较高的采样温度下重复生成多条补全(completions)。提高温度意味着模型输出的多样性增大,同一提示下会呈现出不同的风格倾向,这些差异正是后续分析的原材料。
第二步:PCA 降维
将这些补全对应的隐藏激活汇聚起来,施加主成分分析(PCA)。PCA 会自动找出激活空间中方差最大的若干方向——这些主轴(axes)就对应着模型在该提示下变化最剧烈的风格维度。
主成分分析(PCA)是一种经典的无监督线性降维技术,其核心是找到数据在高维空间中方差最大的若干正交方向(即主成分)。对于LLM的隐藏激活来说,每一层的激活向量通常有数千甚至数万个维度,直接分析极为困难。PCA将这些高维激活投影到少数几个方差最大的轴上,每个轴都代表激活空间中变化最剧烈的一个方向。在本方法中,研究者对同一提示词的多次采样得到的隐藏激活矩阵做PCA,第一主成分捕捉的是所有采样结果中差异最大的那个方向,第二主成分则是在与第一主成分正交的前提下方差次大的方向,以此类推。直觉上,如果模型在该提示下"最常在正式与随意之间摇摆",那么第一主成分就会对应这一风格对立方向;而不同模型的主成分可能捕捉到完全不同的结构,这正是DeepSeek-7B-Chat与Qwen系列表现分化的根源。
第三步:自动标注两极
对每条主轴,取其正负两极的代表性生成结果(pole generations),自动为该轴打上语义标签。整个过程无需人工预设风格类别,风格维度是从模型自身行为中"涌现"出来的。
这种设计的巧妙之处在于:它把"模型自己在采样时会朝哪些方向摇摆"直接当作探测信号,而不是外部强加一套风格标准。
实验验证:与 245 条人工标注对照
论文通过一项两阶段研究来检验发现的风格轴是否可信,对照基准是 245 条人类自发提出的风格标注。
在表现最强的模型 Qwen-3.5-4B-Instruct 上,结果颇具说服力:
- 前两条主轴与人类自发请求的风格维度匹配,精确率达 72.8%,宏平均召回率 43.6%;
- 75.6% 的有效性评分认为这些主轴两极的生成结果准确对应其标签;
- 标注者之间的相邻一致率高达 90.9%,说明评判结果本身相当稳健。
召回率偏低(43.6%)暗示,仅靠方差最大的前两条轴还不能覆盖人类关注的全部风格维度——毕竟人类可能在意十几种风格属性,而前两个主成分只能捕捉最突出的那几个。但对于一个零训练成本的探针方法来说,这样的精确率已相当可观。
宏平均召回率(macro-average recall)是将每个类别的召回率取算术平均,不受类别样本量影响——这与加权平均召回率形成对比,后者会让高频类别主导结果。本实验中43.6%的宏平均召回率意味着:对于人类标注员自发提出的各类风格维度(如"正式程度""句子长短""情感温度"等),前两条PCA主轴平均只能覆盖其中不到一半。这一数字的合理解读是:PCA前两轴擅长发现最显著的1-2个风格维度,但人类关注的风格属性往往有十余种,分布在激活空间的更多方向上,仅靠前两个主成分必然存在盲区。若扩展到更多主成分,召回率理论上可以提升,但同时会引入更多噪声轴,精确率可能随之下降,这构成方法本身的核心权衡。
关键发现:风格可发现性高度依赖模型
这项研究最值得玩味的结论,是不同模型在风格结构组织方式上的显著差异。
同样的采样加 PCA 流程,在不同模型上效果分化明显:
- Qwen 系列模型和 Llama-3.2-3B 都能暴露出人类可感知的风格轴;
- 而 DeepSeek-7B-Chat 的精确率骤降至 35.3%——它的主成分被结构性方差(structural variance)而非风格方差主导。
换句话说,DeepSeek-7B-Chat 在高温采样下的变化,更多体现在文本结构(如段落组织、格式)上,而非风格层面。这提示我们:同等规模的模型,其内部表征的组织逻辑可能截然不同,风格并非天然就是某个模型隐藏空间里的主导变化方向。
这一发现对模型可解释性研究有实际意义——它揭示了一种低成本手段,可以横向比较不同模型"如何在表征中组织风格信息"。
结构性方差(structural variance)在此指文本在格式、段落划分、列表使用、长度分布等"骨架层面"的变化,区别于词汇选择、语气、情感等"风格层面"的变化。DeepSeek-7B-Chat在高温采样下的主要变动集中于前者——例如同一问题有时以要点列表回答,有时以长段落叙述,激活空间的最大方差方向因此被这种格式切换所占据,而非更细腻的风格差异。这一现象可能与模型的训练数据构成、RLHF对齐方式或指令微调策略有关:若训练时大量使用了格式多样的指令数据,模型可能将"选择输出格式"内化为比"调节语气"更显著的解码自由度。这提示研究者在比较不同模型的表征时,需要区分"格式多样性"与"风格多样性"这两类本质不同的变化源。
为什么这个方法值得关注
从工程与研究双重视角看,这套方法的价值在于三个词:免训练、低成本、可诊断。
它不需要构造昂贵的对比数据集,只用模型自身的解码方差就能探测风格结构,几乎可以即插即用于任何开源 LLM。同时,它还能作为一种诊断工具,快速判断某个模型的风格维度是否"可被发现",进而反映其表征组织的健康程度。
当然,局限也很清楚:召回率有限意味着它更适合发现最显著的风格轴,而非穷尽所有维度;且方法对模型强依赖,在 DeepSeek 这类模型上会失效。但作为一种探针(probe),它为理解 LLM 内部风格表征提供了一个轻量而有效的切入点。
对于关注模型可解释性、风格控制或提示工程的研究者而言,这提供了一个几乎零门槛的实验起点:给一个提示,多采几次样,跑一次 PCA,就能窥见模型"风格的骨架"。
相关推荐
FAISS向量搜索实战入门:从Embedding到RAG的踩坑心得
一位开发者分享FAISS向量搜索的实战入门心得,讲解从Embedding到RAG的完整数据流,并深入探讨人名、日期、过滤条件和对话历史等真实场景下的检索难点与应对方案。
H3 Camera Control v3来袭:视频镜头控制与快速渲染上线
H3 Camera Control v3更新预告发布,将带来视频镜头控制与快速渲染两项核心升级,提升AI视频创作的可控性与效率。本文解读新功能方向与行业意义。
AI大模型测试三阶段:从原理到API调用实战指南
面向测试从业者的AI大模型学习路径:从文本输入原理、提示词工程,到基于OpenAI库的API与SDK调用实战,理清Token与API Key区别、流式输出机制,并延伸到RAG与Agent智能体的落地方向。