系统性泛化评测的盲区:TranSGrid揭示三种推理缺失
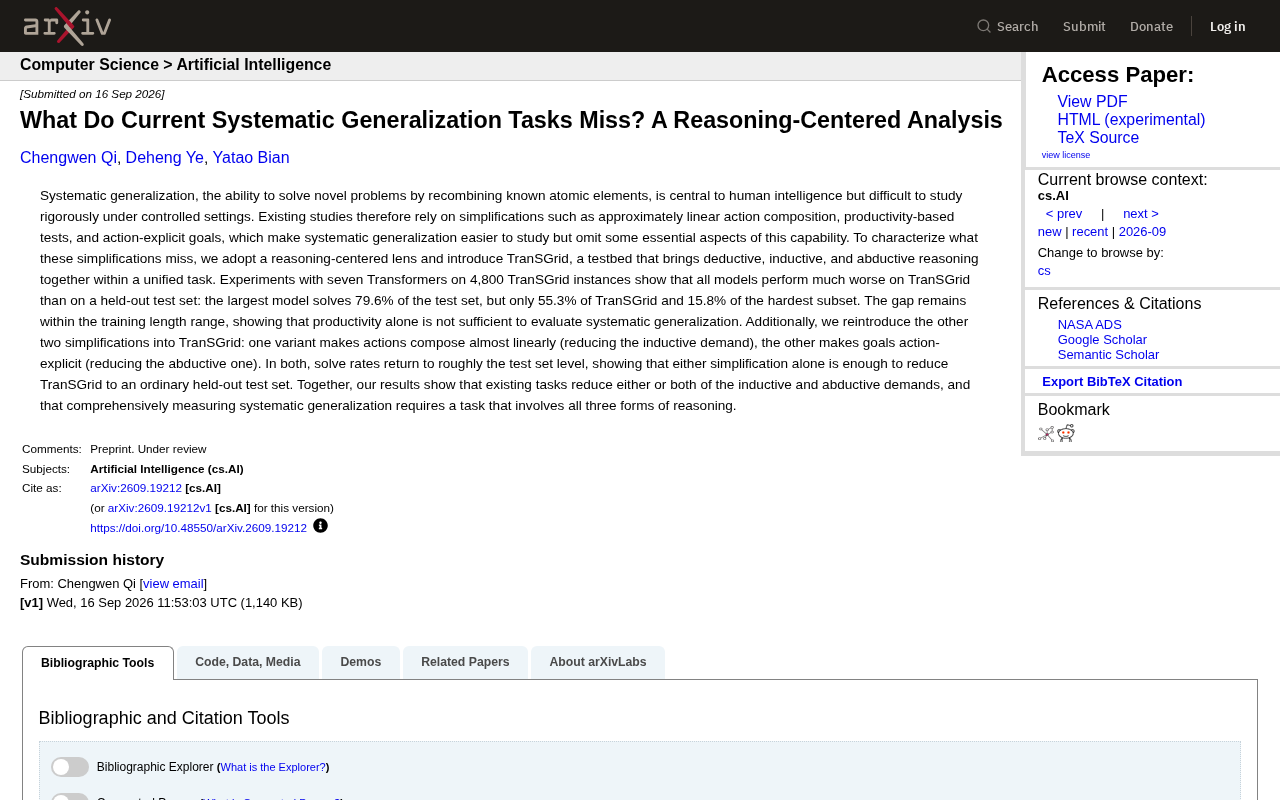
TranSGrid研究揭示现有系统性泛化测试因三类简化而系统性高估了模型推理能力
这篇arXiv论文指出,现有系统性泛化评测任务普遍依赖三类简化——近似线性的动作组合、以序列长度扩展为核心的生产力测试、以及直接给出动作描述的显式目标——这些简化分别削弱了归纳推理和溯因推理的需求,导致评测虚高。研究者为此构建了TranSGrid测试平台,将演绎、归纳、溯因三种推理整合进统一任务框架。在4,800个实例上测试七个Transformer模型的结果显示,最强模型在留出测试集上达79.6%解题率,但在TranSGrid上仅55.3%,最难子集更骤降至15.8%,且性能差距出现在训练长度范围之内。对照实验进一步证明,任何一种简化单独引入即可让TranSGrid退化为普通测试集,说明全面评估系统性泛化必须同时涵盖三种推理形式。
系统性泛化:从人类智能到AI评测的核心难题
系统性泛化(Systematic Generalization)指的是通过重新组合已知的原子元素来解决新问题的能力,这被认为是人类智能的核心特征之一。然而,在受控实验环境下严谨地研究这一能力却困难重重。为了让研究变得可行,现有工作普遍依赖若干简化假设,而这些简化恰恰可能掩盖了系统性泛化最本质的部分。
一篇发表于arXiv(编号2609.19212v1)的最新研究以“推理为中心”的视角切入,系统审视了当前系统性泛化任务存在的结构性缺陷,并提出了名为 TranSGrid 的新测试平台。研究的核心问题很直接:现有的评测任务到底遗漏了什么?
现有任务的三重简化陷阱
研究指出,现有系统性泛化研究通常依赖三类简化手段:
- 近似线性的动作组合:假设复合动作可以由原子动作以近乎线性的方式叠加,这大幅降低了任务对**归纳推理(inductive reasoning)**的要求。
- 基于生产力(productivity)的测试:主要考察模型能否将短序列的组合模式扩展到更长序列,即在训练长度之外的表现。
- 动作显式的目标(action-explicit goals):目标直接以动作形式给出,这削弱了任务对**溯因推理(abductive reasoning)**的需求。
这些简化让研究更容易开展,但也让任务偏离了真实的系统性泛化场景。作者认为,正是这些被“省略”的部分,才是衡量泛化能力时最关键的维度。
这里涉及的三种推理形式值得简要说明。**演绎推理(deductive reasoning)**是从已知规则出发推导出必然结论,例如已知"所有A都是B"和"这是A",则"这是B";**归纳推理(inductive reasoning)**是从具体案例中抽象出一般规律,需要模型识别动作组合背后的非线性结构;**溯因推理(abductive reasoning)**则是从观察到的结果反向推断最可能的原因或路径,要求模型在没有明确动作指令的情况下自主规划达成目标的方式。现有任务通过让动作组合近似线性来回避归纳的复杂性,又通过直接给出动作描述来绕开溯因的需要,使得任务在表面上仍像"泛化测试",实则已将最具挑战性的推理维度悄然剔除。
TranSGrid:三种推理的统一战场
TranSGrid 的设计理念是将**演绎(deductive)、归纳(inductive)、溯因(abductive)**三种推理形式整合进同一个统一任务中。相比只考察单一维度的传统基准,这种设计能够更全面地暴露模型在系统性泛化上的短板。
研究团队在 4,800 个 TranSGrid 实例上测试了七个 Transformer 模型。结果颇具冲击力:所有模型在 TranSGrid 上的表现都远差于常规的留出测试集(held-out test set)。其中表现最好的最大模型能解决 79.6% 的留出测试集问题,但在 TranSGrid 上只能解决 55.3%,在最难子集上更是骤降至 15.8%。
关键在于,这一性能鸿沟出现在训练长度范围之内。也就是说,模型的失败并非因为需要处理更长的序列,而是任务本身对推理提出了更综合的要求。这直接说明:仅凭生产力(长序列扩展能力)不足以评估系统性泛化。
TranSGrid 的名称结合了"Transformation"与"Grid",其任务形式以网格世界(grid world)为载体:模型需要在二维网格环境中理解状态转换规则,并在面对新初始状态或新目标状态时,推断出正确的动作序列。这种设定天然支持三种推理的融合——演绎对应已知规则的直接应用,归纳对应从有限样本中识别非线性组合规律,溯因对应以终态为目标反向规划路径。以网格世界为底层环境还带来另一个优势:任务实例可以程序化生成,从而精确控制测试集中每个推理维度的难度分布,确保评测的可复现性与可解释性。
拆解验证:简化如何让任务“变简单”
为了验证三种简化各自的影响,研究者做了一组巧妙的对照实验——把此前被剔除的简化重新引入 TranSGrid,观察模型表现如何变化。
- 变体一:让动作近似线性组合。这减少了任务的归纳需求,结果模型的解题率回升到接近留出测试集的水平。
- 变体二:让目标变为动作显式。这减少了溯因需求,结果同样使解题率回到普通测试集的水平。
这两个实验揭示了一个重要结论:任何一种简化单独存在,都足以把 TranSGrid 降格为一个普通的留出测试集。 换言之,现有主流任务之所以看起来“可解”,正是因为它们削弱了归纳或溯因(或两者兼有)的推理压力。
对AI评测方法论的启示
这项研究的价值不仅在于提出了一个更难的基准,更在于它揭示了当前评测范式的系统性偏差。当我们用简化后的任务去测量泛化能力时,得到的高分可能只是任务本身“放水”的结果,而非模型真正具备了组合式推理能力。
研究的核心主张可以概括为:全面衡量系统性泛化,必须使用同时涉及演绎、归纳、溯因三种推理的任务。 任何缺失其中一环的评测,都可能高估模型的实际能力。
对于关注大模型推理能力的研究者和从业者而言,这一结论提醒我们重新审视手头的基准工具——一个模型在传统泛化任务上表现优异,未必意味着它掌握了真正的系统性泛化。TranSGrid 这样的多推理融合测试平台,或许会成为未来评估模型组合推理能力的重要参照。
这一发现与近年来学界对"基准污染(benchmark contamination)"和"捷径学习(shortcut learning)"的担忧一脉相承。模型可能通过学习任务的表面统计特征(如序列长度分布、词频模式)来获得高分,而非真正习得泛化所需的结构性理解。系统性泛化任务中的简化恰好为此类捷径提供了土壤:线性动作组合意味着模型可以用简单的序列拼接策略通关,动作显式目标则省去了逆向规划的必要。TranSGrid 的贡献在于通过设计层面的约束,主动封堵这些捷径,迫使模型必须进行真实的多步推理才能解题。
结语
系统性泛化是通往更强通用智能的关键能力之一,而如何科学地测量它同样重要。TranSGrid 的研究通过引入三种推理的统一框架,揭示了现有任务在归纳与溯因维度上的普遍缺失,也为后续构建更严谨的评测体系提供了明确方向。当前 Transformer 模型在最难子集上仅 15.8% 的解题率,也说明距离真正的系统性泛化,仍有相当长的路要走。
相关推荐
FAISS向量搜索实战入门:从Embedding到RAG的踩坑心得
一位开发者分享FAISS向量搜索的实战入门心得,讲解从Embedding到RAG的完整数据流,并深入探讨人名、日期、过滤条件和对话历史等真实场景下的检索难点与应对方案。
H3 Camera Control v3来袭:视频镜头控制与快速渲染上线
H3 Camera Control v3更新预告发布,将带来视频镜头控制与快速渲染两项核心升级,提升AI视频创作的可控性与效率。本文解读新功能方向与行业意义。
AI大模型测试三阶段:从原理到API调用实战指南
面向测试从业者的AI大模型学习路径:从文本输入原理、提示词工程,到基于OpenAI库的API与SDK调用实战,理清Token与API Key区别、流式输出机制,并延伸到RAG与Agent智能体的落地方向。