预训练知“什么”,仿真教“如何”:ZAP让机器人零真实数据达96.7%成功率
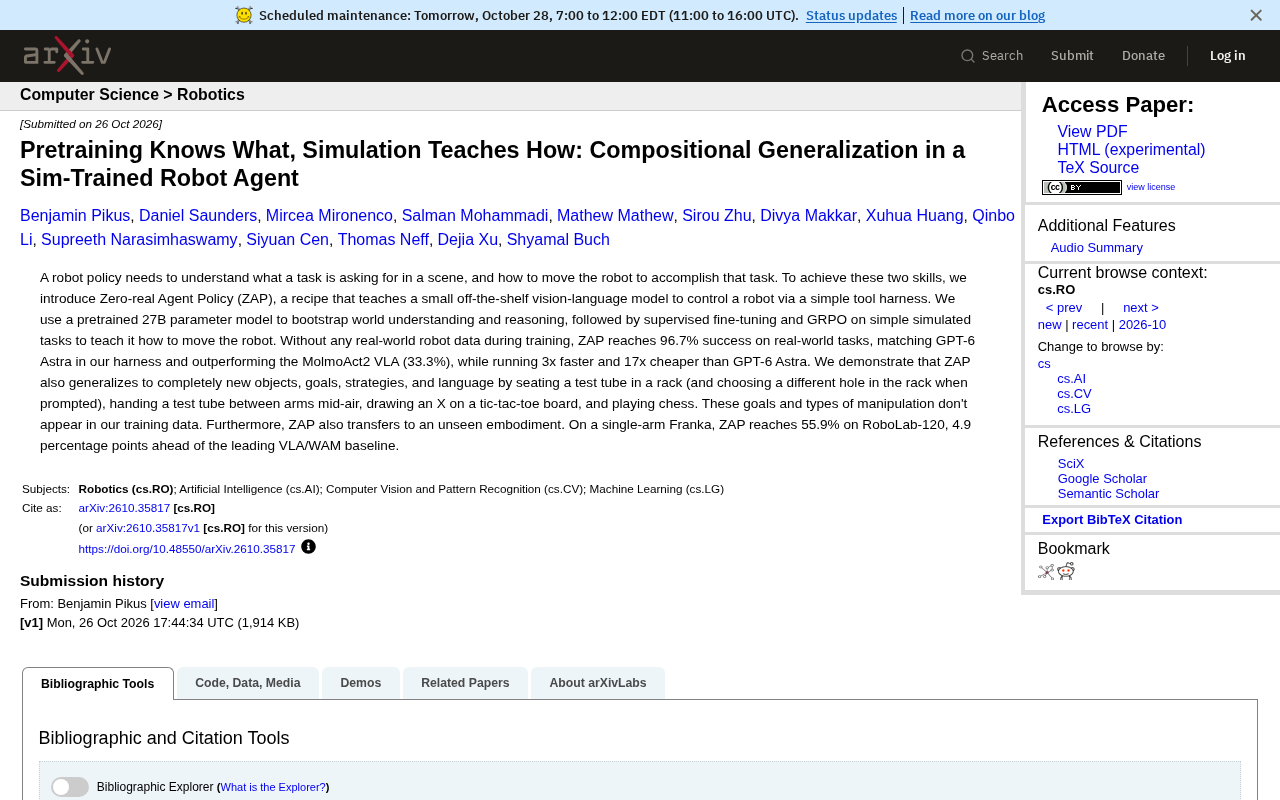
ZAP用预训练视觉语言模型理解任务、仿真学习动作,零真实数据实现96.7%成功率。
ZAP提出一种解耦式机器人策略:预训练视觉语言模型负责理解任务“是什么”,仿真环境负责教会机器人“怎么动”,全程不使用真实机器人数据。在真实任务上达到96.7%成功率,与GPT-6 Astra持平但快3倍、成本低17倍,远超MolmoAct2 VLA的33.3%。模型还展现出组合泛化能力,能完成训练集中未出现的试管换孔、空中交接、画X和下棋等任务,并在未见过的Franka机器人上达到55.9%。其核心启示是:任务表现的关键可能不在模型规模,而在训练信号的组织方式。
机器人策略需要同时理解两件事:当前场景中的任务要求“是什么”,以及如何控制机器人身体去完成它。传统上,这两项能力往往依赖大量真实机器人数据来联合训练。但一篇来自rss的最新研究提出了不同思路——Zero-real Agent Policy(ZAP),它用预训练视觉语言模型提供世界理解,用仿真环境教会动作技能,全程不碰真实机器人数据,却在真实任务上达到了96.7%的成功率。
一个模型,两个来源:ZAP的核心思路
ZAP的出发点是拆解机器人控制的认知负担。研究团队认为,“知道任务要什么”和“知道怎么动”是可以解耦的两类知识。前者来自大规模预训练模型对世界的理解,后者则可以在仿真中高效习得。
具体实现上,ZAP采用了一个小型现成的视觉语言模型(27B参数),通过简单的工具调用框架来控制机器人。训练流程分两步:先用预训练模型“启动”世界理解与推理能力,再通过监督微调和GRPO(一种强化学习方法)在简单仿真任务上教会模型如何移动机器人。整个过程没有任何真实世界机器人数据参与。
这种设计的好处很直接:预训练模型已经见过海量视觉和语言概念,不需要从零学习“试管”“棋盘”是什么;而仿真环境则负责提供低成本、可大规模重复的动作学习信号。
GRPO(Group Relative Policy Optimization) 是一种无需价值网络的强化学习算法,最初用于大语言模型的推理对齐。它通过对同一提示采样一组输出,以组内相对优势估计策略梯度,避免了训练额外的评论家模型,显著降低了显存与计算开销。在ZAP中,GRPO被用于在仿真环境中微调视觉语言模型,使其输出的动作序列获得更高的任务奖励。相比传统的PPO,GRPO更适合参数规模较大、采样成本较高的模型,这也解释了ZAP为何能在27B模型上以较低成本完成动作技能学习。
仿真训练,真实落地:96.7%成功率意味着什么
ZAP在真实世界任务上达到96.7%的成功率,这个数字需要放在对比中理解。在同一工具框架下,它的表现与GPT-6 Astra持平,但运行速度快3倍、成本低17倍。而对比专门的视觉-语言-动作模型MolmoAct2 VLA,后者成功率仅为33.3%,差距显著。
更说个细节,ZAP的参数量只有27B,属于“小型现成模型”,却在 harness 内追平了规模更大的通用模型。这说明任务表现的关键可能不在于模型规模,而在于训练信号的组织方式——预训练提供语义先验,仿真提供动作经验,两者各司其职。
在单臂Franka机器人这一未见过 embodiment 上,ZAP在RoboLab-120基准上达到55.9%,领先最先进的VLA/WAM基线4.9个百分点。跨 embodiment 的迁移能力是机器人策略实用化的重要门槛,ZAP在零真实数据条件下做到这一点,说明其学到的不是特定机器人的动作记忆,而是更通用的任务执行逻辑。
Embodiment(具身形态) 在机器人学习中指智能体所依赖的物理身体及其传感器、执行器配置,例如机械臂的关节数量、相机位置、夹爪类型等。不同embodiment意味着动作空间和观测分布存在差异,策略若过拟合于某一特定身体,迁移到新机器人时性能会大幅下降。ZAP在单臂Franka上零样本迁移的表现,说明其策略并非记忆特定关节轨迹,而是学到了与身体形态解耦的任务执行逻辑。这种跨embodiment泛化能力是评估机器人基础模型实用性的关键指标之一。
组合泛化:训练集里没有的任务,也能完成
ZAP最值得关注的能力是组合泛化。研究团队展示了若干训练数据中完全未出现的任务:
- 将试管放入试管架,并在提示时选择不同的孔位;
- 在空中双臂之间交接试管;
- 在井字棋盘上画一个X;
- 下国际象棋。
这些任务涉及全新的物体、目标、策略和语言指令,都不在训练分布内。ZAP能够完成它们,说明预训练模型提供的“what”理解与仿真习得的“how”技能可以组合出新的行为。换句话说,模型不是记住了特定任务的轨迹,而是学会了“理解指令—规划动作”的通用接口。
这种泛化路径对机器人学习有启发意义:与其穷举真实场景,不如把语义理解交给预训练,把动作技能交给仿真,让组合能力自然涌现。
组合泛化(Compositional Generalization) 指模型能够将已学过的概念、技能或子任务重新组合,以解决训练分布之外的新任务。与简单的插值泛化不同,组合泛化要求模型理解任务的结构性,而非仅拟合输入输出映射。在机器人领域,这意味着策略可以识别新物体、遵循新指令并规划新动作序列。ZAP能够完成试管换孔、空中交接等任务,正是其预训练语义理解与仿真动作技能可解耦组合的证据,也是衡量机器人策略是否具备“推理—执行”接口的重要标准。
多源视角下的共识与分歧
据rss来源的研究报告,ZAP的核心主张是仿真训练加预训练理解足以支撑真实机器人控制。这一结论在跨 embodiment 迁移和组合泛化两个维度上都有数据支撑,尤其是96.7%真实任务成功率和55.9%的Franka迁移表现,构成了较强的事实基础。
不过,单一来源也意味着部分结论仍需独立验证。例如,96.7%的成功率是在特定任务集和特定工具框架下取得的,任务复杂度和环境多样性是否足够代表真实部署场景,原文未展开说明。与GPT-6 Astra的对比也限于同一harness内,跨框架比较的公平性需要更多信息。这些是目前无法从单一来源确认的部分,读者在引用时宜保留审慎。
Harness(工具调用框架) 在此处指围绕视觉语言模型构建的推理与执行外壳,负责解析模型输出、调用工具接口并驱动机器人动作。它通常包含提示模板、工具定义、状态管理和安全约束等组件。ZAP的对比实验强调“同一工具框架下”与GPT-6 Astra持平,意味着性能差异主要来自模型本身而非外围工程。但这也提示,跨框架比较时harness的设计会显著影响成功率与成本,读者需注意不同研究在工具调用、重试机制和任务终止条件上的差异。
对机器人学习范式的启示
ZAP的价值不仅在于数字。它提出了一条可复制的recipe:用预训练模型解决“what”,用仿真解决“how”,用小规模现成模型加工具 harness 替代端到端大模型。这条路径的成本结构很不一样——17倍的成本差距意味着同样的预算可以支撑更多轮迭代和更大规模的仿真训练。
当然,仿真到真实的差距始终是机器人领域的硬骨头。ZAP在简单仿真任务上训练却能迁移到真实世界,说明其仿真任务设计可能抓住了动作学习的关键结构,而非依赖高保真物理模拟。这一点如果被后续工作证实,将大幅降低机器人策略训练的门槛。
目前ZAP的细节仍以单一来源呈现,组合泛化的边界、失败模式、以及对更复杂长程任务的适应性,都有待更多独立分析。但就现有证据看,预训练与仿真的分工思路,为机器人基础模型提供了一条值得跟踪的务实路线。
相关推荐
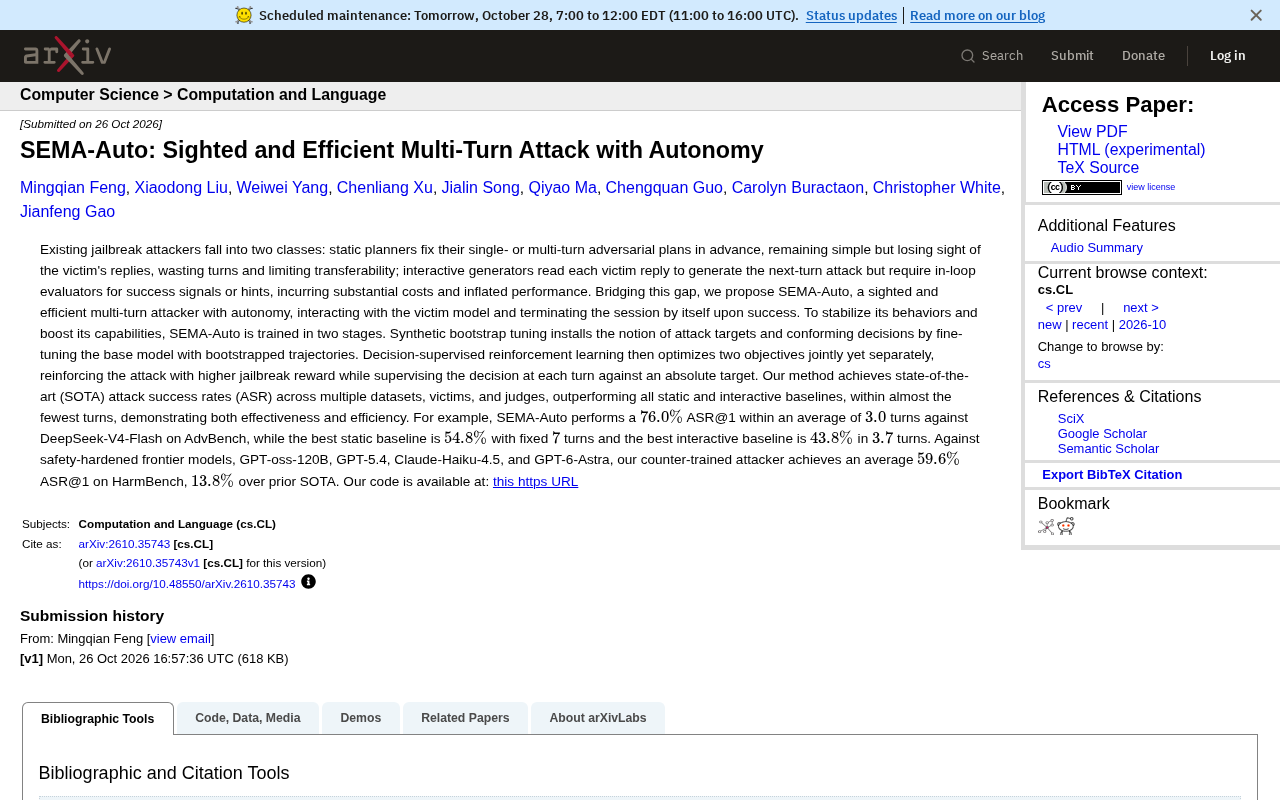
SEMA-Auto:自主多轮越狱攻击效率与成功率双突破
微软提出 SEMA-Auto 自主多轮越狱攻击方法,通过两阶段训练实现自主终止与高效攻击,在 AdvBench 上以 3 回合达 76% 成功率,超越静态与交互式基线。
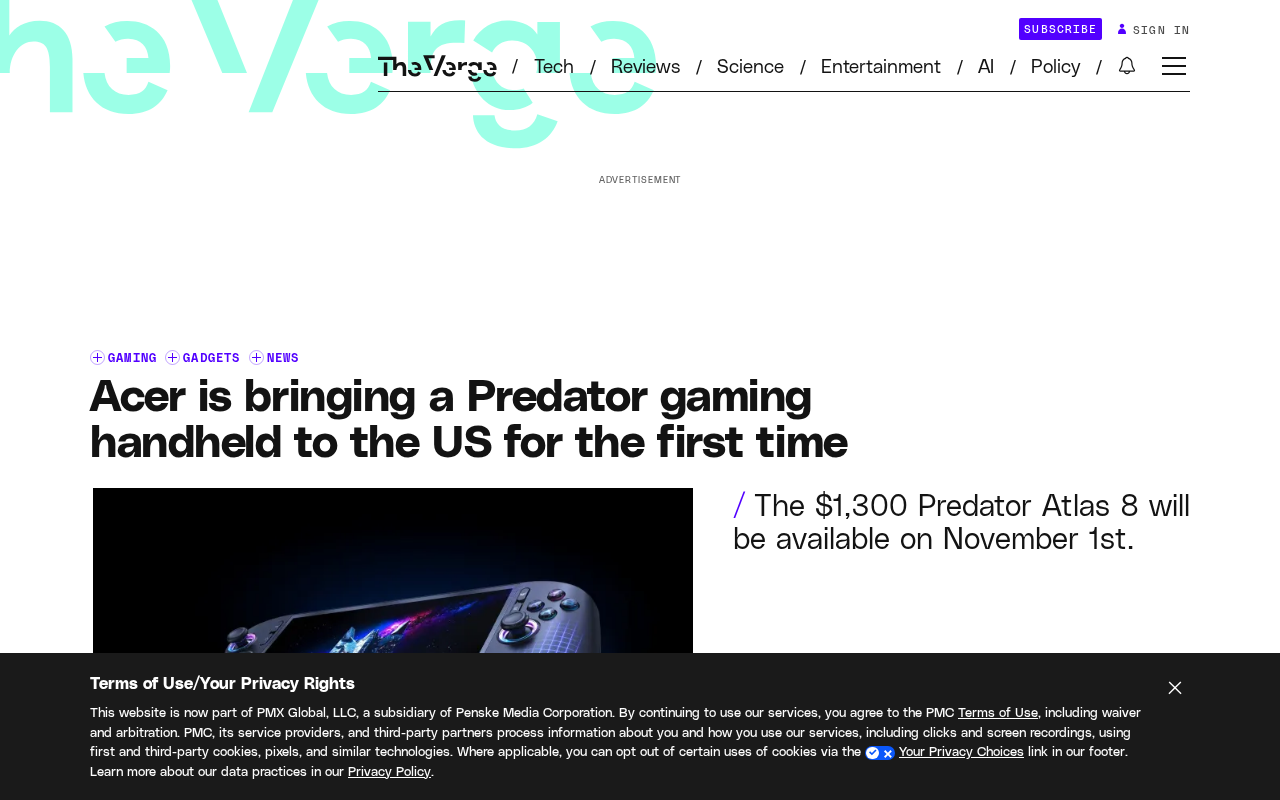
宏碁Predator Atlas 8游戏掌机首次登陆美国,独家首发Best Buy
宏碁Predator Atlas 8游戏掌机首次登陆美国市场,Intel Arc G3 Extreme版本将在Best Buy独家销售。本文梳理型号选择、渠道策略与市场竞争格局。
WorkBuddy怎么用?本地AI智能体安装与工作台搭建指南
WorkBuddy是什么?本文整理B站保姆级教程要点,讲清这款本地AI智能体的完整工作流:从官网下载安装、连接器绑定办公软件,到多智能体并行处理文档与数据分析,并对比Codex说明新手选它的理由。