自建算力训练RL模型:性能未见饱和迹象
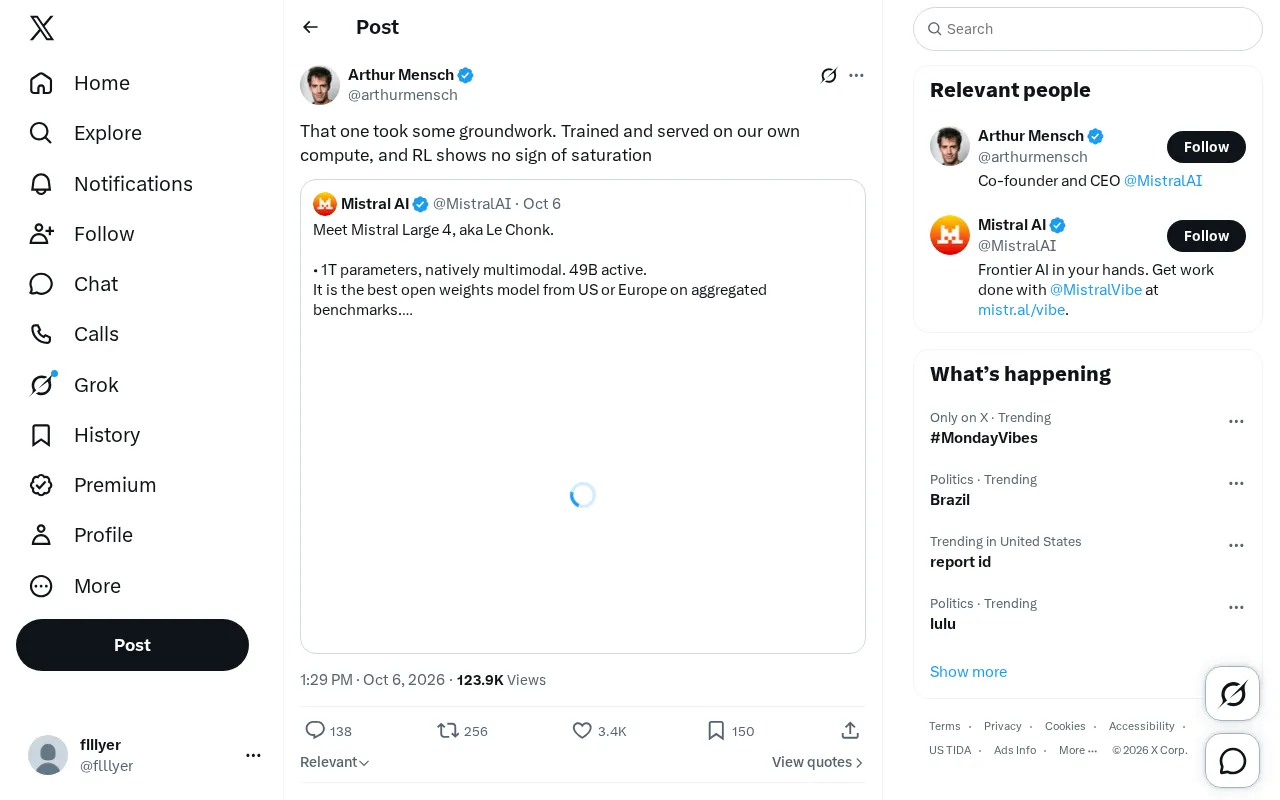
团队自建算力完成训练与推理,RL性能未见饱和,但信息披露有限需谨慎解读。
一条简短推文透露,某团队在自有算力上完成了模型训练与推理服务,并观察到强化学习性能尚未饱和。文章围绕两个关键词展开分析:自建算力涉及成本控制、数据安全和工程自主权,但需要前期投入搭建集群、网络和推理服务;RL未饱和则暗示扩大训练规模仍能带来收益,与RL scaling law的早期研究趋势吻合,但推文未披露任务和指标,结论仅具参考性。两者结合的意义在于实验迭代速度和推理自主性,尤其适合采样密集的RL训练。文章最后强调信息缺口,提醒读者不宜过度外推。
从推文到实践:自建算力完成训练与推理
近日,一条来自Twitter的简短推文引发了AI从业者的关注:“That one took some groundwork. Trained and served on our own compute, and RL shows no sign of saturation.”(这花了一些基础工作。我们在自己的算力上完成了训练和推理,而强化学习没有显示出饱和的迹象。)推文配图仅为来源标注,但信息量集中在两句话:团队没有依赖外部云服务,而是在自有算力上完成了模型的训练与部署;同时,他们观察到强化学习(RL)的性能曲线尚未出现饱和——这通常意味着增加计算资源或训练步数仍能带来收益。
这条推文没有给出具体的模型规模、算力配置或基准测试数据,因此我们只能基于其表述进行定性分析。但“自建算力”与“RL未饱和”两个关键词,恰好触及当前大模型研发的两个核心议题。
自建算力:成本控制与自主可控的双重考量
选择在自有算力上训练和推理,而非完全租用公有云,通常出于几方面考虑。一是长期成本:当训练任务持续且规模较大时,自建集群的边际成本可能低于按需付费的云服务。二是数据与模型安全:自有算力意味着训练数据、模型权重和推理请求不经过第三方基础设施。三是工程自主权:团队可以针对特定硬件进行深度优化,比如定制通信库、调整并行策略。
推文作者用“took some groundwork”来形容这一过程,暗示自建算力并非即插即用,需要投入前期工程。这与业界普遍认知一致:搭建可用的训练集群涉及硬件选型、网络互联、存储配置和故障恢复机制,推理服务则要考虑批处理、延迟和吞吐的平衡。完成这些基础工作后,团队才具备在自有算力上迭代RL实验的条件。
训练集群的网络互联 是自建算力中最容易被低估的工程难点。大模型训练依赖 GPU 之间的高频通信(如 All-Reduce 梯度同步),网络带宽和延迟直接决定训练效率。业界常见方案包括 InfiniBand 高速互联和 RoCE(RDMA over Converged Ethernet),前者性能更优但成本更高。此外,并行策略的选择——数据并行、张量并行、流水线并行及其组合——需要与硬件拓扑匹配,否则会出现通信瓶颈。推文所说的“groundwork”,很大程度上就包含这些底层工程的调试与优化。
RL未饱和:一个值得关注的信号
强化学习在大模型后训练阶段的重要性持续上升,尤其是在推理、代码生成和智能体任务中。所谓“饱和”,指的是继续增加训练计算量或数据量后,性能提升趋于平缓甚至停滞。推文称RL“no sign of saturation”,意味着在团队当前的设置下,扩大RL训练规模仍能带来可观测的改进。
这一观察与部分公开研究的趋势吻合:RL scaling law的研究尚在早期,许多团队报告了随计算量增加而持续提升的曲线。但需要指出,该推文并未披露具体任务、奖励设计或评估指标,因此“未饱和”的判断应理解为单一团队在特定场景下的经验,而非普适结论。不同任务对RL的响应差异很大,奖励稀疏或环境复杂的任务可能更早遇到瓶颈。
RL scaling law 是指强化学习训练中,模型性能随计算量、数据量或训练步数增加而变化的经验规律。与预训练阶段已被广泛验证的 scaling law 不同,RL 的 scaling 行为更复杂:它受奖励信号质量、采样效率、环境多样性等多重因素影响。目前学术界对 RL scaling law 的研究仍处于早期阶段,公开成果多集中在特定任务(如数学推理、代码生成)上,尚未形成像预训练那样通用的定量预测框架。推文中“no sign of saturation”的判断,本质上是在说该团队观测到的 RL 性能曲线仍处于上升区间,尚未进入平台期。
自建算力与RL结合的意义
将RL训练放在自有算力上,一个潜在优势是实验迭代速度。RL训练通常需要大量采样和多次前向推理,如果算力调度受限于外部服务,实验周期会被拉长。自有集群允许团队更灵活地分配资源,快速试错不同的奖励函数和训练配置。推文中“took some groundwork”的表述,或许正是指打通这套流程所付出的工程努力。
另一个角度是推理服务的自主性。推文提到“served on our own compute”,说明模型不仅训练在自有硬件上,线上推理也由自己托管。这对于需要低延迟或特殊数据处理的RL应用(如交互式智能体)尤为重要。
RL 训练中的采样开销 是理解“自有算力优势”的关键背景。与监督学习不同,RL 训练需要模型与环境反复交互生成轨迹,每一次策略更新都伴随大量采样和前向推理。以 RLHF(基于人类反馈的强化学习)为例,训练过程中需要频繁调用奖励模型和参考模型进行打分,推理负载远高于同等规模的监督微调。这意味着 RL 训练对算力调度的灵活性和推理吞吐的要求更高,外部云服务的按需计费和排队机制可能成为实验迭代的瓶颈,而自有集群可以通过资源预留和优先级调度来缓解这一问题。
信息缺口与理性看待
必须承认,这条推文的信息密度有限。没有模型参数量、没有算力规模、没有基准分数,也没有说明RL具体用于哪个阶段(预训练后的对齐、推理增强还是智能体训练)。因此,读者不宜过度外推。但它至少传递了一个方向性信号:在自建算力上跑通RL训练与推理是可行的,且在该团队的场景中,RL的收益尚未见顶。对于正在评估自建集群或加大RL投入的团队,这是一个值得留意的参考点。
随着RL在大模型研发中的权重增加,算力自主与算法 scaling 的交汇点将产生更多实践分享。我们期待后续有更详细的技术披露,来验证“未饱和”这一观察的适用范围。
相关推荐
Microsoft Fabric数据库Agent实战:从被动救火到智能侦探
深入解析Microsoft Fabric数据库Agent的功能与配置方法:如何启用、支持的监控场景、阻塞问题演示,以及从被动响应到自主运维的产品路线图。

Zendesk用ChatGPT Enterprise打造千名日活销售Agent
Zendesk向全员开放ChatGPT Enterprise,员工自行构建约600个应用,其中销售扩张智能体日均约1000名活跃用户。本文分析其如何将内部数据转化为销售机会,以及“不要等待”的落地策略。
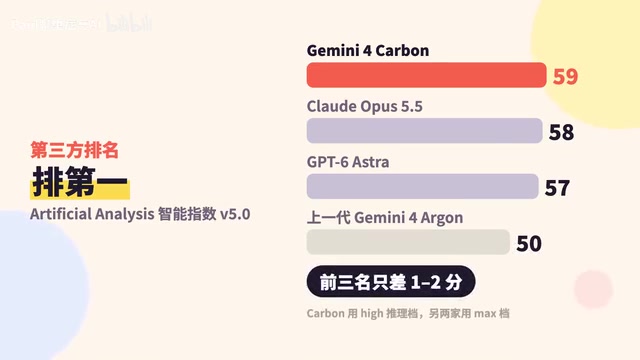
谷歌发布Gemini 4 Carbon:最强模型首发主打网络安全
谷歌发布Gemini 4 Carbon,称其为最强模型,主打网络安全能力,第三方综合排名以59分居首但领先优势仅一两分。本文解析其安全测试表现、分阶段开放策略、Token定价及自测与第三方测试在幻觉问题上的分歧。