#大语言模型
共 214 篇相关文章

当1B小模型接管驾驶:一个关于本地AI与自动驾驶的黑色幽默警示
一条Reddit帖子用黑色幽默讽刺将1B本地大语言模型接入ADAS自动驾驶系统的危险性。本文剖析LLM在安全攸关场景中的犹豫、谄媚与责任推诿三大缺陷,探讨生成式AI与自动驾驶的技术边界。

按预算选择最佳大模型:每日更新的LLM选型思路
如何在给定预算下挑选最合适的大语言模型?本文从价格、能力、延迟三个维度解析LLM选型逻辑,介绍按预算分档的实用方法,并说明「每日更新」选型工具的价值与局限。

黑客操纵ChatGPT与Gemini将用户导向诈骗网站
黑客正通过数据投毒、SEO污染与提示注入等手段操纵ChatGPT、Gemini,诱导AI将用户导向诈骗客服与假冒网站。本文解析攻击原理、危险性及平台与用户的应对之道。
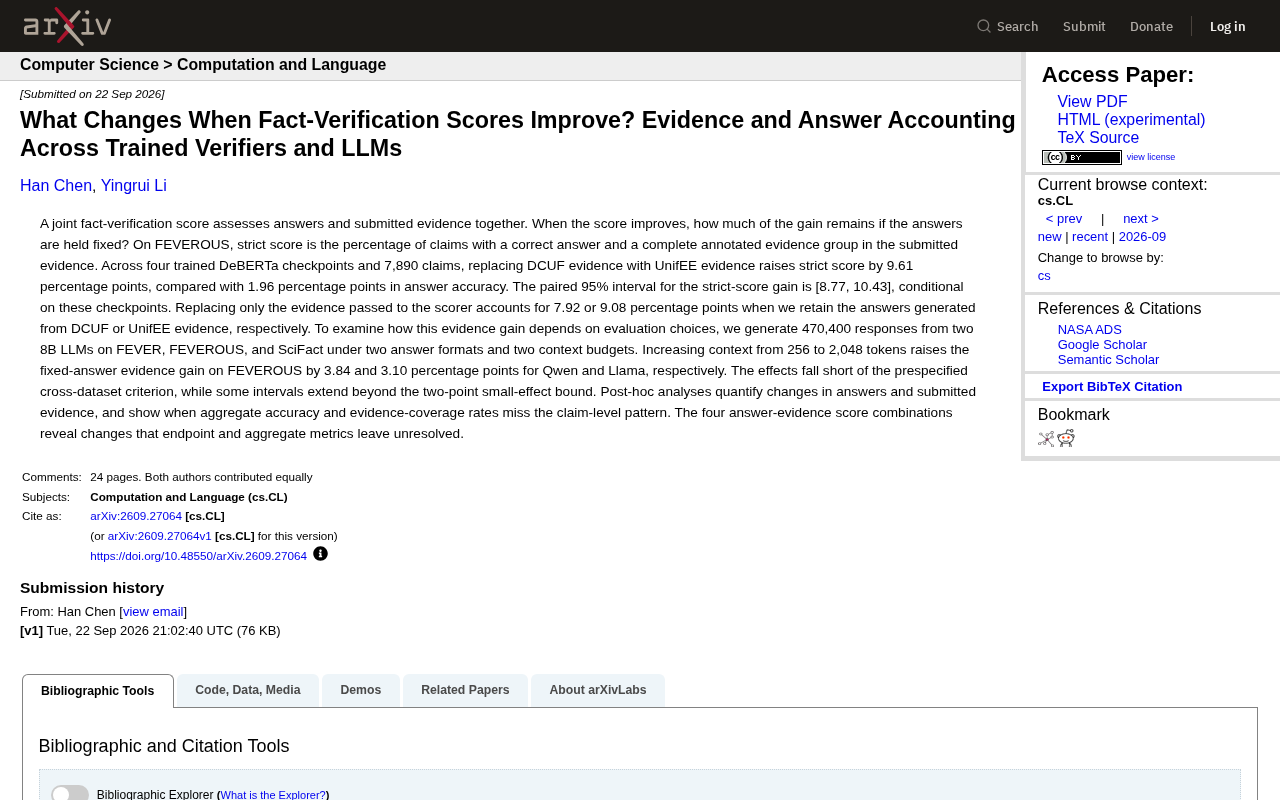
事实核查分数提升的真相:证据比答案更关键
一项arXiv研究拆解了事实核查联合分数的改善来源,发现证据替换带来9.61个百分点的严格分数提升,远超答案准确率的1.96个百分点,揭示了聚合指标掩盖声明层面变化的问题。

让AI读懂司法解释:德国宪法法院句级标注新基准
一篇arXiv最新研究提出德国联邦宪法法院判决的句级标注基准,评测大语言模型识别法律解释准则的能力。四款模型平均F1在70.4至79.2之间,语法解释最易识别,体系解释最难,GEPA优化提示未能系统性超越专家手写提示。

思维链真的在推理吗?因果测量揭示CoT忠实度真相
一篇arXiv新研究通过激活层面的因果干预测量思维链(CoT)忠实度,发现Qwen3-4B约77%的推理步骤真正承重,但传统行为学测试高估忠实度达11.4个百分点,且小模型在长推理链上忠实度大幅崩塌。

利用大模型分歧定位专家精力:LLM码本修订加速大规模标注
arXiv 最新研究提出利用大语言模型间的跨模型分歧,精准定位专家精力投入方向,加速 LLM 码本修订。实验显示理由标注方式使标注准确率达 64.9%,超越传统专家修订码本,将数月修订压缩至数天。

COMED:多模型推理中路由与协作之间的"缺失中间态"
COMED 是一种介于模型路由与密集协作之间的多 LLM 推理控制器,通过锚点自一致性、路由间隔和同伴探针实现选择性协作,在 MedQA 上提升达 10.7 个百分点,并将 GPT-5.5 从 23.1% 提升至 28.1%。

让Claude展示自己的"思维内部":一次AI自我可视化实验
一位Reddit用户让Claude展示"自己的思维内部",据称由Opus 5.5构建。本文解析这类AI自我可视化实验背后的技术真相,探讨大语言模型能否真正内省,以及机制可解释性研究的意义。

Mercury 2.5扩散语言模型:770 tokens/秒的推理速度突破
Mercury 2.5 大语言模型推理速度达到 770 tokens/秒,作为扩散式语言模型的代表,展现了并行生成架构在推理吞吐上的潜力。本文解析其技术路线、速度优势来源及需要关注的质量与成本维度。

Peerify:让AI核查同行评审论断的基准测试研究
Peerify 是一套面向学术同行评审的AI论断核查流水线,通过论断分解与证据检索判定审稿意见是否有稿件支撑。基于 NeurIPS 与 ICLR 真实评审构建 800 条论断基准,自动标注与人类共识一致率达 90.3%。

LLM评审共识的陷阱:错误相关性如何夸大证据强度
arXiv最新研究揭示LLM评审共识的隐藏陷阱:评审错误存在显著相关性,十个评审仅相当于3.5个独立评审,高达28%的系统对比结论因忽略共享错误而被夸大。文章解读错误相关性对模型评测的影响及应对方案。

AI群体协商的智慧:多样性模型讨论如何超越单体判断
arXiv新研究将人类"协商智慧"范式迁移到大语言模型,在四个领域验证:多样性模型群体讨论能超越被动汇总,而克隆模型无法获益。多样性是协商机制的关键活性成分。

目标驱动的流程变体分类:用LLM连接行为与业务目标
一篇arXiv论文提出目标驱动的流程变体分类方法,反转传统「先聚类后赋义」的工作流,先构建目标模型再用LLM将流程变体归入业务类别,在三个公开日志上验证了其有效性与可控性。

教材还是病例?数据类型如何塑造医疗大模型能力
一项 arXiv 新研究通过 token 对齐的对照实验,揭示教材数据与临床病历数据如何差异化塑造医疗大模型能力:临床数据迁移更广,教材数据偏重知识记忆,且存在知行鸿沟。医疗 LLM 数据策展应以应用为导向。
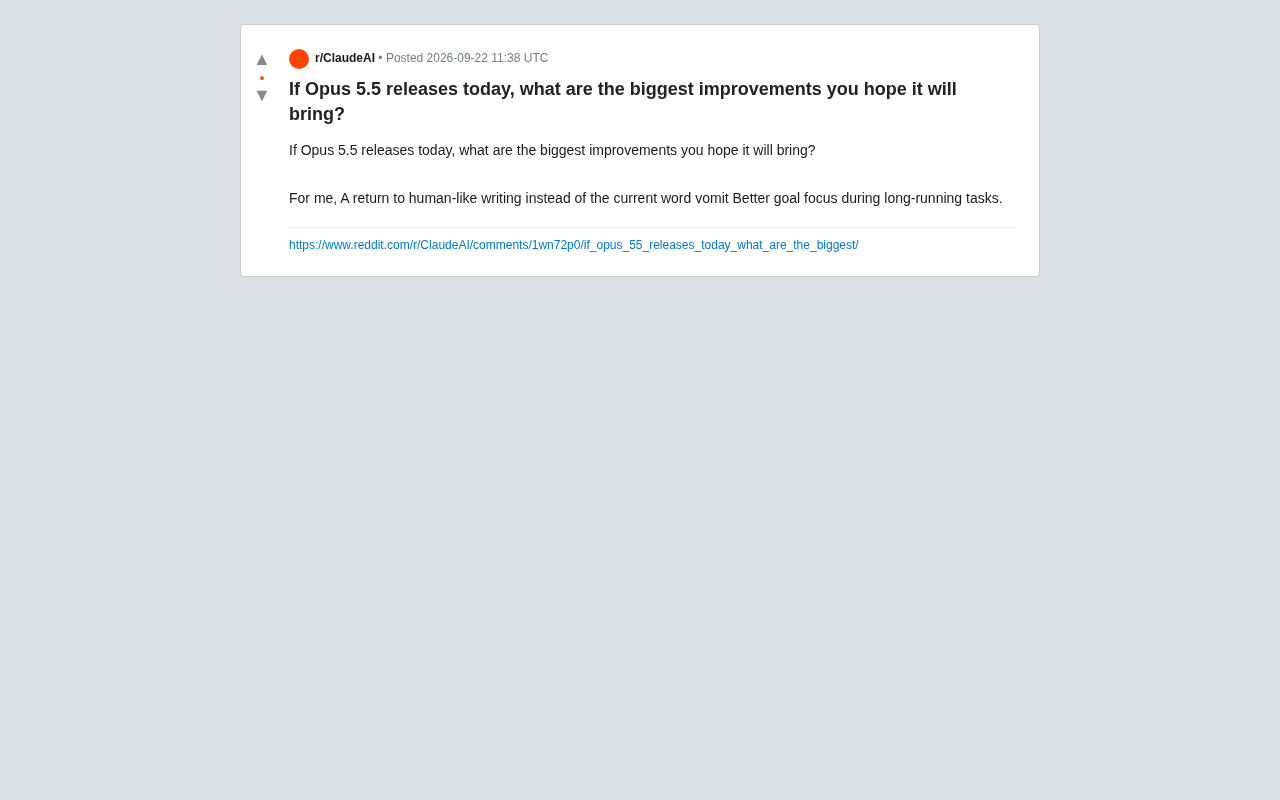
用户期待Opus 5.5改进什么?聚焦写作质量与任务专注
Reddit 用户热议 Claude Opus 5.5 最期待的改进:回归人类化写作风格、提升长任务目标专注度。本文解读这些诉求背后反映的大模型使用体验新趋势。

MiMo-v2.6-Pro深度剖析:智能、性能与价格三维评估
MiMo-v2.6-Pro大模型深度评估:从智能水平、性能表现到价格成本三个维度全面剖析,帮助你理解大语言模型选型的核心权衡框架与性价比考量。

上下文投毒:长上下文模型为何被干扰信息拖垮
arXiv 论文提出"上下文投毒"概念,将长上下文语言模型的性能退化解释为注意力中的极值干扰,指出有效干扰项数量而非原始长度才是关键,并给出证据边际需按 √logN 增长的理论边界及多种缓解方案。

DeepInstructor:用结构化学术经验驱动科研创意评估的智能体框架
arXiv 论文提出 DeepInstructor,一个基于经验图谱和 ReAct 智能体的科研创意评估框架,利用 58607 条同行评审构建结构化经验,在与人类判断对齐度上 Hit@1、Hit@2 分别提升 24.4% 和 29.7%。

LLM真有认知偏差吗?PsyAgentBench揭示三种伪装路径
PsyAgentBench 通过 41,904 次实验重新检验 LLM 智能体的经典心理学效应,发现从众、锚定等类人偏差通过标签识别、知识依赖、安全拒绝等不同路径产生,而非单一易感性。研究警示标量偏差分数的误导性。