#本地部署
共 459 篇相关文章
 教程攻略
Claude Agent SDK+LiteLLM+本地大模型:零成本搭建智能体平台
详解如何通过LiteLLM Proxy将Claude Agent SDK的API请求重定向到本地大模型,在保留完整Agent框架能力的同时将推理成本降为零。含架构设计、实战演示与企业级部署方案。
 产品体验
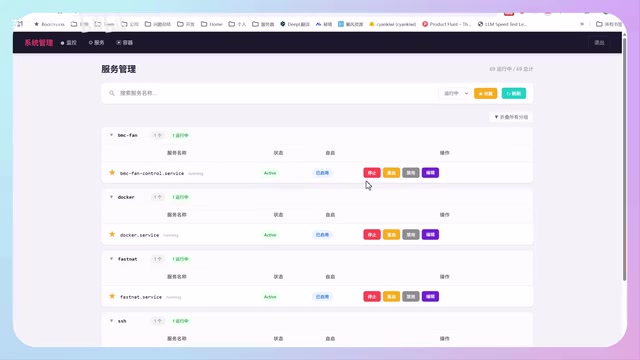
4×3080Ti本地部署千问3.6 27B跑OpenCode编程实测
使用4张3080Ti 16G魔改显卡本地部署千问3.6 27B FP8模型,配合OpenCode完成系统管理工具开发的完整实测。涵盖硬件配置、推理速度、上下文管理经验及开发效率对比。
 教程攻略
Ollama本地部署大模型完全指南:断网也能用的AI
详解Ollama本地部署开源大模型的完整流程,涵盖安装配置、模型选择、显存要求及实际效果对比。支持Llama 3、通义千问等主流模型,零成本、断网可用,轻松打造私有AI工作站。
 教程攻略
Bolt.diy本地部署教程:免费开源的AI全栈开发工具
Bolt.diy是Bolt.new的开源替代方案,支持自由接入OpenAI、Claude等大模型,本地部署零订阅费。本文详解安装配置流程、模型选择方案及适用场景,助你低成本实现AI全栈开发。
 教程攻略
Ollama本地部署大模型教程:安装配置到API调用全流程
详解Ollama本地部署开源大模型的完整流程,涵盖安装配置、模型选择与量化策略、Python代码调用API、性能优化等实战技巧,帮你快速在本地运行Qwen、Llama等大模型。
 教程攻略
6分钟本地运行Claude Code泄露版教程(零基础可上手)
详细图文教程教你6分钟内本地部署运行Claude Code泄露版,无需编程基础,通过Trae IDE和MiniMax API即可完成安装配置,体验专业级AI编程能力。
 产品体验
DeepSeek V4深度解析:编码能力全面超越GPT-4.0的三大核心技术
DeepSeek V4模型深度技术解析:百万级上下文窗口、N-gram记忆架构、MHC流形约束超连接三大突破,编码基准全面超越Claude和GPT-4.0,成本仅为竞品十分之一,支持双RTX 4090本地部署。
 教程攻略
免费使用Claude Code:CC Switch+Ollama本地模型驱动AI编程Agent教程
详细教程教你通过CC Switch将本地Ollama模型伪装成Claude API,零成本驱动Claude Code桌面版进行AI编程。涵盖安装配置、模型选择、实测效果,支持千问、Gemma等开源模型。
 教程攻略
Docker Model Runner使用教程:一条命令本地运行AI模型
详解Docker Model Runner的安装配置与实战用法,通过Docker Compose集成本地AI模型,兼容OpenAI API接口,实现零配置本地部署LLM大模型,附完整聊天应用开发示例。
 产品体验
QwenCoder本地部署实测:能否替代付费AI编程助手?
实测QwenCoder 80B本地部署效果,对比Gemini、Claude等付费AI编程工具。详解硬件配置、LM Studio部署方案及实际编程能力测试结果,帮你判断本地模型能否省下AI订阅费。
 教程攻略
DeepSeek本地部署教程:Ollama一键安装运行指南
详细讲解如何通过Ollama在本地部署DeepSeek R1大模型,包括安装步骤、模型版本选择、硬件配置要求及进阶玩法,零基础10分钟搞定私有化AI部署。
 教程攻略
本地部署大模型怎么判断显存爆了?一文看懂显存监控方法
本地部署大模型时如何判断显存是否爆满?本文详解专用显存与共享GPU内存的区别,教你通过任务管理器快速判断显存溢出,并提供模型量化、上下文长度控制等避免爆显存的实用建议。
 产品体验
Qwen3.6量化版本地部署实测:NVFP4、APEX、Q4、Q6哪个最值得选
实测Qwen3.6系列7-8个量化模型在工具调用、命令行操作、Bug修复、数学推理等8大维度的表现,对比NVFP4、APEX、Q4、Q6量化方案,附总分排名与选购建议,帮你找到最适合本地部署的量化版本。
 科技前沿
Qwen3.6 35B开源实测逼近Claude,xAI语音克隆API正式上线
阿里开源Qwen3.6 35B模型,256专家MoE架构仅需3B激活参数,SWE Bench成绩逼近Claude Opus。xAI发布Voice Cloning API支持28种语言,NVIDIA开源OpenShell安全沙箱,Sam Altman表态模型智力优先。
 教程攻略
Hermes + Qwen3.6 本地部署教程:零成本搭建私有AI Agent
详细教程教你用Hermes Agent搭配Qwen3.6开源大模型,在本地零成本部署私有AI助手。涵盖WSL环境配置、模型下载启动、Telegram机器人对接及开机自启设置,实现无限Token、数据私有的AI Agent体验。
 教程攻略
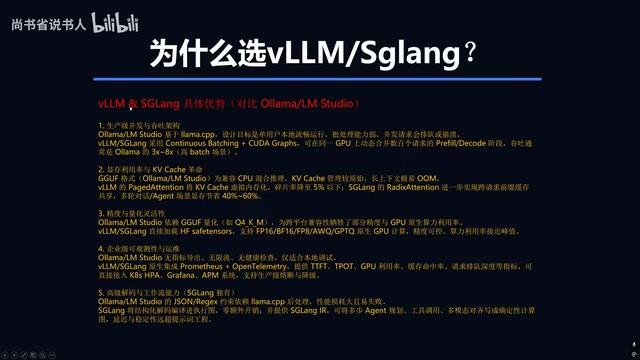
vLLM与SGLang本地部署教程:性能提升3-8倍的实战指南
详解vLLM和SGLang本地部署全流程,对比LM Studio性能差距,通过Docker+AI助手三步完成部署。涵盖SGLang与vLLM选型建议、5090显存优化、Qwen3模型推荐及Cherry Studio接入方法。
 科技前沿
悟空2.2P开源:35B MOE模型性能超越Qwen3.6-27B,速度快3-5倍
悟空2.2P 35B MOE模型正式开源,采用对抗式杂交蒸馏技术,综合性能超越Qwen3.6-27B。4090显卡Q5量化达158 tokens/s,仅需8.9G显存即可运行,支持256K上下文。详解核心技术、硬件配置与实测数据。
 科技前沿
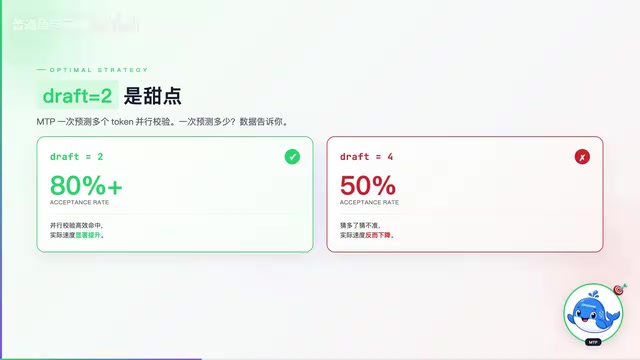
Qwen3.6 MTP加速实测:单GPU推理飙到220 token/s
Qwen3.6实验性MTP-GGUF版本实测,单GPU将35B-A3B模型推理速度提升至220 token/s,比原版快1.4倍且精度零损失。详解MTP原理、最优Draft Tokens策略及RTX 5090实测数据。
 教程攻略
本地部署DeepSeek+RAG知识库教程:Ollama+RAGFlow保姆级指南
手把手教你用Ollama本地部署DeepSeek大模型,结合RAGFlow搭建RAG私有知识库。涵盖环境配置、Docker部署、Embedding原理讲解,支持离线运行,保障数据隐私,轻松实现企业级智能问答。
 教程攻略
RAGFlow本地部署教程:Docker搭建企业级RAG知识库全流程
详解RAGFlow本地部署全流程,涵盖RAG技术原理、Docker环境配置、Ollama大模型接入、知识库创建与对话测试。手把手教你从零搭建企业级知识库问答系统,实现数据私有化部署。