#语音合成
共 27 篇相关文章
可控语音合成:让有声书角色声音更生动一致
可控文本转语音技术让有声书语音更具表现力,角色声音更清晰一致。本文分析其技术逻辑、对有声书制作流程的影响及当前局限。

503段语音的丛雨桌宠:开源可自定义,一点就喊「狗修金」
B站开发者将《千恋*万花》丛雨做成开源桌面宠物,内置503段语音合成台词,点击即播放「狗修金」,支持顺序/随机/重复三种模式、语音收藏过滤、多角色自定义与按库保存配置。
v0.40.9 更新:正式支持 Gradium Phonon GA 检查点
开源语音推理项目 v0.40.9 更新解析:Gradium Phonon 检查点从预发布格式切换至 GA 正式格式,新增默认音色导入与语音条件控制,最低版本要求提升至 0.40.9,旧检查点将被拒绝加载。
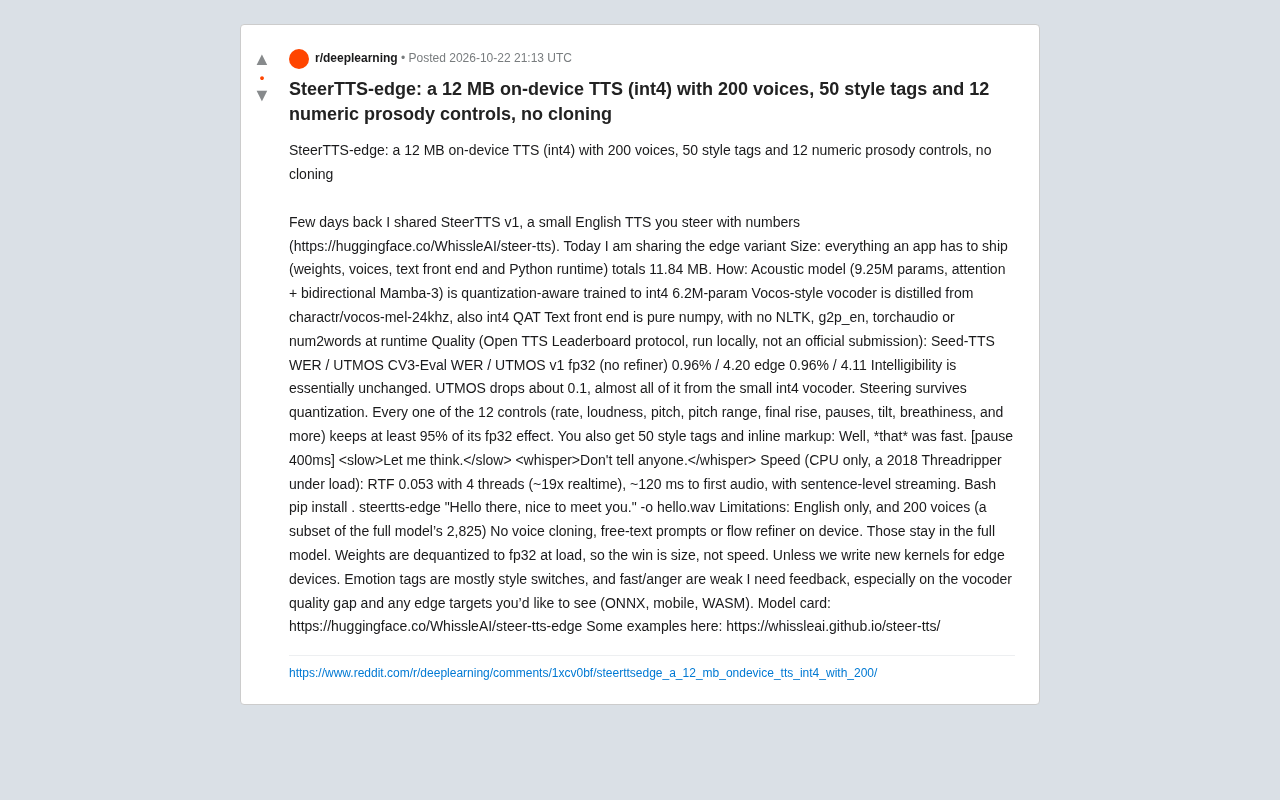
12MB端侧TTS新选择:SteerTTS-edge支持200音色与50种风格
SteerTTS-edge是仅有12MB的端侧TTS模型,采用int4量化感知训练,支持200种音色、50种风格标签和12项数值韵律控制,英语场景下RTF 0.053,适合移动端与嵌入式部署。

11.84MB可调控TTS模型发布:WER不变,UTMOS仅降0.1
WhissleAI发布SteerTTS边缘版,全部打包仅11.84MB,WER保持0.96%不变,UTMOS仅下降约0.1,支持12维数字调控与50种风格标签,CPU上19倍实时。

ElevenLabs实时翻译:90+语言同传,单一WebSocket搞定语音到语音
ElevenLabs 推出 Realtime Translation 实时翻译产品,支持 90+ 语言,通过单一 WebSocket 将实时语音转为带情感的目标语言音频,保持音色一致,面向电信、呼叫中心和现场活动场景。

1.9M参数语音克隆TTS引争议:Kyutai新模型被指自审查
Kyutai Labs 的 Pocket TTS 以 1.9M 参数支持语音克隆,体积惊艳但被用户发现新模型会自动过滤脏话。GitHub issue 被标记 not planned 关闭,引发社区对开源模型内置审查的争议。本文分析其技术意义、过滤层位置之争及轻量 TTS 的竞争格局。

用ElevenLabs API快速构建AI语音信箱生成器
本文介绍如何用ElevenLabs API构建语音信箱生成器,涵盖API密钥获取、Python与Node.js实现、模板填充、声音克隆和Flask部署,帮助开发者快速将文本转为高质量MP3语音留言。

用ElevenLabs构建交互式音频故事生成器
手把手拆解如何用语言模型加ElevenLabs TTS搭建交互式音频故事生成器:从提示词生成带角色标签的剧本,到声音克隆、Flask后端合成、React前端顺序播放,附延迟、成本与安全优化建议。
用ElevenLabs打造语音无障碍工具:TTS与声音克隆实战
基于ElevenLabs平台,从零搭建语音无障碍工具的完整教程:涵盖语音识别、文本转语音、声音克隆三大模块,附Python与JavaScript代码示例、端到端流程、边界情况处理与部署建议。
独立开发者如何用Flask打造多语言AI语音聊天应用
独立开发者用 Flask、GLM 和 faster-whisper 构建支持 24 种语言、自定义角色的 AI 语音聊天应用 IboChat。本文解析其三级语音管线、单 GPU 双模型冲突的解决方案、冷启动降级策略与真实成本,为 AI 语音应用开发者提供可复用的工程经验。

TTS 应用边界情况处理实战:长文本、表情符号与限流
TTS 应用上线后常见边界情况如何处理:长文本切分与停顿拼接、表情符号和 Markdown 清洗、429 限流指数退避重试、语音克隆生僻词 SSML 标注,以及生产环境健康监控,附 Python 与 curl 实战示例。

Fish Audio发布Drama 3:35B开放权重MoE语音合成模型
Fish Audio发布Drama 3,35B参数MoE文本转语音模型,激活参数约3B,覆盖83种语言,开放权重采用营收上限社区许可,支持自然语言指令控制语音风格。

免费与付费TTS API对比:开发者选型指南
对比免费与付费 TTS API 的取舍:Google、Amazon、Azure、eSpeak 与 ElevenLabs 的音色、延迟、价格差异,附选型七维度与 Python 集成示例,帮助开发者做出生产级决策。

Fish Audio Drama 3 登陆 AI Gateway:用自然语言导演语音表演
Fish Audio 文本转语音模型 Drama 3 上线 AI Gateway,支持用自然语言指令导演语音情绪与节奏,可标注 whisper、emphasis 标签,支持多语言指令和多角色对话,30 天内享 80% 折扣。

构建可扩展语音合成系统:生产级TTS架构实战
一套生产级可扩展TTS语音合成系统的完整架构实战:涵盖API网关、任务队列、合成Worker、缓存与流式交付,附Python与JavaScript代码示例及扩展、监控、成本控制要点。

ElevenLabs + React 实战:打造语音交互界面
手把手教你用 React 和 ElevenLabs 构建语音交互 UI:封装 useElevenLabs Hook、实现文本转语音回放、接入声音克隆,并附上限流、移动端自动播放与 API Key 安全等实战踩坑指南。
ElevenLabs发布Eleven v4与v4 Turbo:更快更富情感的语音模型
ElevenLabs推出Eleven v4与Eleven v4 Turbo两款AI语音模型,前者主打情感表现力,后者专为实时场景优化。本文解析两款模型的定位差异、应用场景及对开发者和创作者的意义。

Firebase AI Logic 集成 Gemini TTS:多说话人语音合成实战
Firebase AI Logic 现已支持 Gemini 文本转语音(TTS)模型,提供多说话人语音配置能力。开发者可为不同角色映射不同音色,在单次调用中生成无缝多角色对话音频,无需管理复杂音频管线。
Gemini 3.8 Flash TTS发布:定制语音与规模化部署双管齐下
Gemini 3.8 Flash TTS发布:定制语音与规模化部署双管齐下
Google发布Gemini 3.8 Flash TTS与Flash-Lite TTS两款文本转语音模型,前者支持定制独特口音与语音特征,后者面向高效率大规模部署,为开发者提供从设计到落地的完整语音方案。