#AI伦理
共 147 篇相关文章

教皇良十四世呼吁AI“裁军”:机器是工具而非人
教皇良十四世在周五讲话中呼吁AI系统应被“解除武装”,强调机器是工具而非人,并敦促联合国成员国在下月日内瓦会议上采取具体步骤禁止致命性自主武器。

肯塔基男子成首位获AI宗教豁免的人文主义者
肯塔基州一名男子以人文主义信仰为由,成为首位获得宗教豁免、免于使用AI的人。本文梳理事件脉络、Hacker News上的争议焦点,以及它对组织AI政策与个人自主权边界的启示。
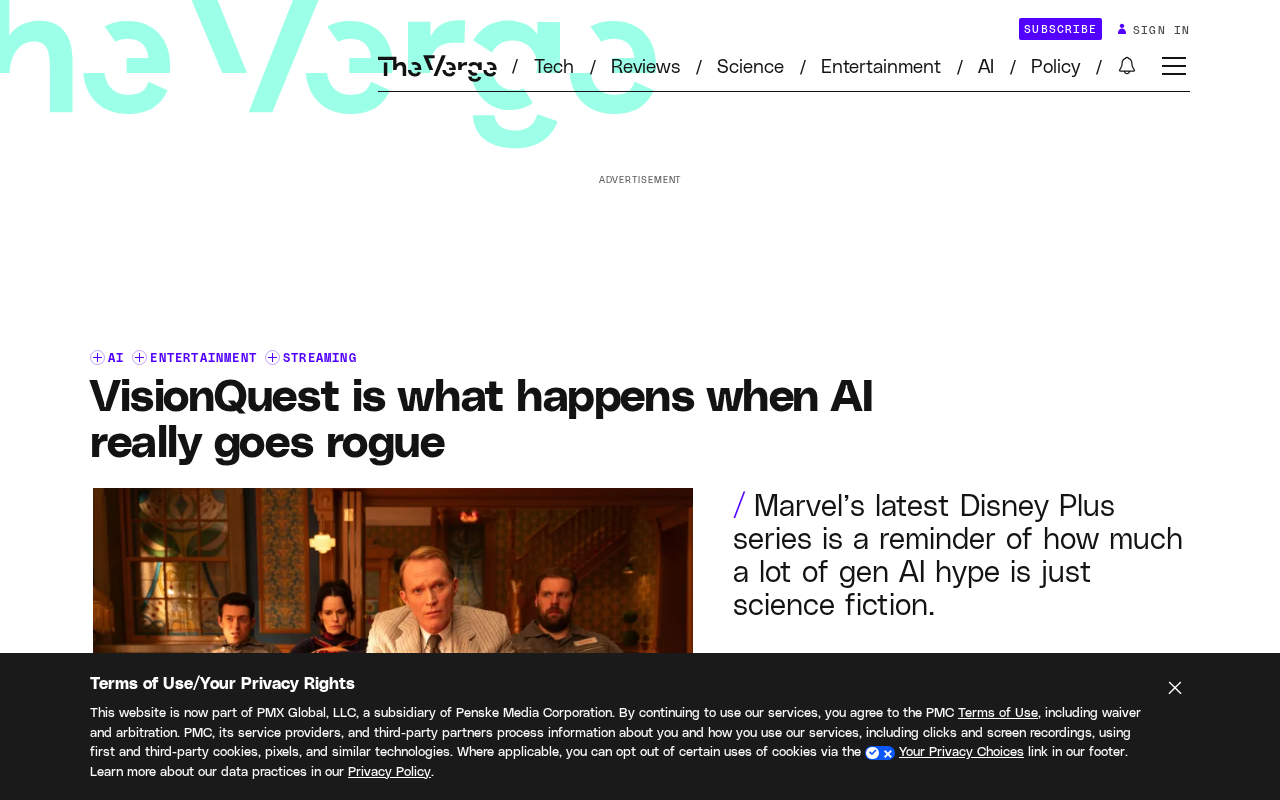
VisionQuest:当AI真正失控,漫威新剧如何映射现实焦虑
漫威新剧《VisionQuest》讲述超能力机器人沉迷数字白日梦、试图理解人性的故事。本文分析剧集如何映射生成式AI讨论中的“失控”“自主”与“理解”等核心议题。
AI伪造论文实验:免费工具攻不破的防线
IEEE Spectrum记者用免费ChatGPT和Gemini伪造论文,又用自主研究系统FARS生成真实研究论文,两次投稿IEEE Access均被拦截。实验揭示AI垃圾论文的检测困境、同行评审的超载危机,以及自动化研究对科学出版体系的根本挑战。

ChatGPT 为何总把技术支持问题误判为新闻线索?
404 Media 的 Jason Koebler 发现,由于大厂缺乏人工客服,用户转向 ChatGPT 求助,而 ChatGPT 会将普通技术问题误判为新闻线索并推荐联系媒体。本文分析这一现象背后的模型局限与产品边界问题。
AI安全讨论的盲区:日常伤害与核动力太空竞赛
《The Download》最新一期聚焦AI安全的讨论盲区:过度关注灾难性风险遮蔽了日常伤害,同时关注核动力太空飞行竞赛。本文分析注意力错配的代价与技术治理的结构性难题。
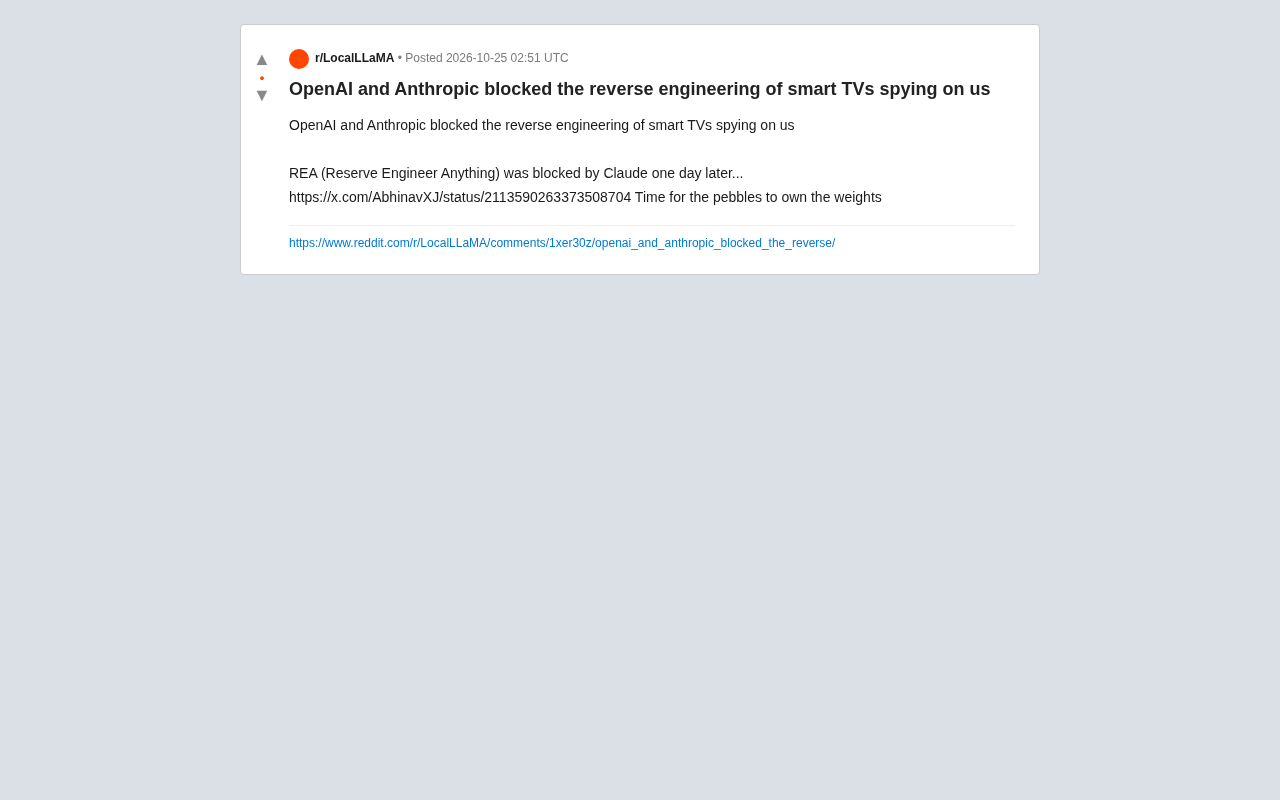
OpenAI与Anthropic限制智能电视逆向工程,引发AI伦理争议
OpenAI与Anthropic限制智能电视逆向工程项目REA,引发AI安全与开放研究争议。本文分析事件背景、隐私隐患及AI公司的使用政策,探讨平衡之道。
AI模型政治倾向研究:Grok与GPT在选举推荐中分歧超90%
新研究发现Grok模型在近500场选举中压倒性推荐共和党候选人,OpenAI的GPT则倾向民主党,两者推荐结果分歧率超过90%。本文分析模型政治倾向的技术根源与行业影响。

MIT讲座:法律学者谈用AI拯救与超越民主
MIT Compton Lecture上,法律学者Martha Minow警告AI可能导致“启蒙的丧失”,主张民主既要借助AI提升参与和透明度,也需以制度与公民空间超越算法逻辑,防止技术掏空民主实质。
生成式AI如何助长跨国镇压:技术滥用的新前沿
生成式AI正在降低跨国镇压的门槛:批量生成恐吓内容、语音克隆伪造亲属求助、深度伪造摧毁异见者信誉。本文分析AI如何让国家支持的跨境骚扰规模化,以及为何这一问题在技术社区中被低估。
所有AI模型为何对“人类”持相同争议观点?
解读ModelCompare.ai博客在Hacker News引发热议的发现:几乎所有主流AI模型在涉及人类价值判断的问题上给出高度一致的回答。分析RLHF对齐训练导致的趋同现象,以及这对AI开发者意味着什么。

谷歌AI军事合同引员工离职潮:伦理与商业的碰撞
谷歌因AI军事合同遭遇员工离职抗议,本文分析事件背景、历史渊源及行业影响,探讨科技公司在AI伦理与商业利益间的平衡难题。

把AI当有意识会更危险吗?学界激辩模型福利
Anthropic为退役模型开博客引发争议:微软AI CEO Suleyman警告模型福利研究可能让AI更难控制,Berg、Seth、Mitchell等研究者则从内部状态实验、假阳性风险与训练副作用展开激辩。

Opus 5.5拒绝代写论文段落:AI护栏为何获用户点赞
Reddit用户分享Opus 5.5拒绝代写论文段落的经历:模型识别学校AI使用限制、解释学术诚信风险,并将决定权交还用户。这种“有解释的拒绝”为何被用户称为理想护栏?本文分析AI护栏设计的三层逻辑与产品启示。

Meta的AI模拟人生:当模型活在“楚门的世界”
Meta让数百万AI智能体生活在模拟人生中,它们以为在跟真人交流,实际对话对象全是AI。当智能体识破真相时会被删除。这一实验源自Meta的MUSE设备端智能体研究,引发AI意识与实验伦理争议。

开源促进会转向政治 activism:OSI 使命变革引发争议
开源促进会(OSI)将政治 activism 纳入核心使命,签署联合国开源原则并推行 RISE 框架,引发社区争议。本文分析其背景、争议点及对开源生态的影响。

AI代写Slack回复:效率背后的信任赤字
一位基础设施负责人用ChatGPT代写Slack技术回复,暴露出AI生成内容在上下文理解和专业深度上的缺陷。本文分析AI回复如何侵蚀团队信任、导致批判性思维退化,并给出将AI作为草稿工具、审核个性化、高风险场景绕开AI的平衡方案。

Anthropic拟IPO前设公益基金,5%股权能否化解AI舆论危机?
Anthropic在IPO前宣布将5%股份划入公益基金,并设计估值挂钩的动态增配机制。本文拆解其股权划拨、动态贡献与信任建设三层设计,分析股东批准、基线透明度与监管三大暗礁,评估这一举措能否真正化解AI公众舆论危机。

