AI大模型面试深度指南:Agent架构与项目实战

三个月系统学习Agent、提示工程与RAG,用实战项目在面试中讲出深度。
文章针对大模型岗位面试中“讲不出深度”的痛点,提出一套三个月学习路线。作者强调面试官考察的是对Agent架构、提示工程和RAG全链路的底层理解,而非工具堆砌。第一个月打基础,搞懂大模型与Agent的区别及组件原理;第二个月专攻提示模板设计与RAG的切片、向量化、召回、重排序全流程;第三个月完成两到三个从用户调研到MVP的完整项目。文章还以LangChain等框架为例说明如何通过技术选型对比体现思考深度,并提醒求职者避开速成噱头,用“笨功夫”沉淀真正的面试竞争力。
面试大模型岗位时,如何讲出深度是许多求职者的痛点。B站UP主在视频中分享了一套从零到拿下AI产品offer的完整学习路线,强调普通人需要三个月的扎实沉淀,而非被“三天上手”的标题党带偏。本文结合该路线,拆解如何通过系统学习Agent架构、提示工程、RAG知识库和实战项目,在面试中展现真正的技术深度。
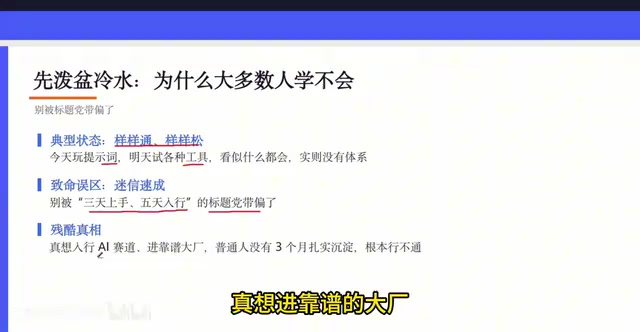
为什么面试需要“深度”而非“广度”
许多初学者今天玩提示词、明天试各种工具,最后却“样样通样样松”。UP主指出,普通人没有三个月的扎实沉淀根本行不通。面试官考察的并非你用过多少工具,而是你是否理解大模型与Agent的本质区别、能否设计稳定的提示模板、是否清楚RAG的全链路。深度意味着你能讲清底层原理,而非停留在API调用层面。
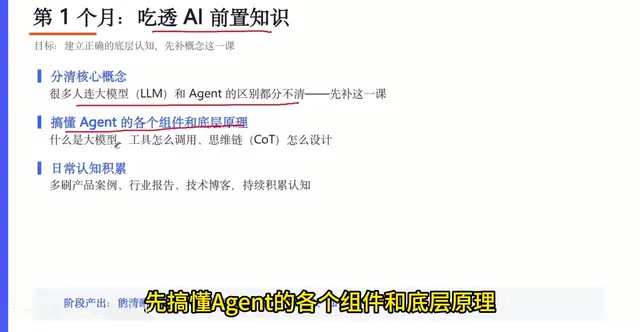
三个月学习路线:从基础到实战
第一个月:吃透AI前置知识
UP主建议前期每天固定两小时打牢基础。第一个月重点搞懂大模型和Agent的区别,理解Agent的各个组件和底层原理,包括工具如何调用、思维链如何设计。同时多刷产品案例、行业报告和技术博客,持续积累认知。面试中常问“Agent架构包含哪些模块”,若能清晰阐述规划、记忆、工具使用等组件,便已超越多数候选人。
思维链(Chain of Thought, CoT) 是让大模型在给出最终答案前,先输出一步步推理过程的提示技术。其核心价值在于把复杂问题拆解为中间步骤,从而提升多步推理任务的准确率。在Agent场景中,思维链不仅是提示技巧,更是规划组件的工作基础:Agent需要先“想清楚”要做什么、分几步做,再决定调用哪些工具。面试中若被问到“如何设计Agent的推理流程”,能说明CoT与ReAct(推理+行动交替)的区别、何时该用显式推理、何时该直接调用工具,就能体现对底层机制的理解,而非只会写一句“Let's think step by step”。
第二个月:专攻Agent核心能力
第二个月聚焦提示工程的底层逻辑和架构设计,站在产品视角做出稳定、可复用的提示模板。同时深入RAG(检索增强生成),弄懂它到底解决什么问题,并完整掌握文本切片、向量化、召回、结果重排序的全流程。UP主强调,这是面试中区分“会用”和“懂行”的关键。
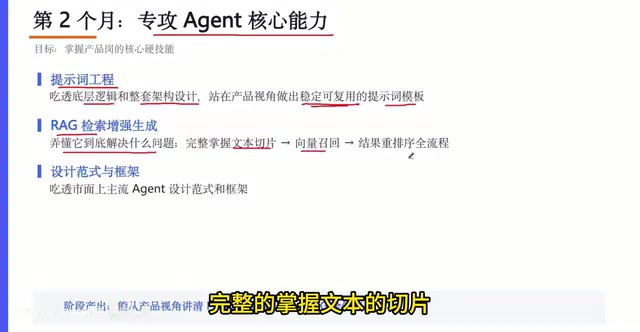
RAG全链路中的向量化与重排序 是面试高频追问点。向量化指用嵌入模型把文本切片映射为高维向量,使语义相近的内容在向量空间中距离更近;召回阶段通常用近似最近邻(ANN)索引快速取回Top-K片段。但召回只保证“相关”,不保证“最有用”,因此需要重排序(Rerank):用交叉编码器对查询与候选片段逐对打分,把真正能回答问题的片段排到前面。理解这两步的分工——嵌入模型决定召回上限,重排序决定最终精度——并知道切片粒度、重叠窗口、Top-K取值如何影响效果,才算真正掌握RAG,而不是停留在“把文档丢进向量库”的层面。
第三个月:产出可落地的实战项目
第三个月是重中之重:结合所学知识,挑合适场景做两到三套项目实战,走完用户调研、需求梳理、输出PRD、画产品原型,最后用Web Coding做出可演示的MVP。UP主认为,完整落地一遍你才算具备拿高薪offer的硬实力。面试时,能展示从0到1的项目闭环,远比罗列工具更有说服力。
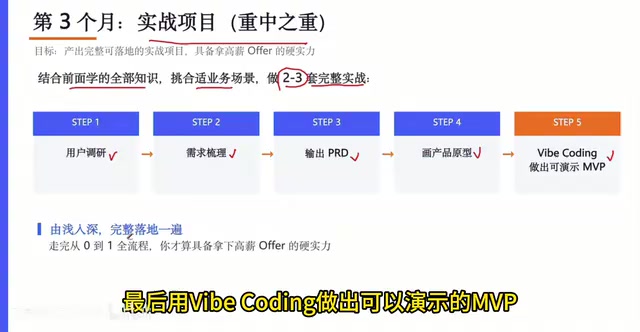
MVP(最小可行产品) 指用最小成本做出能验证核心价值、可演示的产品版本。对大模型岗位求职者而言,MVP的意义不在于功能完整,而在于证明你具备从需求到落地的闭环能力:能定义问题、选择合适的技术方案、控制范围并做出可交互的 Demo。面试官关注的是你如何在资源有限时做取舍——哪些功能必须保留、哪些用规则或现成API替代、如何评估效果。一个能讲清“为什么这样设计MVP”的候选人,比罗列十个工具的人更能体现产品思维与工程判断力。
面试中如何讲出深度:以OpenClaw和LangChain为例
视频标题提及OpenClaw广告应用和LangChain开发,虽正文未展开,但可推断面试官期望候选人能对比不同框架的设计哲学。例如,LangChain提供了链式调用和Agent执行器,而OpenClaw可能侧重某类场景的优化。深度回答应包含:为何选择该框架、其组件如何协作、遇到哪些坑及如何解决。UP主反复强调“站在产品视角”,意味着不仅要懂技术,还要解释技术选型对用户体验的影响。
LangChain 是围绕大模型应用开发的开源框架,核心抽象包括Prompt模板、Chain(链式调用)、Memory(记忆)、Retriever(检索器)和Agent执行器。它的优势是生态丰富、组件可组合,缺点是抽象层较厚,调试时容易“黑盒化”。对比框架时,面试官真正想听的是设计哲学差异:是偏重声明式编排还是代码优先、记忆与工具调用如何解耦、错误处理与可观测性如何实现。回答时结合自己项目中的选型理由、迁移成本和踩坑经验,比背框架文档更能体现深度。
避坑指南:别被速成噱头带偏
UP主直言,90%想学AI的人都在等接近——以为学一两个知识点就能拿高薪,宁愿相信速成的噱头也不愿踏实动手。这套路线不适合只走捷径的人。面试中的深度,恰恰来自那些“笨功夫”:手写提示模板、调试RAG召回、反复迭代MVP。若你正备考大模型岗位,不妨按此路线用三个月沉淀,把每个知识点讲成故事,而非背诵答案。
相关推荐

Cloudflare开源AI代码安全审计工具,获6万星
Cloudflare开源Security Audit,为AI编码Agent提供免费安全审计。三步工作流:应用测绘、多Agent对抗找Bug、三级分类报告,源自内部漏洞狩猎系统,近6万星标。

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。