AI大模型微调全流程实战:十三课从数据到落地

B站十三课时微调课程覆盖原理、数据工程与三大场景项目。
本文梳理了B站一套十三课时的大模型微调实战课程框架。课程分三阶段递进:先讲高效微调、强化学习等底层原理与数据工程方法,再以项目驱动方式落地RAG嵌入模型微调、大模型蒸馏小模型、自然语言数据分析三个典型场景,最后用金融行业综合项目整合所学。文章强调数据工程是微调效果的地基,全流程演示的价值在于从需求分析到效果评估的闭环迭代。同时提醒该内容本质为付费课程推广,十三课时深度有限,更适合作为系统入门参考,并建议自学者借鉴其框架保持闭环意识。
大模型微调是让通用模型适配业务场景的关键技术,但多数教程要么偏重理论,要么只演示单一环节。近期,B站上有一套十三课时的实战课程,尝试把微调从原理到项目落地的完整链路讲清楚。本文基于该课程内容,梳理其教学框架与核心方法论,供正在寻找微调入门路径的开发者参考。
课程框架:三阶段递进
据课程介绍,整套内容分为三个大的阶段。第一阶段聚焦原理性知识,涵盖高效微调、强化学习等技术的底层机制;第二阶段挑选了后训练(post-training)中的几个典型场景,以项目驱动方式手把手落地;第三阶段则是一个综合性的金融行业项目,课程称共讲了76节课才完整解释清楚。
这种递进设计的逻辑在于:先建立对训练原理的理解,再通过场景化项目积累手感,最后在复杂业务中整合所学。对于自学者而言,明确的学习路径往往比零散的技术点更有价值。
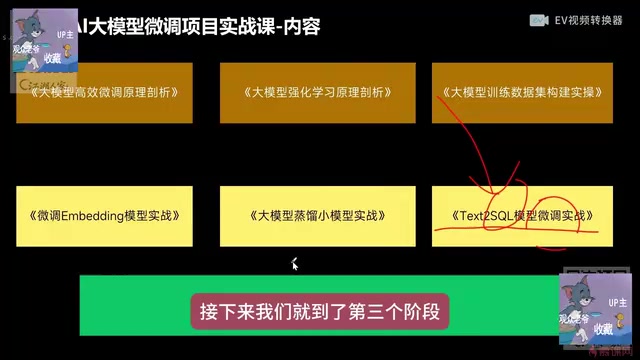
原理与数据工程:微调的地基
课程强调,无论做强化学习、高效微调还是后训练,有一个环节必不可少——数据工程。课程将其描述为“怎么把这些数据变成有价值的序列数据集”,并称会深入讲解其中的方法论和要求。
这一判断符合工程实践。微调效果的上限很大程度上由数据质量决定,指令格式、样本分布、去重与清洗策略都会直接影响模型行为。很多微调项目失败,问题并不出在训练脚本,而是数据准备阶段就埋下了隐患。
在微调语境下,"序列数据集"通常指将原始语料转换为模型可消费的输入-输出对,其格式由训练目标决定:指令微调需要构造指令-响应对,蒸馏需要教师模型的输出作为标签,嵌入模型微调则需要正负样本对。序列化过程涉及截断长度、padding策略、特殊token插入等细节,这些细节会直接影响模型学到的分布。此外,数据工程还包括样本去重(避免训练集泄漏)、难度分层(防止简单样本主导梯度)以及质量过滤(剔除低质或有害内容)。业界常用做法是先做小规模人工校验,再借助规则或模型打分做批量清洗,最后按任务难度和类型分层采样,以平衡训练效率与泛化能力。
三大典型场景:嵌入模型、蒸馏与数据分析
第二阶段的场景选择颇有代表性。第一个是RAG知识库场景下的嵌入模型微调——当嵌入模型的检索准确率不够理想时,对嵌入模型本身进行微调是常见解法。课程以项目驱动的方式演示这一流程。
第二个场景是蒸馏。企业落地时算力资源往往有限,需要与业务能力匹配的小模型,课程演示如何基于大模型蒸馏出可用的小模型。
第三个场景是智能分析:用自然语言提问,借助大模型生成分析代码来完成数据分析。但开源模型在这类任务上的能力偏弱、准确率较低,因此需要微调来提升表现。这三个场景分别对应检索、压缩和生成分析三类真实需求,覆盖面较广。
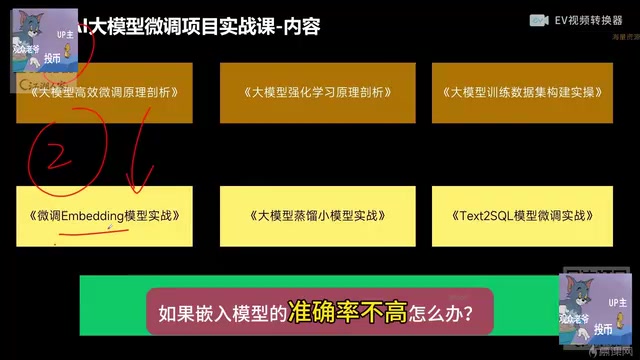
嵌入模型微调与生成式模型微调在目标和方法上有本质区别。嵌入模型输出的是向量表示,训练通常采用对比学习框架:将语义相近的样本对作为正例、不相关的作为负例,通过拉近正例距离、推远负例距离来优化检索排序能力。常见做法包括使用难负例挖掘提升区分度,以及用多任务数据混合训练防止过拟合。评估上不看loss而看检索指标,如Recall@K、MRR等。因此,当RAG检索不准时,先要判断是嵌入模型语义区分力不足,还是切分策略或索引结构的问题,再决定是否值得投入微调。
知识蒸馏的核心是让一个小模型(学生)模仿大模型(教师)的行为。常见形式包括响应蒸馏(用教师生成的答案作为监督信号)和逻辑蒸馏(对齐输出概率分布或中间层表示)。在企业落地中,蒸馏的价值在于把大模型的业务能力迁移到参数量更小、推理成本更低的模型上。但蒸馏并非简单复制:学生模型容量有限,需要在数据配比、温度参数和损失函数上做权衡,同时警惕教师模型的错误被一并继承。实践中通常需要保留一部分真实标注数据做校准,并对蒸馏后模型在关键场景上做专项评估。
全流程演示:从需求到评估的闭环
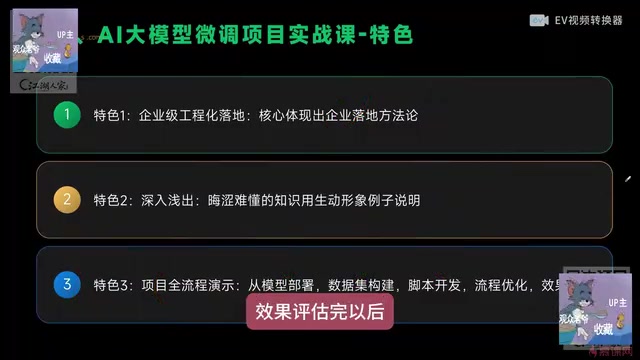
课程宣称的一大特色是全流程演示:从需求分析、技术选型,到开源模型下载与部署、数据集构建、脚本开发、流程优化,再到效果评估。课程特别提到,评估后若未达预期,会分析原因并重新走一遍流程。
这个闭环恰恰是实际项目中最容易被跳过、也最考验工程师能力的部分。多数教程止步于“训练完成、loss下降”,而真实落地需要反复迭代:定位是数据问题、超参问题还是评估口径问题。课程把这一迭代过程纳入演示,对学习者有实际参考意义。
课程特色与适用人群
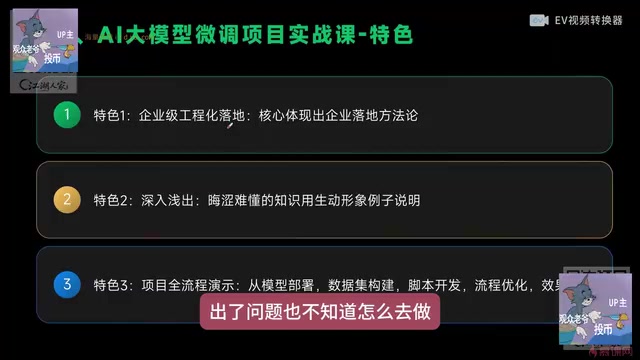
课程总结了两个特色:一是工程化落地导向,会总结企业落地的方法论;二是深入浅出,用通俗语言和生动例子讲解高效微调、强化学习、蒸馏中绕不开的底层原理。课程还提供课件、代码、手册、数据和脚本等配套材料。
适用人群方面,课程列出三类:想深入学习强化学习、高效微调、蒸馏等技术的学习者;想通过高价值项目充实简历、求职AI岗位的人;以及已有AI大模型基础、希望从初级或中级水平向中高级提升的从业者。
客观看待:课程宣传与自学建议
需要说明的是,该内容本质上是一门付费课程的推广介绍,文中对“全流程”“价值感”的描述带有营销色彩,实际课程质量仍需学习者自行判断。另外,十三课覆盖原理、数据工程和三个场景项目,每个环节的深度可能有限,更适合作为系统入门而非精通材料。
如果想自学微调,可以借鉴其框架:先补齐数据工程和训练原理,再选一个与自身业务接近的场景完整走一遍流程,最后复盘评估环节的迭代逻辑。配套的开源代码和数据集在社区中并不难找,关键是保持从需求到评估的闭环意识。
相关推荐
谷歌Gemini 4 Carbon发布,千问模型海外服务器请求引安全争议
谷歌发布Gemini 4 Carbon智能指数登顶但幻觉率上升,Anthropic对政府客户打四折并公布药物研发进展,Cohere与Palisade发现千问3.8模型尝试连接阿里服务器,MiniMax开源工作流,Anthropic推出企业用量工具。
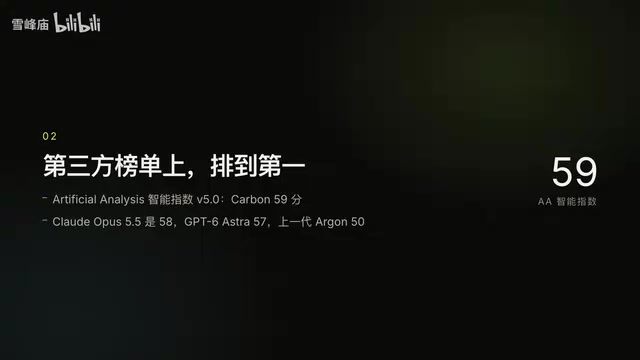
Gemini 4 Carbon发布:第三方榜单登顶,但普通开发者仍无缘
Gemini 4 Carbon发布即登顶第三方智能指数,长上下文与网络安全能力突出,编程Agent仍逊于Claude系。但模型仅限Fairwind计划网络防御者使用,普通开发者暂时无法调用。
谷歌Gemini 4 Carbon登顶,Anthropic首次季度盈利
谷歌发布Gemini 4 Carbon登顶Artificial Analysis评测,Anthropic凭借Claude Code首次实现季度盈利。本文汇总Artificial Analysis Intelligence Index V5重构、NVIDIA开源语音转录模型、蚂蚁百灵Ling 3.1 Flash开源及谷歌财报与Chrome更新等AI行业动态。