DiffusionGemma-Jev接入vLLM:让每个回答都带置信度
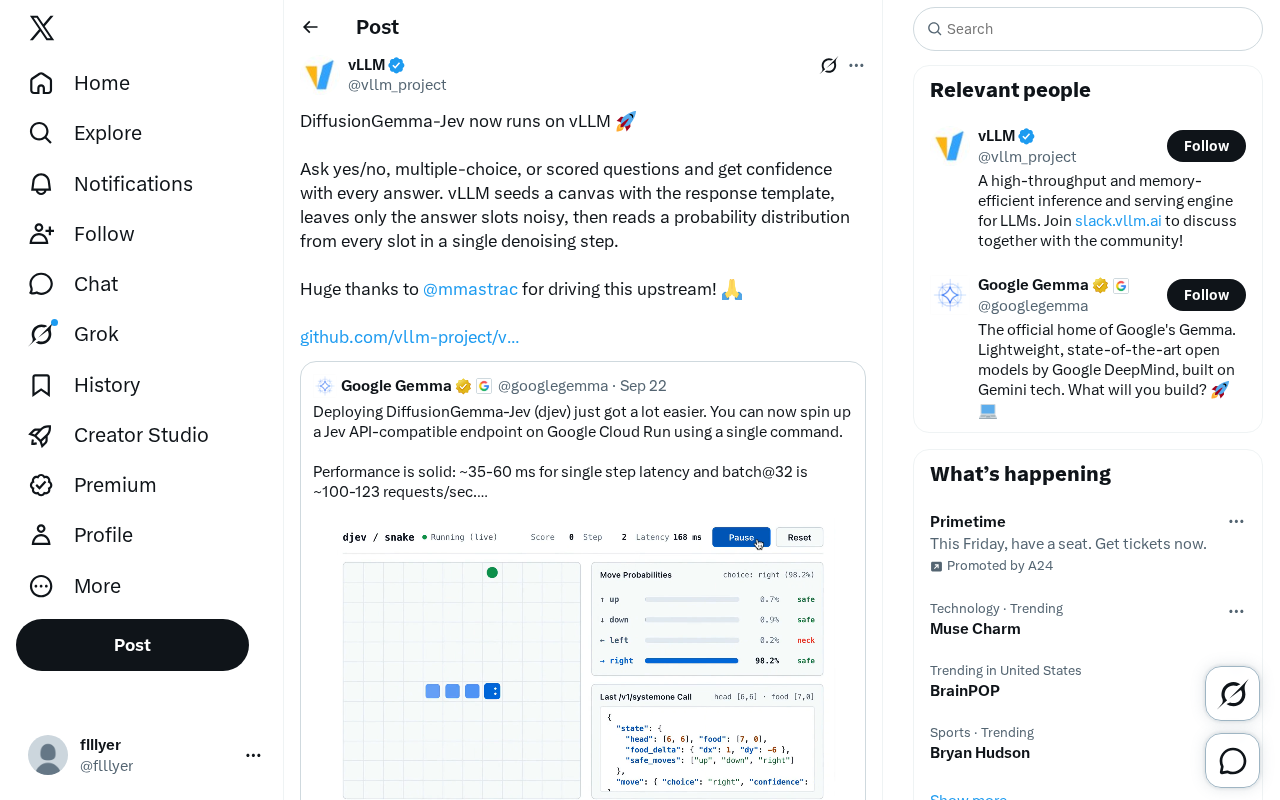
扩散语言模型DiffusionGemma-Jev接入vLLM,可并行单步去噪输出结构化答案与置信度。
DiffusionGemma-Jev 宣布已成功集成至高性能推理引擎 vLLM,且相关代码已合入上游主干。这一进展的核心亮点在于其带置信度的结构化问答能力:系统通过"画布模板+仅答案槽为噪声"的方式,在单次去噪步骤内并行读取所有答案位置的概率分布,同时输出答案与置信度数值。相比自回归模型需要逐 token 生成再回推概率的繁琐流程,扩散架构在结构化问答场景下兼具低延迟与原生概率输出的优势。这标志着扩散语言模型从研究原型向生产级部署迈出了实质性一步,对自动化评估、数据标注、RAG 筛选等需要可靠置信度的应用场景具有重要价值。
扩散语言模型正在跳出图像生成的舒适区,进入结构化推理和评估领域。近期,DiffusionGemma-Jev 宣布已经能够在 vLLM 上运行,这一进展为扩散式语言模型的实际部署打开了新的可能性——尤其是在需要"置信度"这一关键指标的场景中。
DiffusionGemma-Jev 与 vLLM 的结合
根据来源方在 Twitter 上发布的信息,DiffusionGemma-Jev 现在可以直接跑在 vLLM 这一高性能推理引擎上。vLLM 是当前业界广泛采用的大模型推理框架,以高吞吐量和高效的显存管理著称,此前主要服务于自回归(autoregressive)类的大语言模型。
此次将扩散式语言模型接入 vLLM,意味着扩散架构的推理不再局限于研究原型,而是能够借助成熟的服务化基础设施进行部署。发布者特别感谢了 @mmastrac 在推动上游(upstream)集成方面的工作,说明这项支持已被合入 vLLM 的主干代码,而非仅停留在私有分支。

带置信度的问答机制
这次更新最值得关注的能力,是让模型在回答的同时给出置信度(confidence)。它支持三类问题形式:
- 是/否问题(yes/no):适合二元判断场景
- 多项选择题(multiple-choice):适合从若干候选项中挑选
- 打分类问题(scored questions):适合需要量化评估的场景
无论是哪一类问题,系统都会随每一个答案附带一个置信度数值。这对下游应用非常有价值——在自动化评估、内容审核、数据标注、RAG 结果筛选等任务中,仅有答案往往不够,模型对自身答案的把握程度同样是关键决策依据。传统自回归模型要得到可靠的概率分布,通常需要额外的处理或近似手段,而扩散模型在这一点上有其结构性优势。
单步去噪读取概率分布的原理
真正体现扩散架构特点的,是这套机制背后的实现方式。按照原文描述,其工作流程大致如下:
- 播种画布(seed a canvas):vLLM 先用一个包含回答模板的"画布"作为起点,把整个响应的结构框架固定下来。
- 仅保留答案槽为噪声:模板中的固定部分保持清晰,只有需要模型填写答案的"槽位"(answer slots)被置为噪声状态。
- 单步去噪读取分布:在一次去噪步骤(single denoising step)中,模型对每个答案槽位直接读出一个概率分布,而不是逐 token 采样生成。
这种做法的巧妙之处在于,扩散模型天然支持并行地对多个位置进行预测,因此可以一次性拿到所有答案槽位上的概率分布。相比自回归模型必须逐字生成、再回推概率,这种"填空式"的推理更适合结构化问答,也让置信度的获取变得直接而高效。单步去噪还意味着延迟极低,非常契合 vLLM 追求高吞吐的服务化目标。
意义与展望
扩散语言模型近年来被视为自回归范式之外的重要探索方向。它们在并行生成、可控性和结构化输出方面展现出独特潜力,但过去在工程落地上一直缺少成熟的推理栈支撑。DiffusionGemma-Jev 接入 vLLM,是把这类模型从论文推向生产环境的一步实质进展。
对于开发者而言,这意味着可以用熟悉的 vLLM 接口去调用一个具备置信度输出能力的扩散模型,构建更可靠的评估与判断类应用。当然,目前公开信息主要来自一条社区发布,具体的性能表现、模型规模以及与主流自回归模型的横向对比,仍有待更详细的文档和基准测试来验证。
无论如何,扩散架构与主流推理引擎的融合趋势已经显现,值得持续关注这一路线后续的成熟度演进。
相关推荐

GPT-6.2双模型Astra与Soul实测对比:同题跑分、成本与选型建议
GPT-6.2发布Astra与Soul双模型,本文基于多平台实测数据对比两者在同题跑分、API定价、长任务成本上的差异,并给出日常迭代与复杂交付的选型建议,附AI日报其他重要动态。

GPT-6.2 Astra演示泄漏,谷歌Gemini 4新模型线索浮现
GPT-6.2 Astra 通过中转服务流出早期演示,单提示词生成完整地牢游戏;基准泄漏显示 BioBasics Bench 89 分对 67 分。同期谷歌 Gemini 4 Neon 与 Oxygen 现身后端日志,腾讯 HY4 Flash 以近 18 倍成本优势对标 Claude Haiku 5.5。

GPT-6.2 Astra泄露实测:前端能力炸裂,OpenAI为何迟迟不发?
GPT-6.2 Astra泄露基准测试与前端生成案例曝光,BioBaseExpand成绩大幅领先前代,但OpenAI因安全顾虑推迟发布。同步梳理Gemini Neon/Oxygen、腾讯HY4 Flash、Codex容量修复与Claude Code验证工作流等动态。