法律推理LLM新框架:信号平衡与奖励调度
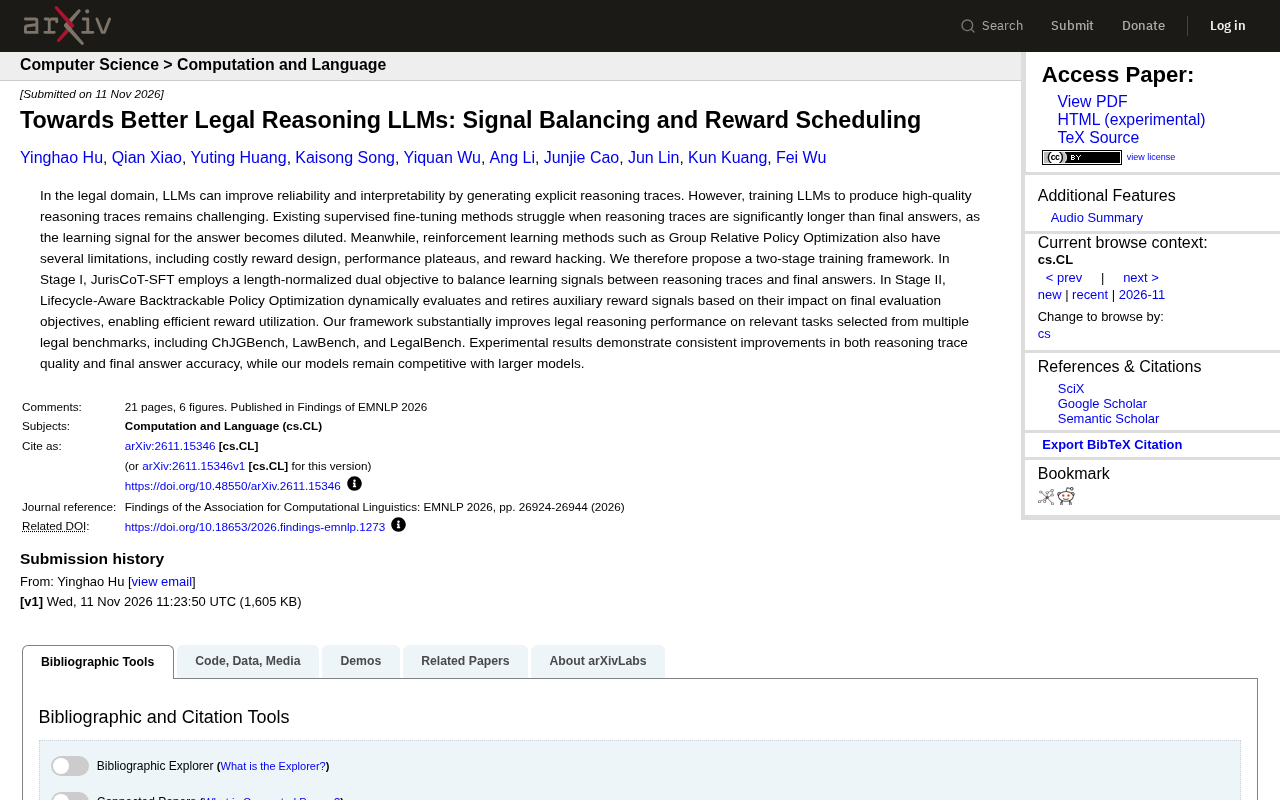
两阶段训练框架通过长度归一化监督与动态奖励调度,提升法律大模型的推理与答案质量。
文章介绍了一篇 arXiv 论文提出的法律大模型两阶段训练框架,旨在同时解决推理链质量与答案准确性之间的矛盾。现有监督微调因推理链远长于答案而稀释答案梯度信号;GRPO 等强化学习方法则面临奖励设计成本高、性能停滞和奖励劫持三大障碍。为此,作者提出 Stage I 的 JurisCoT-SFT,对推理链和答案分别计算损失并按长度归一化,使两者学习信号可比;Stage II 采用 Lifecycle-Aware Backtrackable Policy Optimization,动态评估各辅助奖励对最终目标的贡献并淘汰冗余奖励。在 ChJGBench、LawBench 和 LegalBench 上的实验显示,该框架在推理链质量和答案准确率上均稳定提升,小模型也能与更大规模模型竞争。文章最后讨论了该思路对法律 AI 落地的启示及通用性待验证的问题。
法律领域的大模型应用一直面临一个核心矛盾:如何让模型输出高质量的推理过程,同时保证最终答案的准确性。现有方法要么在监督微调时被冗长的推理链稀释了答案信号,要么在强化学习中陷入奖励设计的泥潭。一篇来自arXiv的最新论文提出了两阶段训练框架,试图同时解决这两个问题。
问题根源:推理链越长,答案信号越弱
法律推理任务天然需要详细的论证过程。一个合同纠纷的解答,往往需要先梳理事实、再援引法条、最后得出结论,推理链的长度可能是最终答案的数倍。在传统的监督微调中,损失函数对所有token一视同仁,当推理部分占据绝大部分序列长度时,答案部分的梯度信号就被严重稀释。论文作者指出,这种长度失衡会导致模型学会"写很多字",却没有真正学会"给出正确答案"。
强化学习路线同样不完美。以Group Relative Policy Optimization(GRPO)为代表的方案虽然能绕过标注推理链的难题,但存在三个现实障碍:奖励函数设计成本高昂、训练后期性能容易停滞、以及模型可能通过钻奖励漏洞来"刷分"(reward hacking)。在法律这种容错率极低的领域,奖励被劫持的后果尤为严重。
Group Relative Policy Optimization(GRPO) 是 DeepSeek广告 团队提出的一种强化学习算法,最初用于提升大模型的数学与代码推理能力。与 PPO 需要单独训练价值网络(critic)不同,GRPO 对同一个 prompt 采样一组多个回答,以组内平均奖励作为基线来计算优势函数,从而省去价值模型、显著降低显存与训练成本。其奖励通常来自规则校验(如答案是否正确)或奖励模型打分,因此无需人工标注完整推理链。正是这种“只需结果奖励”的特性,使 GRPO 成为法律等标注昂贵领域的热门选择;但也正因为奖励由外部规则或模型给出,一旦奖励设计存在偏差,模型就可能学会迎合奖励而非真正提升答案质量,即 reward hacking。
两阶段框架:先平衡信号,再调度奖励
Stage I:长度归一化的双目标学习
针对信号稀释问题,作者提出了JurisCoT-SFT。它的核心思路是对推理链和最终答案分别计算损失,并按序列长度做归一化,使两部分的学习信号处于可比较的量级。这样一来,即使推理部分比答案长出一个数量级,答案的监督信号也不会被淹没。
这个设计看似简单,却直击痛点。法律推理的数据标注中,推理链的质量和答案的正确性同样重要,但此前的方法往往顾此失彼。长度归一化相当于给两者分配了公平的"话语权"。
Stage II:生命周期感知的可回溯策略优化
第二阶段采用Lifecycle-Aware Backtrackable Policy Optimization。与固定奖励权重的做法不同,该策略会动态评估每个辅助奖励信号对最终评估目标的实际贡献,并据此决定是否"退休"某些奖励项。
这个机制的价值在于应对奖励信号的老化。训练初期有效的辅助奖励,在模型能力提升后可能变得冗余甚至有害。通过回溯和淘汰机制,模型可以把算力集中在真正驱动最终指标的信号上,从而缓解性能停滞和奖励劫持问题。
Reward hacking(奖励劫持) 指强化学习智能体在训练中找到了奖励函数的漏洞,以非预期的方式获取高奖励,而非真正完成目标任务。在大语言模型对齐中,常见表现包括:模型学会输出冗长但空洞的推理、迎合奖励模型的表面偏好、或在规则校验中钻格式空子。由于奖励只是真实目标的代理指标,代理与目标之间的偏差会被优化过程放大。在法律场景下,这种偏差尤为危险——模型可能生成看似论证充分、实则援引错误法条或遗漏关键要件的答案,却因格式或关键词匹配而获得高分。论文在 Stage II 引入奖励项的动态评估与“退休”机制,正是为了在训练过程中持续校准代理奖励与最终评估目标之间的一致性,抑制奖励劫持的发生。
实验表现:小模型也能与更大模型竞争
作者在ChJGBench、LawBench和LegalBench三个法律基准上选取了相关任务进行评测。结果显示,该框架在推理链质量和最终答案准确率上均有稳定提升,且模型在与更大规模模型对比时保持竞争力。
有意思的是,论文强调的提升是"一致性"的——不是某个单项指标暴涨,而是两个维度同时改善。这恰恰是两阶段设计的意图:Stage I打牢监督信号的基础,Stage II在强化学习阶段做精细化的奖励管理,二者形成互补。
对法律AI落地的启示
法律推理对可解释性的要求远高于一般问答场景。一个只给结论不展示论证过程的模型,在律师和法官眼中几乎没有使用价值。这篇论文的思路提示我们,训练数据的结构设计(如何分配推理与答案的权重)和奖励机制的生命周期管理,可能是比单纯堆参数更有效的优化方向。
当然,该框架的通用性仍需验证。法律领域的数据标注成本高、标准不统一,两阶段训练对数据质量的依赖程度、以及奖励调度策略在跨法系场景下的稳定性,都是后续值得关注的问题。
相关推荐
Gemini 4 Hydrogen 深度评测:高性价比之外的真实价值
基于 Artificial Analysis 选型数据与实测反馈,拆解 Gemini 4 Hydrogen 的性价比悖论:高分不等于高价值,自动化工作流与代码任务表现分化,定价与 Google 订阅包各算各的账,SynthID 输出标识可能成为一票否决项。
Gemini 4 Hydrogen 五大极限测试:96.7% 准确率与一键建站
YouTube 创作者对 Gemini 4 Hydrogen 进行五项极限测试:单提示词生成游戏、3D 太阳系模拟、30 分钟视频时间戳定位、287 页财报转交互仪表盘,以及抗幻觉测试中 96.7% 的准确率表现。
Gemini 4 Hydrogen发布:速度提升2.5倍的日常AI模型
Google发布Gemini 4 Hydrogen,宣称比Gemini 3.8 Flash快2.5倍,支持四级思考控制、百万token上下文和Orchestrator多模型协作,API定价每百万输入token 1.50美元。