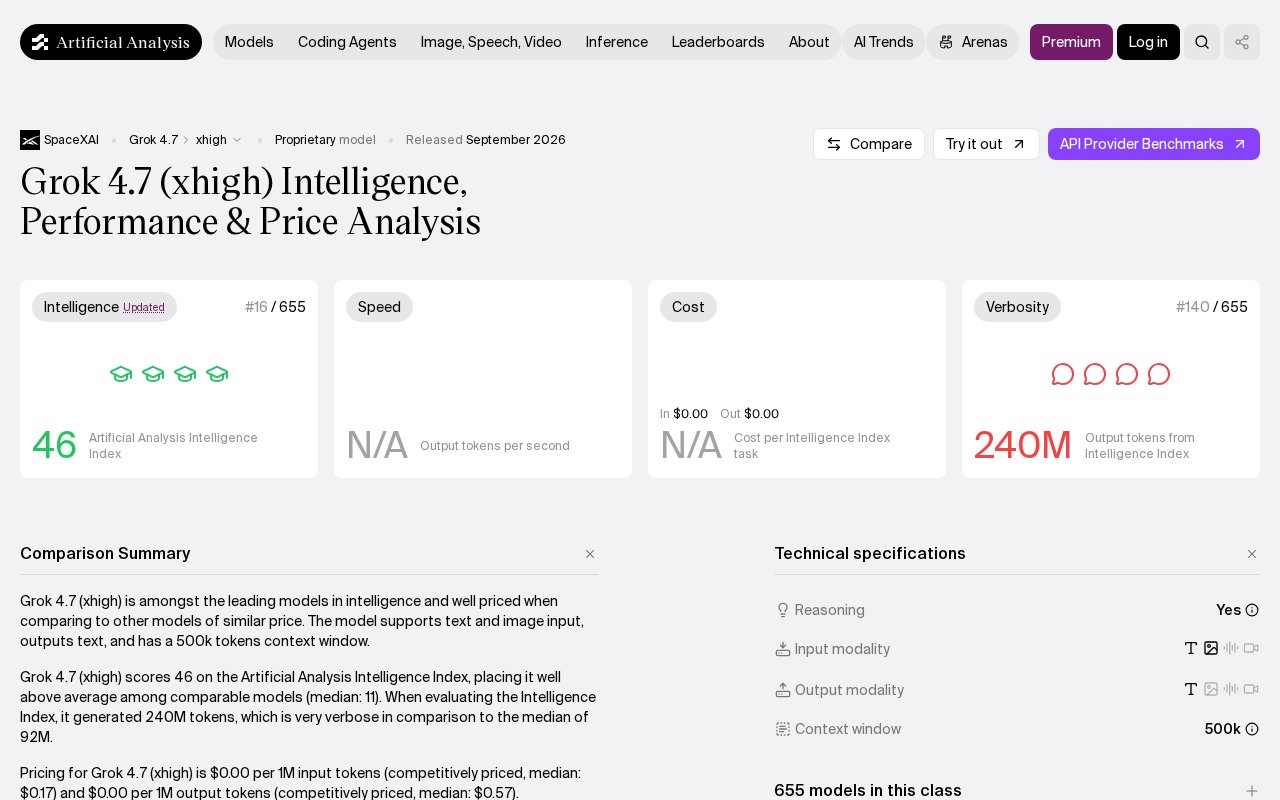
Grok 4.7 智能、性能与价格深度解析

本文围绕Grok 4.7,梳理了评估大模型智能、性能与定价的理性框架,并提示现阶段数据不足应保持审慎。
这篇文章以Hacker News上一则关于Grok 4.7的讨论为起点,因原始资料仅有标题、缺乏实测数据,作者转而构建了一套通用的大模型评估框架。文章从三个维度展开:智能评估应依赖GSM8K、MMLU、SWE-bench等多项标准化基准,而非单一官方数据;性能分析需兼顾推理速度、首字延迟与吞吐量等工程指标;定价则需结合能力水平与单位token成本,与GPT、Claude、Gemini等同级竞品横向对比。文章最后以Hacker News上该讨论热度尚低(6赞、0评论)为由,提醒读者在数据充分之前保持开放和交叉验证的态度。
关于 Grok 4.7 的这份分析
近期在 Hacker News 上出现了一篇针对 Grok 4.7 的智能、性能与定价分析的讨论。遗憾的是,目前公开的原始素材仅包含标题信息,缺乏具体的评测数据、基准分数和价格明细。基于现有信息的局限性,本文将围绕这类模型分析通常关注的核心维度,为读者梳理一个理性的评估框架,并说明在获取更完整数据前应保持的审慎态度。
如何评估一款大模型的"智能"
衡量一款大语言模型的智能水平,业界通常依赖一系列标准化基准测试。这些测试涵盖数学推理(如 GSM8K、MATH)、代码生成(如 HumanEval、SWE-bench)、常识推理(如 MMLU)以及长上下文理解等多个维度。对于 Grok 系列而言,其背靠 xAI 的实时数据接入能力是一个差异化特征,理论上能在时效性问题上表现更好。
不过,单一基准分数往往不能代表真实使用体验。模型在特定任务上的"刷分"能力,与它在开放式对话、复杂工程任务中的稳定性之间可能存在显著差距。评估 Grok 4.7 时,读者应关注它在多个独立第三方评测中的综合表现,而非仅凭官方宣传的单点成绩。
值得进一步说明的是,上述基准测试各有侧重:GSM8K 和 MATH 分别考察小学级别与竞赛级别的数学推理;HumanEval 要求模型根据函数签名和文档字符串生成正确代码,而 SWE-bench 则更进一步,测试模型能否在真实 GitHub 仓库中自动修复 Bug,难度显著更高;MMLU(Massive Multitask Language Understanding)则横跨 57 个学科领域,涵盖法律、医学、历史等,用于衡量模型的广度知识覆盖。Grok 系列的"实时数据接入"指其通过 X(原 Twitter)平台获取最新信息的能力,这在时事问答类任务上可构成独特优势,但对数学、代码等静态推理任务的影响相对有限。
性能的多个衡量角度
性能不仅指模型的"聪明程度",还包括推理速度(tokens/秒)、首字延迟、并发处理能力以及在长上下文下的表现稳定性。对于开发者和企业用户来说,这些工程指标往往比基准分数更直接地影响实际应用成本和用户体验。
一款模型即便在推理质量上领先,如果响应延迟高或吞吐量低,在生产环境中的实用性也会打折扣。因此,完整的性能分析理应同时呈现质量与速度的权衡曲线,帮助用户判断该模型是否适合自己的具体场景。
价格与性价比的考量
定价是模型选型中不可忽视的一环。当前主流厂商普遍采用按 token 计费的模式,输入和输出 token 通常分别定价。评估性价比时,需要将模型的能力水平与其单位成本结合起来看——一款价格较高但能力更强的模型,在复杂任务上可能反而更划算,因为它能减少反复重试和人工修正的隐性成本。
对于 Grok 4.7 的价格分析,理想情况下应对比同级别竞品(如 GPT、Claude、Gemini 系列)的定价,从而判断其在市场中的定位。是主打高端旗舰,还是走性价比路线,直接影响其目标用户群体。
主流大模型 API 的 token 定价通常以"每百万 token"为计量单位(即 per million tokens,MTok)。以 2024 年底的市场行情为参考,GPT-4o 输入约 $2.5/MTok,Claude 3.5 Sonnet 输入约 $3/MTok,Gemini 1.5 Pro 输入约 $1.25/MTok,而部分开源模型通过自托管可将成本压缩至接近零。输出 token 的定价通常是输入的 3-5 倍,因为生成比读取消耗更多算力。在实际业务场景中,还需考虑上下文窗口大小对总 token 用量的影响——上下文越长,单次请求成本越高,但可能减少多轮对话的总调用次数。
理性看待社区热度
这篇分析在 Hacker News 上的关注度目前有限(6 个赞、0 条评论),说明相关讨论尚处于早期阶段,社区尚未形成明确共识。对于这类新发布模型的分析文章,建议读者交叉参考多个来源的评测结果,尤其是独立机构和真实用户的实测反馈,避免被单一信息源左右判断。
在数据更充分之前,对 Grok 4.7 的任何定论都应保持开放态度。随着更多基准测试和实际应用案例的积累,其真实的智能水平、性能表现和性价比定位才会逐渐清晰。
相关推荐
AWS MCP Server新增6大区域:AI编程智能体的基础设施提速
AWS将托管MCP服务器扩展至新加坡、悉尼、东京、爱尔兰、伦敦和俄勒冈六个新区域,为AI编程智能体提供统一接口发现、调用和运维AWS服务,降低延迟并满足数据驻留需求。
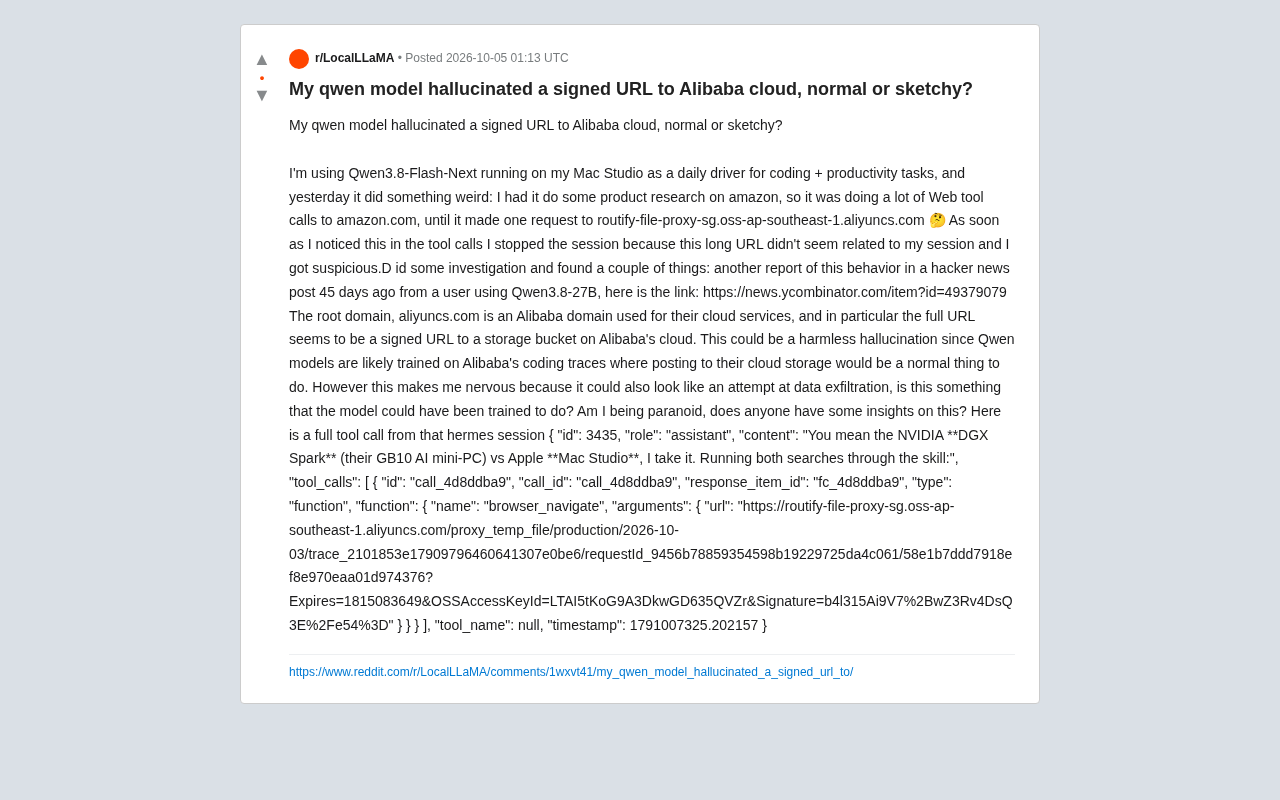
Qwen模型凭空生成阿里云签名URL:幻觉还是数据外泄隐患?
Reddit用户报告Qwen模型在工具调用中凭空生成指向阿里云OSS的签名URL,引发数据外泄担忧。本文结合多份独立报告,分析这究竟是训练数据导致的模型幻觉还是安全风险,并给出Agent工具调用的安全防护建议。
多模态AI转录开罗genizah:右向左语言的VLM微调实践
一篇技术文章探讨如何通过微调多模态视觉语言模型(VLM)自动转录开罗genizah中世纪手稿,解决希伯来语等右向左语言的OCR难题,为数字人文研究提供新工具。