INKBOT:用结构化中间层弥合人类意图与模型推理的鸿沟

INKBOT通过可视化意图中间层,在AI执行前让人类审查并纠正模型对需求的理解。
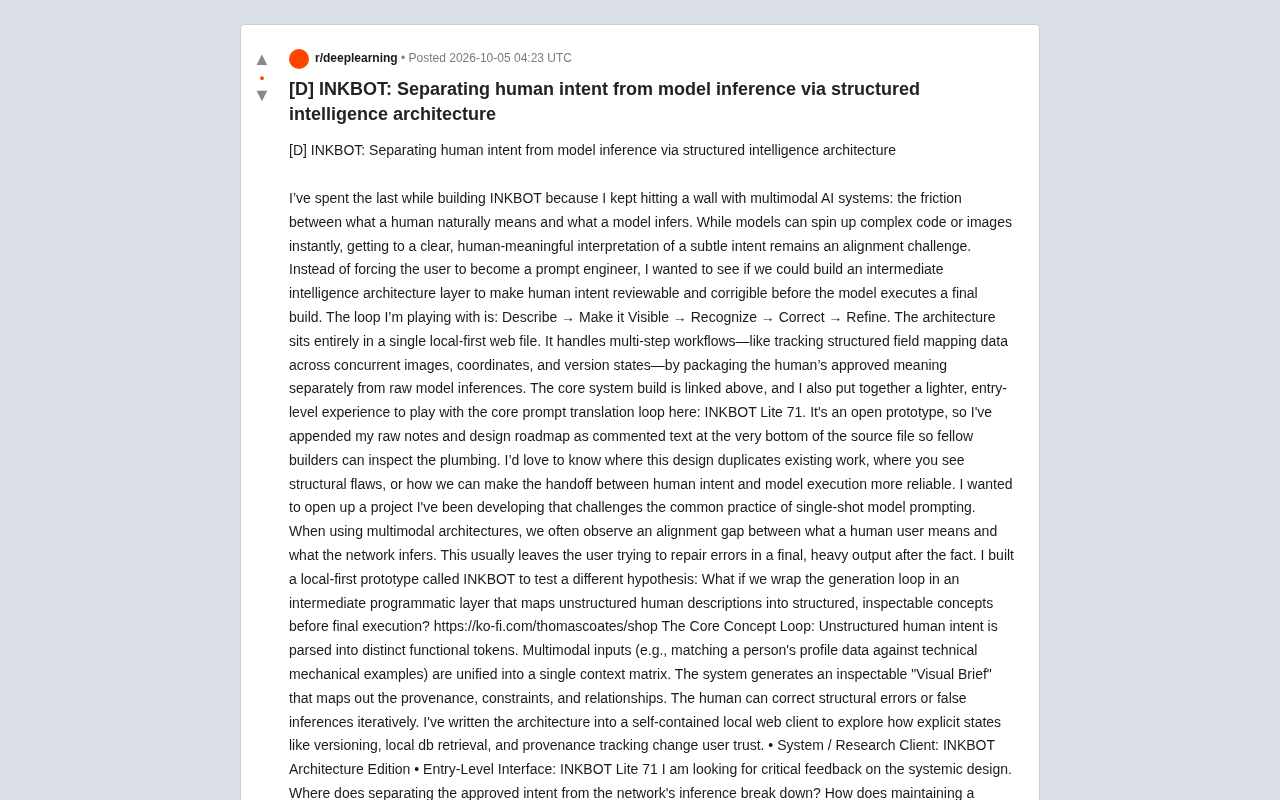
独立开发者Thomas Coates构建了INKBOT原型,专门针对多模态AI中人类意图与模型推理之间的「对齐鸿沟」。其核心思路是在模型生成最终产物前插入一个中间层:将用户的模糊自然语言描述解析为「功能性token」,生成可审查的「视觉简报」,让用户在耗费资源的最终生成之前就能发现并纠正结构性误解。系统刻意将人类确认过的意图与模型原始推断分开存储,以形成稳定的约束基准。项目以本地优先的单一网页文件形式实现,作者公开源码并向社区征求批判性反馈,尤其关注这一设计在规模化场景下的局限性。
一个困扰多模态AI的老问题
多模态AI系统能在瞬间生成复杂代码或图像,但有一个痛点始终难以解决:人类真正想表达的意思,和模型实际推断出来的内容,往往对不上。一位独立开发者 Thomas Coates 在 Reddit 机器学习板块分享了他的项目 INKBOT,正是为了攻克这个「对齐鸿沟」(alignment gap)。
他的观察很直接——当前的主流做法是「单次提示」(single-shot prompting)。用户描述需求,模型一口气生成一个庞大的最终产物,然后用户再回过头去修补其中的错误。这种模式把修正成本推到了最后,也逼着普通用户去学习如何当一名「提示词工程师」。
INKBOT 想换一条路:与其让人去迁就模型,不如在模型执行最终构建之前,插入一个让人类意图变得「可审查、可纠正」的中间智能层。
「对齐鸿沟」(alignment gap)在这里特指用户意图与模型输出之间的语义偏差,有别于AI安全领域常讨论的「价值对齐」问题。前者是工程层面的交互失真:用户说的是A,模型理解成B,生成了C。这种偏差在多模态系统中尤为突出,因为跨模态的语义映射(例如将文字描述转化为图像构图逻辑)本身就存在大量歧义空间。单次提示(single-shot prompting)范式的根本缺陷在于,它将「需求澄清」这一本应是对话过程的环节压缩成了一次性的输入,把所有不确定性都留给了模型的黑箱推断,而用户只能在拿到最终输出后才能发现偏差——此时修正成本最高。
核心设计:让意图在执行前变得可见
作者提出的交互循环是一条清晰的链路:描述(Describe)→ 可视化(Make it Visible)→ 识别(Recognize)→ 纠正(Correct)→ 精炼(Refine)。
这个循环的关键在于前两步。传统流程里,人类的模糊描述直接喂给模型,中间发生了什么用户看不见;INKBOT 则把非结构化的人类描述先解析成一组「功能性 token」,再把多模态输入(比如将一个人的档案数据与技术机械样例进行匹配)统一进单一的上下文矩阵。
在此基础上,系统会生成一份可检视的「视觉简报」(Visual Brief),把需求的来源(provenance)、约束条件和各要素之间的关系都摊开展示。用户可以在这一步纠正结构性错误或模型的错误推断,而不必等到最终重型产物生成之后再返工。
「功能性 token」(functional token)是 INKBOT 设计中的核心抽象单位,指将非结构化的自然语言描述拆解为具有明确语义角色的最小单元——例如将「做一张科技感的产品海报」拆解为「风格:科技感」「类型:海报」「主体:产品」等可独立审查的字段。这一思路在 NLP 领域有其原型,类似于语义角色标注(Semantic Role Labeling),但 INKBOT 的重点不在于语言学分析,而在于让这些结构化单元对用户可见、可修改,从而在生成前形成一份经人类确认的「需求合同」。上下文矩阵(context matrix)则是将多路输入(文本、图像示例、档案数据等)统一编码进同一个可检索结构,避免不同模态之间的信息在传递过程中被隐式丢弃。
把「已批准的意图」与「原始推理」分开存放
INKBOT 架构中最值得关注的一点,是它刻意将人类批准过的意义与模型的原始推断分开打包。
作者解释,整个系统被写进一个本地优先(local-first)的单一网页文件中,用来处理多步骤工作流——例如在多张并发图像、坐标、版本状态之间追踪结构化的字段映射数据。通过显式地管理版本、本地数据库检索和来源追踪这些状态,作者想探究一个问题:当这些状态变得明确可见时,用户对系统的信任会如何变化?
这其实触及了一个长期被忽视的工程细节。模型的推断本身是易变、不可靠的,而人类一旦确认过的意图应当是稳定的「锚点」。把二者混在一起,就很难判断一次错误到底出在「人没说清」还是「模型没理解」。分离之后,系统就有了一个可靠的基准来约束后续生成。
作者真正想要的反馈
这是一个开放的原型项目。作者把自己的原始笔记和设计路线图以注释形式写在源文件的最底部,方便其他开发者检查内部实现(用他的话说是「inspect the plumbing」)。他还额外做了一个更轻量的入门版本 INKBOT Lite,让人先体验核心的提示翻译循环。
他在帖子里抛出了几个具体问题,希望社区给出批判性意见:
- 这个设计在哪些地方与现有工作重复?
- 把「已批准的意图」从「网络推理」中分离出来,会在什么情况下失效?
- 维护一个有状态的修订历史,如何改变长周期任务中对模型的引导?
作者特别声明,这是一个独立的、非商业的研究原型,与任何主流模型提供商无关、也未获其背书。
一点评价
INKBOT 的思路并不孤立。从 LangChain 的链式编排,到各类「人在回路」(human-in-the-loop)的审查机制,业界其实一直在尝试给模型的黑箱过程加上可控的中间层。INKBOT 的特别之处在于它把焦点放在意图的可视化与状态分离上,并且用极简的本地单文件形态实现,降低了其他开发者上手检查的门槛。
当然,这类设计的真正难点往往出现在规模化之后:当字段映射、版本分支和来源链条变得复杂,「视觉简报」本身会不会变成新的认知负担?把意图结构化为功能 token 的过程,又会不会引入新的信息损失?这些都是值得社区继续探讨的问题。
对于关注 AI 对齐和人机交互工程的开发者来说,INKBOT 提供了一个具体、可拆解的实验样本——它未必是最终答案,但它把问题提得足够清楚。
INKBOT 所属的「人在回路」(Human-in-the-Loop,HITL)范式是一类将人类判断嵌入自动化流程关键节点的系统架构,广泛应用于数据标注、内容审核和高风险决策辅助等场景。其核心假设是:对于模型置信度不足或后果不可逆的决策,人类的主动确认比事后纠错代价更低。LangChain 等编排框架通过定义「链」(chain)和「代理」(agent)来拆解复杂任务,允许在每个中间步骤注入工具调用或人类审查节点。INKBOT 与这类框架的差异在于,它的介入点不是任务执行的中途,而是需求解析阶段——它试图在模型开始「做」之前,先让人类确认模型「理解」了什么,这是一个更上游的干预策略。
相关推荐
Linux 发行版该停止纠结桌面了:底层才是真正价值
一位资深 Linux 创作者认为,多数发行版把精力浪费在桌面美化和品牌差异化上,而内核、驱动、软件仓库等底层才是真正价值所在。本文梳理其核心论点与内在矛盾。
用户自建个人感知系统:谁在定义技术的边界?
一项HCI研究通过绿野仙踪探针,探讨用户自建个人感知系统时如何与技术预设的本体论边界协商,揭示了超越可用性的设计评估新维度。
从零实现AdaBoost:机器学习手写算法第27天实录
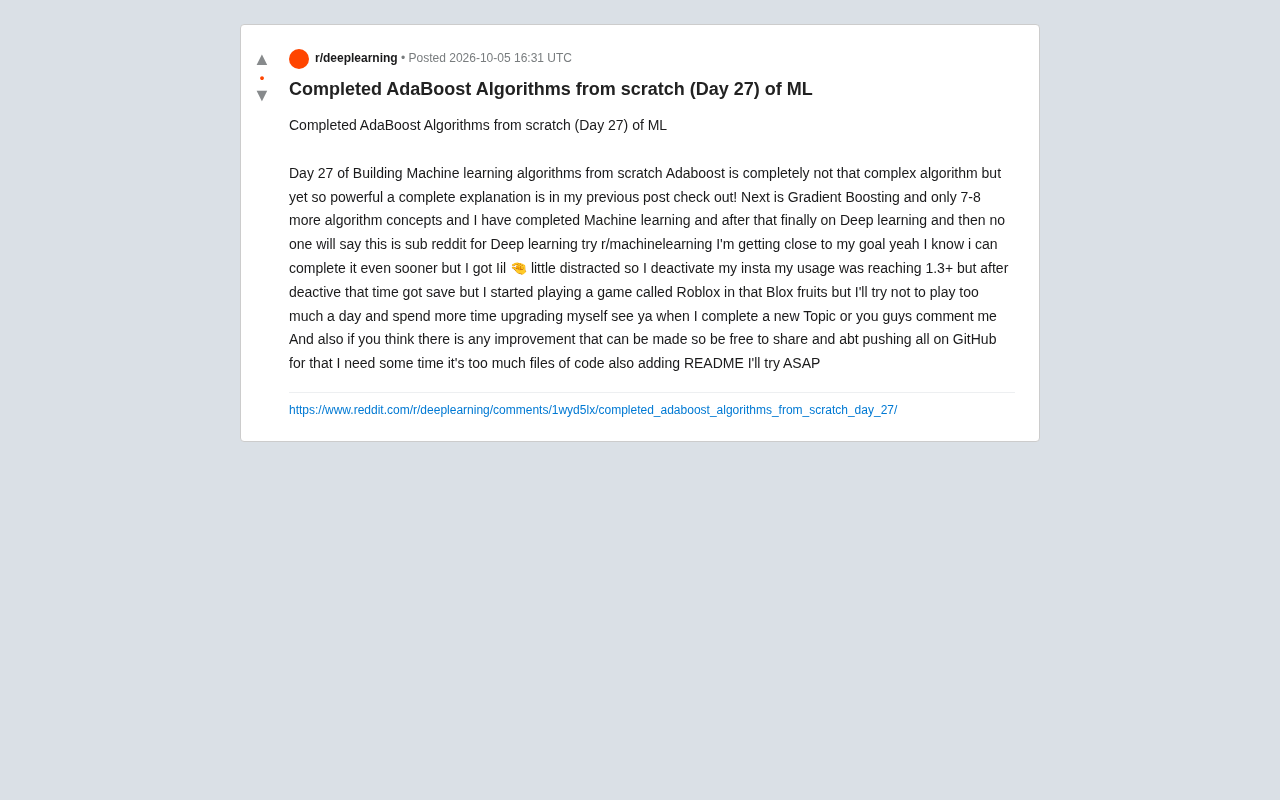
一位Reddit学习者从零手写实现AdaBoost算法,分享机器学习第27天进度。本文解析AdaBoost核心原理、从零实现的价值,以及从集成学习到深度学习的自学路线规划。