KV Cache为何撑爆显存?大模型推理优化全解析
KV Cache是LLM推理显存暴涨的真正元凶,理解其原理与优化方案是大模型部署的核心必修课。
本文深入解析了大模型推理中显存异常飙升的根本原因——KV Cache(键值缓存)机制。KV Cache通过缓存历史Token的Key和Value矩阵,避免自回归生成时的重复计算,以空间换时间大幅提升推理速度;但其显存占用随模型层数、序列长度、KV头数量和数据精度线性乘积增长,在长文本高并发场景下极易成为显存第一杀手。文章还厘清了两大常见误区:只缓存KV而非Q的设计逻辑,以及PagedAttention(减少碎片)与FlashAttention(优化计算带宽)解决的是不同维度的问题。工程部署时,必须将权重显存、KV显存和激活值显存分开估算,才能制定可靠的资源规划方案。
显存暴涨的真凶不是模型变大
很多做LLM应用的开发者都遇到过这样的困惑:加载模型权重明明只占十几GB显存,可一旦跑起长对话,显存占用就像坐了火箭,从20GB直接飙升到上百GB。新手的第一反应往往是「模型是不是变大了」,但真相并非如此。
真正吞噬显存的隐形巨兽,是KV Cache(键值缓存)。这也是大厂面试中的高频考点——如果面试官问它为什么能加速推理、又为什么会撑爆显存,只回答「缓存」两个字,基本就与offer无缘了。
KV Cache的本质:空间换时间
KV Cache本质上是Transformer在自回归生成时,用来存储历史注意力计算结果的「临时备忘录」。它的核心思想是空间换时间。
如果没有它,模型每生成一个新Token,都要把前面所有内容重新计算一遍。序列越长,计算量呈平方级爆炸增长,根本无法投入实际使用。有了KV Cache后,历史计算结果得以复用,新Token只需要和缓存做注意力交互,推理速度因此有了质的飞跃。
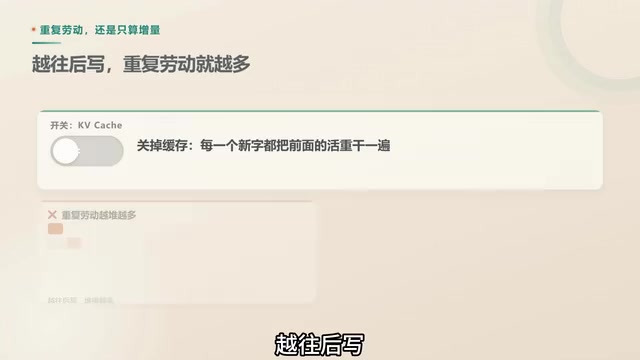
举个直观的例子:模型在生成「人工智能重塑未来」这句话时,等到写「工」字,如果没有缓存,它得把「人工智能」这几个字对应的计算全部重做一遍——越往后写,重复劳动越多。开启KV Cache后,之前的计算结果被存了下来,生成新字时只需要计算增量部分,效率天差地别。
为什么叫KV Cache,而不是QKV Cache?
这里藏着一个关键技术点。Query(查询)只代表当前这一刻的查询意图,用完即弃,没有复用价值;而Key和Value代表的是历史Token的语义信息,后续每一个新Token都要回头查阅它们。所以只缓存K和V,才是性价比最高的选择。
从Transformer注意力机制的计算流程来看,每个Token在每一层都会生成三个向量:Query(Q)、Key(K)、Value(V)。Q表示「我想查什么」,K表示「我有什么标签」,V表示「我实际携带的内容」。注意力计算的本质是用当前Token的Q去和所有历史Token的K做点积,得到权重后再加权求和各Token的V。
在自回归生成中,每生成一个新Token,它的Q只参与当前这一步的计算,之后便不再被引用;但过去所有Token的K和V,未来每生成一个新词都需要重新访问一次。如果不缓存,每次生成都要对整个上下文重新计算K和V,时间复杂度是O(n²)。因此只存K和V的缓存设计,是在计算图的关键路径上做了精准的「剪枝」,而非简单地把所有中间结果都保存下来。
为什么KV Cache会拖垮显存
问题的核心在于:每一层Transformer都有独立的缓存,而且每个并发请求、每条序列都要单独占用一份缓存。
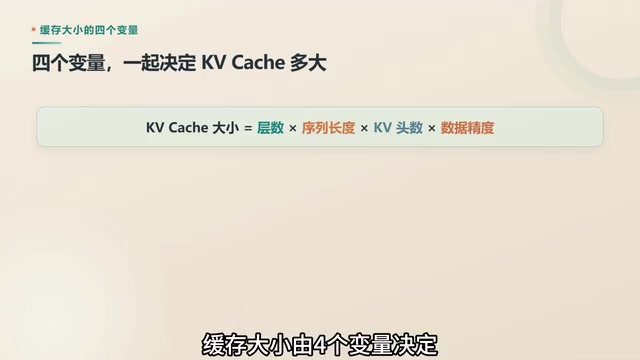
KV Cache的大小主要由四个变量决定:
- 模型层数
- 序列长度
- KV头数量
- 数据精度
值得警惕的一个陷阱是:哪怕你把模型权重量化到了Int4,KV Cache可能还在用FP16甚至BF16来跑。结果就是权重体积很小,但长文本加高并发的场景一上来,缓存反而成了显存消耗的第一大户。
因此在做部署规划时,千万别只盯着模型文件大小。必须把权重显存、KV显存和激活值显存分开估算,才能得到靠谱的资源预算。
业界的优化方案盘点
为了驯服这头显存巨兽,业界卷出了一系列优化方案。
PagedAttention:借鉴操作系统的分页机制
PagedAttention借鉴了操作系统虚拟内存的分页思想,把缓存切成小块,按需分配,极大减少了显存碎片。这是vLLM等推理框架能够大幅提升吞吐的关键技术之一。
传统推理框架在为请求分配KV Cache时,往往按最大序列长度预先申请一整块连续显存。这会带来两个问题:一是内部碎片(为一条短序列预留了长序列的空间,大量显存被浪费但无法给其他请求使用);二是外部碎片(空闲显存分散在各处,总量足够却无法凑出连续大块)。
PagedAttention将每个请求的KV Cache切分为固定大小的「块(block)」,每块可以存储若干个Token的K和V向量,并通过一张块表(block table)记录逻辑块到物理块的映射关系——这与操作系统用页表管理虚拟内存的思路如出一辙。物理块可以不连续,按需动态分配,用完即释放,从而将显存碎片率降至极低。更进一步,同一个前缀(如系统提示词)的物理块可以在多个请求间共享,实现「写时复制」,这在高并发场景下能再省下大量显存。
FlashAttention:优化计算而非存储
FlashAttention通过算子融合减少HBM(高带宽显存)的访问次数。需要注意的是,它优化的是计算效率,并不等于节省存储空间——两者解决的是不同维度的问题,容易被混淆。
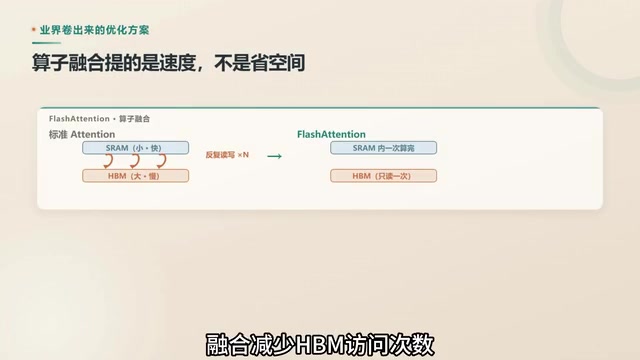
FlashAttention的优化目标是GPU内存层次结构中的带宽瓶颈。GPU拥有速度极快但容量极小的SRAM(片上缓存),以及容量大但带宽相对有限的HBM(即通常所说的「显存」)。标准注意力实现每次计算都需要将中间的注意力矩阵(大小为序列长度的平方)写入HBM再读回,当序列很长时,这种反复的HBM读写成为性能瓶颈。
FlashAttention采用「分块计算+算子融合」的策略,将Q、K、V矩阵按块加载到SRAM中,在片上完成完整的注意力计算后只把最终结果写回HBM,从而将HBM访问次数从O(n²)降低至O(n)。其副产品是节省了存储中间注意力矩阵所需的显存,但KV Cache本身的大小并未改变——因此在评估长上下文显存占用时,FlashAttention无法替代PagedAttention或KV量化等专门针对缓存体积的优化手段。
其他策略
此外还有KV Cache量化、潜在维度共享、滑动窗口等策略,目标都是在有限的显存里塞进更多有效上下文。这些方法可以组合使用,共同服务于长上下文场景的落地。
面试满分回答模板
如果面试遇到相关问题,可以参考这个回答框架:
KV Cache通过缓存历史KV矩阵,避免重复计算,从而降低推理延迟;但其显存开销随层数、序列长度和并发数线性增长,是长上下文场景的主要瓶颈。工程落地需要结合PagedAttention、KV量化及上下文管理策略进行综合优化。
记住一句话:KV Cache不是模型参数,它是推理时的短期工作记忆。对话越长、并发越高,它就越容易成为系统瓶颈。理解了这一点,你才算真正入门了大模型推理。
相关推荐
OpenAI披露模型异常、DeepMind建AGI机构、英伟达联手管电力
9月17日AI行业三大动态:OpenAI公开模型异常披露框架并放出六份报告,Google DeepMind成立AGI公共讨论平台,英伟达联合Google等发起AI电力管理联盟。深度解析AI安全、治理与基础设施三大瓶颈。
Prompt→MCP→Agent→Skill:5分钟搞懂AI术语进化链
一篇科普梳理Prompt、MCP、Agent、Skill、Cowork五大AI核心概念的递进关系。用职场类比讲透AI如何从简单指令进化到多智能体团队协作,帮你彻底告别AI术语焦虑。
10分钟用Python搭建本地AI代理:Ollama+PydanticAI实战
一篇基于B站教程的实操指南,教你用Python、Ollama和PydanticAI在10分钟内搭建完全本地运行的AI代理。涵盖模型选择、连接推理服务器、挂载工具函数和构建对话循环全流程。