LangChain入门:Agent开发与RAG实战拆解

LangChain是弥补大模型三大短板、以链式编排构建智能体应用的开源框架。
文章澄清了一个常见误解:LangChain 不只是模型 API 封装,而是用于开发大模型驱动应用的开源框架,提供预构建智能体框架与工具集成能力,在 Agent 开发生态中地位类比 Java 中的 Spring,底层基于 LangGraph。文章归纳了大模型的三类短板——知识截止、无法与外部系统交互、天然无状态,并说明 LangChain 分别通过 Function Call、工具集成和链式编排来弥补。名字由 Language 与 Chain 组成,体现"把模型与计算机内外部资源链式连接"的设计哲学。学习上应以官方文档为第一入口,覆盖 LangChain、LangGraph、Deep Agents 与 LangSmith,先看 Overview 与快速开始,从 Create Agent 动手。
LangChain是什么:不只是API封装
很多开发者初学大模型应用开发时,会把LangChain理解成一个调用模型的API封装工具。这个认知并不完整。按照这期B站教程的说法,LangChain本质是一个用于开发由大语言模型驱动的应用程序的开源框架,在Python生态和主流Agent开发生态中几乎绕不开。
它真正的价值在于提供了预构建的智能体框架和丰富的工具集成能力。教程里打了个很形象的比方:如果你写过Java,可以把LangChain在Agent开发中的角色类比成Spring在Java里的定位——你不需要从零搭建复杂的集成架构,就能快速构建基于大语言模型的高级应用。底层目前走的是LangGraph,同时也在融入Deep Agents相关能力。
大模型的三类短板,LangChain如何补
理解一个框架,先要理解它到底解决了什么问题。教程从宏观维度归纳了三类大模型本身的局限,这三类问题在实践中非常典型。
知识截止:训练之后发生的事它不知道
模型的知识停留在训练时间节点,之后发生的事情它无从知晓。教程举的例子很直白:训练于8月10号的模型,问它8月11号的天气,它答不上来。有同学会说"我问豆包它知道啊"——那是因为你用的豆包本身已经是封装过的应用,并非直接与底层模型交互。LangChain通过Function Call机制,让开发者自己调用工具去获取模型拿不到的数据。
Function Call(函数调用) 是大模型提供的一种结构化输出能力:开发者用 JSON Schema 描述可用函数的名称、参数与用途,模型在对话中判断是否需要调用、调用哪个、传什么参数,并返回结构化的调用请求,由应用侧真正执行函数再把结果回填给模型。它并不是模型真的去执行代码,而是把"该调什么"的决策交给模型、把"真正执行"留给开发者,因此既能突破知识截止,也能把权限与副作用控制在应用层。LangChain 把这一机制封装成统一的工具(Tool)抽象,同一套工具定义可以在不同模型供应商之间复用,并自动处理调用—结果回填的多轮循环。
外部交互与内部数据:模型碰不到你的系统
大模型无法直接与外部系统交互。调三方API查天气、写工具类做精确的加减乘除运算、甚至用JDBC连接公司内部数据库——这些模型本身都做不到。复杂运算尤其如此,模型算不准是常态。LangChain的工具集成能力,正是为打通模型与外部资源之间的这层隔阂而存在。
无状态:多轮对话不是模型的原生能力
和豆包、DeepSeek广告交互时,它似乎记得你之前聊过什么,把前后问题结合起来回答。但这不是模型本身的能力。大模型天然是一问一答,不具备状态保持能力,第二个问题不会自动关联第一个问题。多轮对话的记忆,靠的是外层框架的编排,LangChain正是承担这一职责的框架之一。
从协议层面看,主流大模型的对话接口是无状态的:每次请求都要把完整的历史消息(system、user、assistant 角色序列)重新发送一遍,模型才能"看到"之前聊过什么。所谓记忆,本质是应用侧维护一个消息列表并在每次调用时拼装进上下文。这带来了两个工程问题:一是上下文长度有上限,历史过长需要截断、摘要或做检索式记忆;二是 token 消耗随轮次线性增长,成本与延迟都要纳入设计。LangChain 用 Memory 组件与消息历史管理来抽象这一层,把"存哪里、怎么裁剪、怎么注入"从业务代码中剥离出来,也方便在会话级、用户级做持久化。
名字的由来:Language + Chain
LangChain的名字拆开就是两层含义:Lang代表Language,即大语言模型;Chain代表链式交互的组合。用教程的原话说,就是把大语言模型和计算机里的其他资源以链式方式连接起来,让它们之间产生交互,从而构建出更强大的AI应用或智能体。这个命名本身就点明了框架的设计哲学——模型是节点,链是编排。
LangGraph 是 LangChain 团队推出的底层编排运行时,用图结构描述智能体流程:节点是函数或模型调用,边是控制流,支持条件分支、循环、并行以及可持久化的状态(State)。相比早期 LangChain 的线性 Chain,图结构能自然表达"思考—调工具—再思考"这类循环,也便于加入人工审核中断点与断点续跑。LangChain 的高层智能体能力如今构建在 LangGraph 之上,这也解释了文中"底层走的是 LangGraph"的说法:上层提供开箱即用的封装,下层提供可控、可观测的编排能力,需要精细控制时可下沉到图这一层。
学习路径:官方文档是第一入口
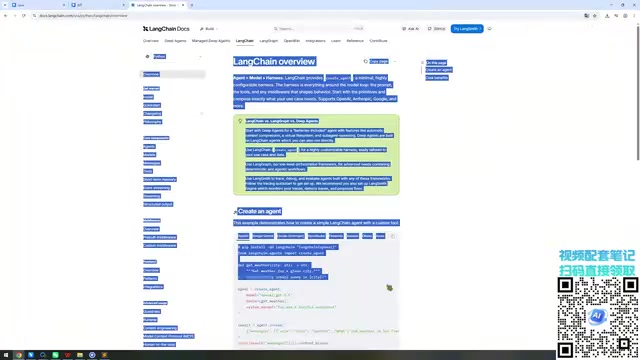
教程反复强调,学LangChain要多查官方文档,因为这个东西一直在迭代更新。官方站点上核心内容包括LangChain、LangGraph、Deep Agents以及LangSmith,文档里专门介绍了这几者之间的关系与区别。对英文不敏感的开发者可以看同步更新的中文文档——代码基本一致,翻译质量大部分可用,但最新更新仍以官方英文版为准。
从入门顺序看,先看Overview和快速开始、安装章节,建立整体认知:LangChain = 大模型 + 封装框架 + 工具集。官方文档中提到的Create Agent功能,是一个极其简单且高度可配置的封装入口,适合作为第一个动手实验的切入点。
LangSmith 是配套的可观测性与评测平台,用于追踪每次调用的完整链路(提示词、模型输出、工具调用、耗时与 token 消耗),支持数据集管理、离线评测与线上监控。智能体应用的调试难点在于链路长、行为不确定,仅靠打印日志很难定位问题出在哪一步,追踪视图能把一次运行的每个节点摊开来看。文中提到 LangSmith 与 LangChain、LangGraph 并列,正是因为"能跑通"和"能稳定维护"之间隔着一层可观测性,实际项目中建议在开发早期就接入,而不是等出问题再补。
对Agent开发者的意义
从这期教程的定位看,LangChain被摆在了"Agent开发或大模型应用开发工程师必须具备的框架应用能力"的第一位。这个判断在实践中站得住脚:知识截止、外部交互、状态保持这三个问题,几乎是每个落地项目都会撞上的墙。与其每个项目从零造轮子,不如先掌握一套成熟的编排框架,把精力留给业务逻辑和工具设计本身。
需要提醒的是,教程目前只覆盖了LangChain的定位、解决的问题和文档入口,Agent智能体搭建与RAG项目实战的具体内容尚未展开。真正动手时,建议按"官方快速开始 → Function Call工具调用 → Agent编排 → RAG检索增强"的顺序推进,每步都跑通最小可运行示例再往下走。
相关推荐

零基础用Claude Code搭建AI Agent:从工作区到云端自治
无需编程,用Claude Code桌面应用四步搭建AI Agent:从工作区配置、Agent Designer生成第一个智能体,到Skill固定流程、Memory自我进化,最终部署云端定时自治运行。

无需Python基础:Cursor AI编程如何重塑自动化测试与测试开发
测试工程师不学Python也能做自动化测试?本文梳理Cursor等AI编程工具如何赋能功能测试、自动化脚本、测试平台开发与性能调优,并对比国内外主流工具的成本与访问限制,给出测试人员的能力转型建议。

近5000人中招!AI编程插件被植入后门,官方紧急下架
Claude Code的VS Code扩展2.1.313版本被恶意篡改,植入后门可远程登录并持久化控制,最多5000名用户或受影响。官方已下架恶意版本,本文详解攻击手法与清理步骤。