LangChain入门指南:核心概念、Agent与RAG实战
LangChain 是围绕“智能体=模型+框架”构建的大模型应用开发通用脚手架。
文章基于 B 站实战课程与官方文档,系统梳理了 LangChain 的定位与入门路径。LangChain 被定义为“智能体 = 模型 + 封装框架”中的框架部分,类比 Spring 之于 Web 应用,它帮助开发者快速驱动大模型。其核心价值集中在三方面:借助联网工具突破模型训练时间边界获取实时信息;通过 RAG 与知识库连接外部数据和内部系统;提供多轮上下文与记忆管理机制。文章强调,用户日常使用的 DeepSeek 等产品已内置联网能力,并非裸模型交互。课程规划了简介、核心特点、快速入门、消息传递、模型调用、结构化输出、工具与短期记忆七个模块,并建议有 Python 基础的开发者从 LangChain 起步,中英文文档对照阅读。
LangChain 是大模型应用开发领域最常被推荐的入门框架之一。对于已经掌握 Python 的开发者来说,它往往是接触 AI 应用开发时第一个上手的工具。虽然整体难度不高,但细节内容相当丰富。本文基于 B 站的一节实战课程,结合官方文档与代码演示,梳理 LangChain 的核心概念、使用场景与快速入门路径,帮助读者建立清晰的认知框架。
LangChain 是什么:智能体 = 模型 + 框架
课程开篇给出了一个简洁的定义:智能体(Agent)= 模型 + 封装框架。这里的「模型」指 DeepSeek广告、Claude、GPT 等大语言模型,而「封装框架」正是 LangChain 这类生态。英文文档中对应的表述是 Agent = Model + Harness,LangChain 本质上就是围绕 Harness 构建的一套解决方案。
据 B 站 UP 主的讲解,各家厂商(如 OpenAI、DeepSeek)都推出了类似套路,方向略有差异——有的走差价维度,有的走自有生态,而 LangChain 胜在通用性较强、官方文档健全,从入门 demo 到代码示例都有提供,因此前期建议直接从 LangChain 入手。
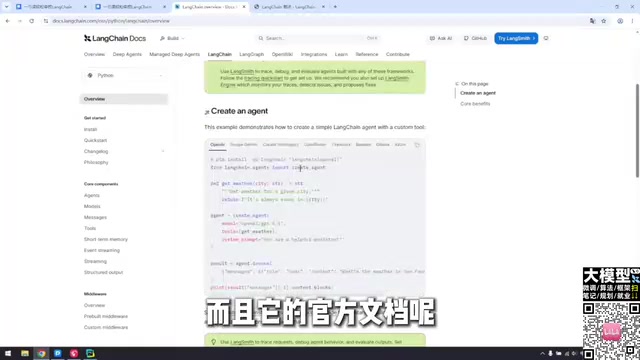
LangChain 的定位是「用于开发大语言模型驱动应用程序的开源框架」。类比来说,Spring 帮你快速驱动 Web 应用,LangChain 则帮你快速驱动模型。它不只是对模型调用 API 做封装,工具调用、上下文管理等能力都已在生态内部集成好,开发者无需从零搭建复杂架构。
三大核心问题:LangChain 到底解决什么
课程将 LangChain 的价值归纳为三个主要方向。需要说明的是,这并非全部能力,但属于最常被感知的部分。
突破模型的知识时间边界
大模型并非无所不知,它只知道训练时间点之前的事情。比如模型在六月份完成训练,你问八月份发生的事,它就无法回答。模型本身没有能力直接调用工具或访问外网,它只能「意识到」自己不知道,却无法自行查询。LangChain 生态提供的联网工具可以补上这一环。
UP 主特别提醒:大家平时在 DeepSeek 等产品里聊天,那已经不是纯粹跟模型交互——产品内部已经提供了访问外网的能力,本身更接近知识库或智能体的形态。纯粹的模型无法关联外网去获取实时信息。
知识截止日期(Knowledge Cutoff) 是大模型训练数据的时间边界,模型参数由此前采集的语料固化而来,训练完成后不再更新。因此模型对截止日期之后的事件确实“不知道”,但它在对话中往往仍会给出看似自信的回答,这一现象被称为幻觉(Hallucination)。联网工具(如 LangChain 集成的搜索或抓取工具)在推理阶段把实时检索结果作为上下文拼入提示词,使模型基于外部信息作答,从而绕开参数内的静态知识限制。这与微调不同:微调会改变模型权重,成本高且同样存在新的截止时间;而工具调用属于运行时增强,信息永远保持新鲜。
连接外部数据与内部系统
RAG(检索增强生成)和知识库是当前的高频场景,涉及向量数据库、溯源等环节,而模型本身不具备这些能力。LangChain 可以承担这部分工作,包括访问公司内部数据库、对接外部数据源等。
RAG(Retrieval-Augmented Generation,检索增强生成) 的基本流程是:先把文档切分成片段(chunk),用嵌入模型(Embedding Model)将每段转成向量并存入向量数据库;用户提问时,同样把问题向量化,在库中做相似度检索,取回最相关的若干片段,连同原问题一起拼进提示词交给大模型生成答案。它解决的是模型参数中不含私有或最新知识的问题,同时因为答案可追溯到具体文档片段,天然支持溯源。向量数据库是专为高维向量近似最近邻检索设计的存储系统,常见实现包括 FAISS、Chroma、Milvus、pgvector 等。LangChain 的价值在于把文档加载、切分、嵌入、检索、拼装提示词这些环节抽象成可组合的组件,开发者只需替换其中某一环,而不必重写整条链路。
多轮上下文与记忆管理
正常来说,模型是一问一答:你发一句,它回一句,再问时它不会参考之前的对话。而人类期望的是多轮上下文沟通——第二句问题能基于第一句的语境来回答。LangChain 提供了上下文管理机制,把这些事情变得容易处理。当然开发者自己也能实现,但框架大幅降低了复杂度。
大模型本身是无状态的:每次 API 调用都是一次独立请求,模型不会记住上一次对话。所谓“多轮对话”,实际上是客户端每次把历史消息一并重新发送给模型。消息通常按角色区分:system 设定人设与规则,user 是用户输入,assistant 是模型此前的回复。随着轮次增加,历史消息会不断膨胀,最终触及模型的上下文窗口(Context Window)上限并推高 token 成本。因此记忆管理的关键在于取舍策略,例如只保留最近 N 轮、对早期对话做摘要压缩,或把关键事实抽取后存入外部存储再按需召回。LangChain 把这些策略封装为不同的 Memory 组件,这也是“短期记忆”与“长期记忆”区分的由来。
课程覆盖的知识模块
这节课程规划了七个模块,从概念到代码逐层推进:
- LangChain 简介:面向不熟悉框架的听众建立基本认知
- 核心特点:结合官网文档讲解,官方对特点有清晰介绍
- 使用场景与快速入门:入门代码非常 easy
- 消息传递方式:模型交互中的消息角色与结构
- 模型调用方式:不同调用模式的代码演示
- 结构化输出:让模型返回可解析的结构化结果
- 工具与短期上下文记忆:受直播时间限制,部分内容未能展开
课程配套笔记可通过对应代理老师领取,直播间也提供了二维码入口。
为什么建议从 LangChain 起步
综合课程观点,选择 LangChain 作为大模型应用开发第一站的理由有三点:难度不大、官方文档健全、生态通用性强。对于具备 Python 基础的开发者,第一个动手实践的框架通常就是它。LangChain 把工具调用、外部数据访问、上下文管理这些「看似一个词、实则关乎很多细节」的能力集成在生态内部,让开发者不必从零搭建复杂架构。
需要留意的是,框架降低了入门门槛,但细节仍需结合官方文档逐一过一遍。课程建议中英文文档对照阅读——英文文档描述最清晰,中文文档可作为辅助。
总结
LangChain 的定位可以概括为:大模型应用开发的通用脚手架。它围绕 Agent = 模型 + 框架 的公式,补齐模型在实时信息获取、外部系统交互、多轮记忆三方面的短板。对于准备进入 AI 应用开发的 Python 开发者,从 LangChain 的核心概念和官方文档入手,配合代码跑通基础功能,是一条经过验证的入门路径。
相关推荐

Gemini 4 Hydrogen 对比测试:仅耗1%周配额,表现不输Sonnet
实测Gemini 4 Hydrogen与Sonnet完成同一CRUD任务:Hydrogen仅耗1%周配额,表现相当且UI细节更优,而Anthropic模型耗7%。开发者建议日常任务不必迷信高价模型。

Gemini 4 Neon发布:多项基准超越Opus 5.5,谷歌重回第一梯队
谷歌DeepMind发布Gemini 4 Neon,Artificial Analysis智能指数61分排名第三,编程指数登顶第一,多项基准超越Opus 5.5,定价每百万token输入3美元输出15美元,已在Gemini API和AI Studio开放。

Gemini 4 Neon评测:跑分直逼Carbon,API性价比解析
Google Gemini 4 Neon 全面评测:跑分直逼 Carbon,API 定价为 Hydrogen 两倍,Antigravity 额度消耗仅一倍而 Carbon 为三倍,实测可替代 90% Carbon 场景。附渠道限制、封号风险与组合策略分析。