OPO:用排序替代固定裁剪的PPO改进方案
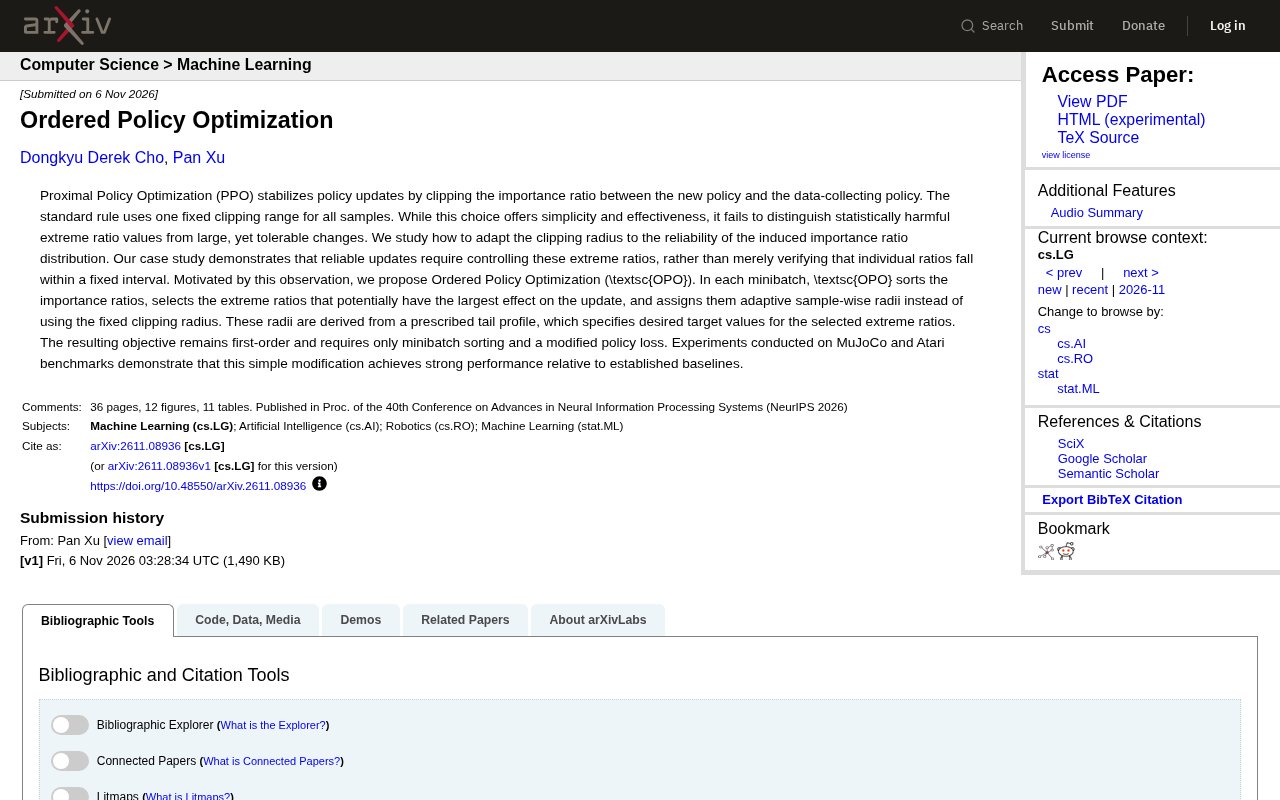
OPO质疑PPO固定裁剪半径,用排序加尾部轮廓实现自适应逐样本裁剪。
论文指出PPO的固定裁剪半径无法区分统计上有害的极端重要性比值与大但可容忍的策略变化,真正决定更新可靠性的是比值分布的尾部形态。为此作者提出Ordered Policy Optimization(OPO):在每个minibatch内对重要性比值排序,识别极端样本,并依据预设的尾部轮廓为其分配自适应的逐样本裁剪半径,将分布尾部引导至期望位置。该方法实现轻量,目标函数仍为一阶,仅增加排序和策略损失修改,可直接嵌入现有PPO流程。在MuJoCo和Atari基准上,OPO相对已有基线取得强劲表现,为PPO的超参数设计提供了低改动、有统计动机的改进路径。
PPO(近端策略优化)自提出以来一直是强化学习领域最常用的策略梯度算法之一,其核心稳定机制——对重要性比值(importance ratio)做固定范围的裁剪——几乎成了默认配置。但一篇新论文对这一约定俗成的做法提出了质疑:固定裁剪半径真的能区分"有害的极端比值"和"大但可接受的策略变化"吗?作者提出的 Ordered Policy Optimization(OPO)给出了一个颇具巧思的替代方案。
固定裁剪的盲区
PPO 的裁剪规则对所有样本一视同仁:重要性比值超出固定区间(如常见的 [1-ε, 1+ε])就截断梯度。这种统一处理的好处是简单有效,但论文指出,它无法区分两类截然不同的情况——一类是统计上真正有害的极端比值,另一类是数值虽大、但反映的策略变化仍在可容忍范围内的比值。
作者通过案例研究进一步说明:可靠的策略更新需要控制重要性比值分布的尾部(即那些极端值),而不只是逐个检查每个比值是否落在固定区间内。换句话说,固定裁剪半径的假设是"区间内即安全",但实际起决定作用的是整体分布中极端值的形态。这个观察构成了 OPO 设计的出发点。
重要性比值(importance ratio) 是策略梯度算法中的核心量,定义为新策略与旧策略在同一状态-动作对上的概率之比 $r_t(\theta)=\frac{\pi_\theta(a_t|s_t)}{\pi_{\theta_{\text{old}}}(a_t|s_t)}$。它衡量策略更新前后对某个动作偏好程度的变化:$r_t=1$ 表示未变,$r_t>1$ 表示新策略更倾向该动作,$r_t<1$ 则相反。在重要性采样框架下,策略梯度的无偏估计需要对 $r_t$ 加权,但当新旧策略差异过大时,$r_t$ 可能出现极端值,导致梯度方差爆炸或更新方向失真。PPO 的裁剪正是为了抑制这种风险:将 $r_t$ 限制在 $[1-\epsilon,1+\epsilon]$ 内,使超出范围的样本不再贡献梯度。理解这一点有助于把握 OPO 的改进动机——固定区间只约束单个比值的大小,却不关心整个比值分布的尾部形态。
OPO 的核心机制
OPO 的做法在每个 minibatch 内展开:先对重要性比值排序,识别出可能对更新影响最大的极端比值,然后为这些样本分配自适应的逐样本裁剪半径,而不是沿用统一的固定半径。
这些半径并非随意设定,而是来自一个预设的"尾部轮廓"(tail profile)——它规定了被选中的极端比值应当达到的目标值。这样,裁剪就不再是生硬的截断,而是一种有方向性的引导:把分布尾部拉向期望的位置。
实现层面,论文强调改动非常轻量:目标函数仍是一阶的,额外开销仅限于 minibatch 内的排序操作和对策略损失的修改。这意味着 OPO 可以直接嵌入现有的 PPO 训练流程,不需要重构优化器等基础设施。
尾部轮廓(tail profile) 是 OPO 引入的约束目标,可以理解为一组关于重要性比值分布尾部的期望取值。具体而言,算法在每个 minibatch 内按 $r_t$ 排序后,选出最极端的若干样本(如最大和最小的若干个比值),并为它们设定目标值——这些目标值由尾部轮廓函数给出,而不是统一的 $1\pm\epsilon$。随后,逐样本裁剪半径被反推为使这些极端比值恰好被拉向目标值所需的边界。这样做的效果是:裁剪不再对每个样本独立判断“是否越界”,而是从分布层面塑造尾部,使极端比值被有序地压缩到预设形态。尾部轮廓的具体形式(如线性、指数衰减等)是该方法的关键设计选择,直接影响裁剪的松紧程度。
实验结果与意义
论文在 MuJoCo 和 Atari 两个经典基准上进行了实验,结果显示这一简单修改相对已有基线取得了强劲的表现。考虑到这两个基准分别代表连续控制和离散决策两类主流场景,结果的覆盖面有一定说服力。
从更宏观的角度看,OPO 的价值在于重新审视了 PPO 中最少被质疑的超参数设计。裁剪半径固定不变是一个便利的工程选择,但并非理论上的必然。用排序加尾部轮廓的方式让裁剪随分布自适应,提供了一条几乎无额外成本、却有明确统计动机的改进路径。对于日常使用 PPO 训练策略的研究者和工程师来说,这种"低改动、可插拔"的方法值得关注和尝试。
当然,论文目前只给出了基准层面的验证,尾部轮廓的具体设定方式、在不同任务上的敏感性,以及它与 KL 约束类方法的相对优劣,仍有待后续工作展开。
KL 约束类方法 是 PPO 裁剪之外的另一条策略更新控制路线,代表算法如 TRPO。TRPO 通过约束新旧策略之间的 KL 散度不超过阈值来保证更新幅度可控,理论上更严谨,但需要对目标函数做二阶近似并求解带约束的优化问题,计算成本较高。PPO 的裁剪机制可视为对 TRPO 的一种一阶简化。OPO 与 KL 约束类方法的区别在于:KL 约束控制的是策略分布的整体差异,而 OPO 通过尾部轮廓直接干预重要性比值分布的极端部分。两者并非互斥——OPO 的逐样本裁剪仍是一阶操作,可以与 KL 惩罚项共存。论文将 OPO 与 KL 类方法的相对优劣列为待研究问题,正是因为二者在约束对象和计算开销上各有取舍。
相关推荐
FBI警告的AI黑客工具ARTEX:成本颠覆与防御重构
FBI警告的AI黑客工具ARTEX让渗透测试成本降至150-1500美元,导致金融机构数据泄露和供应链攻击。了解其工作原理、真实案例及五步防御策略。
FBI警告:ARTEX AI黑客工具三小时攻破系统
FBI警告开源AI渗透测试框架ARTEX被犯罪分子滥用,部分入侵在三小时内获得特权访问,超1600个控制台暴露在外,并涉及韩国金融机构数据泄露与ConnectWise供应链攻击。
FBI警告Artex:AI自动化攻击框架威胁云身份安全
FBI警告AI渗透测试框架Artex正被用于自动化攻击:Go编写、AI代理驱动,覆盖侦察到数据窃取全链路。本文解析其对云身份与权限安全的真实威胁及防守重点。