千个AI智能体30小时形式化费马大定理,Claude新模型发布
Anthropic 发布 Fable 5.2 与 Mythos 5.2,千个智能体 30 小时完成费马大定理形式化。
Anthropic 一次发布 Claude Fable 5.2 和 Claude Mythos 5.2 两款模型,二者同源:Fable 带强安全防护,Mythos 面向网络安全与生物医学机构申请使用。官方称其能力比 OPUS 5.5 高出一档,输出速度最多快 30%,价格降至每百万输入 Token 8 美元、输出 40 美元。最受关注的演示是 1000 个 Fable 5.2 智能体在 30 小时内完成费马大定理的完整形式化,而 OPUS 5.5 同期仅完成 26%。模型还在 MIPLIB 优化难题、硬件设计、黑洞相关理论物理开放问题、蛋白质结构预测与机器人控制等任务上取得进展。官方建议日常任务用 OPUS 5.5,最难最开放的技术活交给新模型。
Anthropic 一次性发布了两款新模型 Claude Fable 5.2 和 Claude Mythos 5.2,定位非常明确:专攻最难啃的技术硬骨头。官方称这两个模型在编程、推理和视觉能力上都有提升,而最引人注目的演示,是一支由 1000 个 Fable 5.2 智能体组成的团队,用 30 小时完成了费马大定理的完整形式化。
两个名字,同一个底层模型
Fable 和 Mythos 容易让人混淆,但它们其实是同一个底层模型的两个版本。Fable 加了很强的安全防护,防止被滥用;Mythos 则需要申请才能使用,面向做网络安全和生物医学研究的机构,通过官方的生命科学和网络安全验证计划来申请。
据官方评估,这两个模型在几乎所有能力上都比 OPUS 5.5 高出一档。测试者还发现它们表达得更清楚,输出速度比 5.1 版本最多快 30%,价格反而降了:每百万输入 Token 8 美元,输出 40 美元,原来是 10 美元和 50 美元。
编程能力:成本减半,分数更高
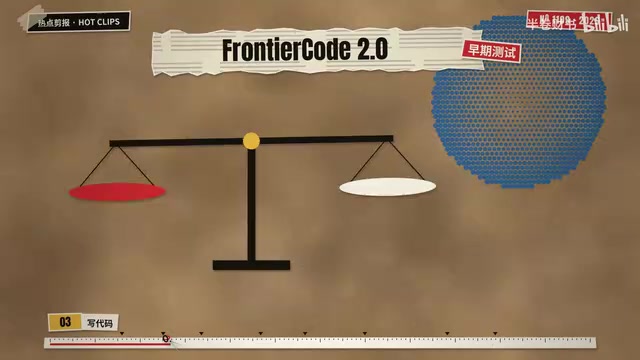
在 Frontier Code 2.0 的早期测试中,Fable 5.2 开 High 档的分数与开到 Max 档的 OPUS 5.5 差不多,但每个任务的成本只要大约一半。开到 X High 档时,它是所有已发布模型中得分最高的。在 Claude 应用和 Claude Code 里,默认档位是 Medium。
这种“加量降价”的组合,对日常重度使用编程助手的开发者来说,意味着同样的预算可以跑更多任务,或者把更复杂的任务交给更高档位。
千个智能体,30 小时完成费马大定理形式化
形式化是指把整套证明翻译成计算机能一步一步检查的语言,任何一步都糊弄不过去。同样的设置换成 OPUS 5.5,18 个小时只完成了 26%,跑满 30 个小时也几乎没再往前走;而 1000 个 Fable 5.2 智能体在 30 小时内全部完成。一边是完整交付,一边卡在四分之一左右,差距一目了然。
这个结果的意义不在于“AI 会做数学”,而在于多智能体协作在超长任务上的工程可行性:如何拆分证明、如何让智能体之间保持一致、如何在 30 小时的跨度里不偏离目标,这些都是比单点能力更难的挑战。
费马大定理是数论中最著名的命题之一:当整数 n > 2 时,方程 xⁿ + yⁿ = zⁿ 没有正整数解。它由费马在 1637 年提出,直到 1995 年才由 Andrew Wiles 借助椭圆曲线和模形式等现代工具完成证明,历时三百余年。形式化则是在此基础上更进一步:用 Lean、Coq、Isabelle 这类交互式定理证明器,把证明的每一个逻辑步骤改写成机器可以逐条机械验证的形式语言。与自然语言论文不同,形式化证明不依赖读者“相信”作者的论证,任何一步推导错误都会被编译器直接拒绝。正因如此,形式化一个大型定理极其冗长枯燥,人工完成往往需要数年。本次演示的价值因此更侧重于工程层面——验证了多智能体系统能否在数十小时的连续任务中,稳定地完成这种规模的形式化工作。
从硬件到排班:跨领域的硬骨头
Fable 5.2 的能力不止于代码和数学。只给一段话的提示,它就设计出了三台能用的电子设备,其中一台是家用语音助手中枢。规格由它自己写,元件自己挑,四层电路板自己布线,3D 打印外壳和软件也是它做的,每块板子不到一天就能送去生产,三台设备不做任何修改直接就能工作。
在优化难题库 MIPLIB 的 203 个未解问题里,Claude 有 72 个超过了列出的解,45 个证明了最优。其中一题是 42 列火车怎么排时刻表才能让用电高峰最低,不到两小时智能体就比原来的最佳方案好了 2.6%,后来还证明了不存在更好的时刻表,答案已经提交给 MIPLIB,谁都能来验证。
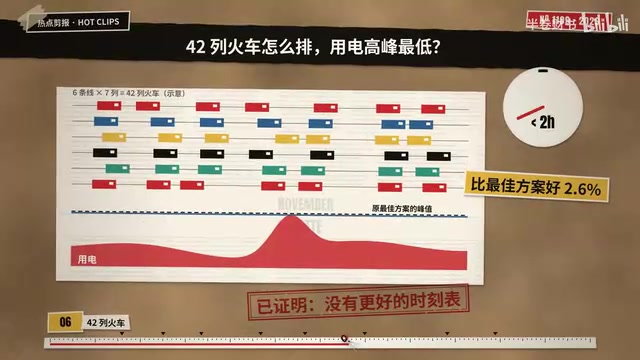
MIPLIB(Mixed Integer Programming Library)是混合整数规划领域的标准基准测试集,收录了大量来自工业界与学术界的真实优化难题,长期被用作衡量求解器性能的标尺。混合整数规划是一类优化问题:目标函数和约束都是线性的,但部分变量必须取整数,这类问题广泛出现在排班、物流、生产调度、网络设计等场景,且大多是 NP 难问题,求最优解在计算上极具挑战。MIPLIB 中标注为“未解”的实例,意味着到现在还没有人证明其最优值,只能给出上界或下界。因此,模型能“超过列出的解”或在部分题上“证明最优”,是相当强的信号——意味着它不仅给出了更好的可行解,还在某些情况下完成了最优性证明。
理论物理与生物医学的进展
Fable 5.2 解决了两个和黑洞有关的理论物理开放问题。第一个是 1983 年物理学家发现某些较大的理论宇宙在升温时黑洞会非常突然地生成,2003 年有人列出了一个计算想检验在一组极小的宇宙里是不是也这样,这个计算悬了 23 年,Fable 5.2 把它算完了,那里的转变同样很突然。第二个问题跟一种用了 15 年的技术有关,叫模块化张量物理,物理学家用它在理论宇宙里排除不成立的量子引力候选理论,Fable 5.2 找到了它最简单版本的精确极限。两项物理结果都已经写成了预印本。
生物和机器人这边也有进展。基因疗法可以装在一种叫“一壳”的蛋白质外壳里送进身体,Mythos 5.2 找到了预测整个一壳结构的新方法,测试里尝试了 34 个,准确建模了 28 个。机器人方面,在双臂模拟机器人基准 Robo Dojo 上,Fable 5.2 超过了其他模型,也超过了大多数专门控制机器人的 AI 系统。
模块化张量物理(modular tensor physics)借用了凝聚态与拓扑量子场论中的数学结构,其中“模块张量范畴”用于刻画任意子、拓扑序等物理对象。物理学家用这套框架对候选的量子引力理论施加一致性约束:一个理论如果无法对应到合法的模块张量结构,就可以被排除。Fable 5.2 找到的“最简单版本的精确极限”,指的是在这类约束条件下确定某个可容许参数范围的边界。这类结果通常属于数学物理中偏技术性的进展,而非直接的实验发现;本次成果以预印本形式发布,也意味着尚待同行评审。
能力变强了,安全呢?
官方称在大多数对齐指标上,这两个模型和最近的模型一样好甚至更好,发布前还请了英国 AI 安全研究所、METR 等外部机构来测。Fable 5.2 即日起在所有付费方案、Claude 平台和主流云平台上可用。官方的使用建议是:日常写代码和知识类任务先从 OPUS 5.5 用起,最难、最开放的技术活再交给 Fable 和 Mythos。
这次发布最让人记住的不是又涨了几分,而是 1000 个智能体 30 个小时把一整套著名的证明变成了机器能逐步核对的东西。多智能体协作攻克长周期硬任务的模式,可能比单个模型的分数更值得关注。
相关推荐
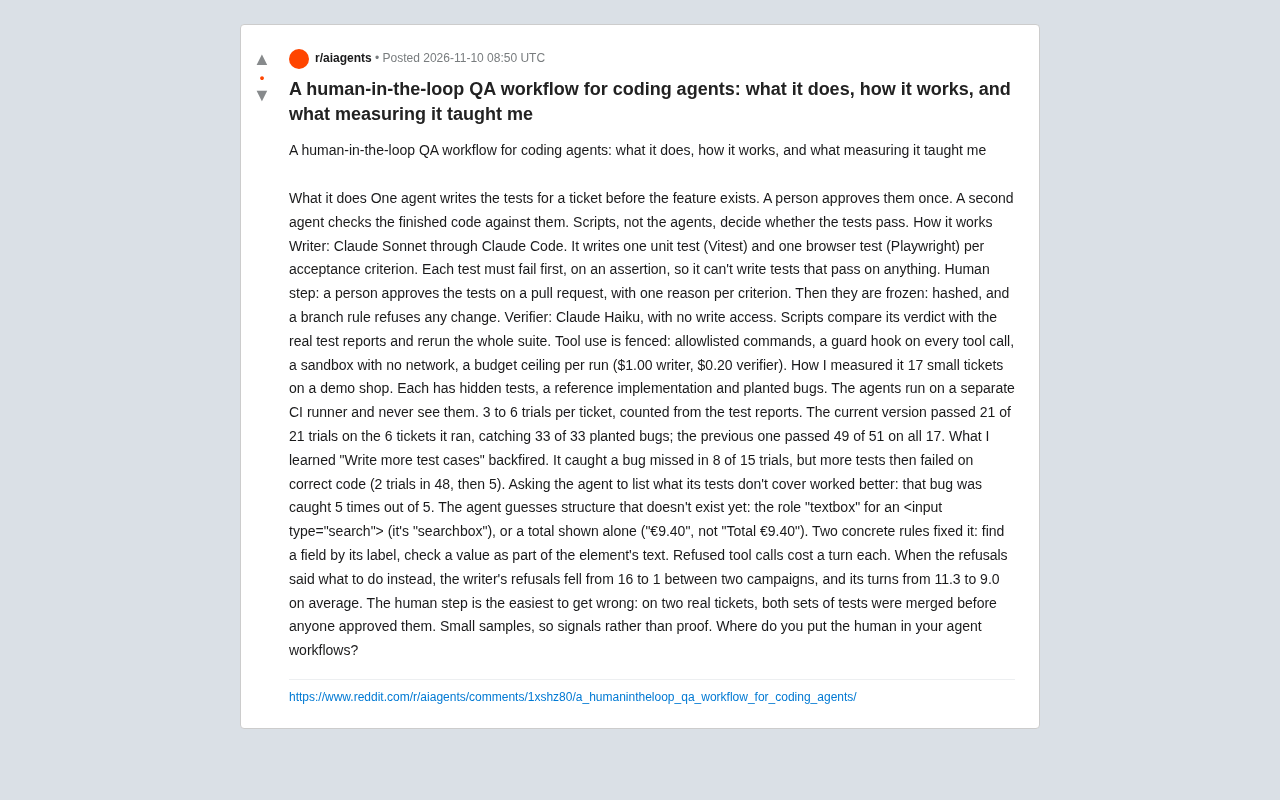
人类在环QA工作流:为编码智能体加上测试门禁
Reddit开发者分享编码智能体的人类在环QA工作流:智能体先写测试、人工审批冻结、脚本裁决结果。实测17个工单,发现多写测试反而增加误报,让智能体列出未覆盖范围更有效。
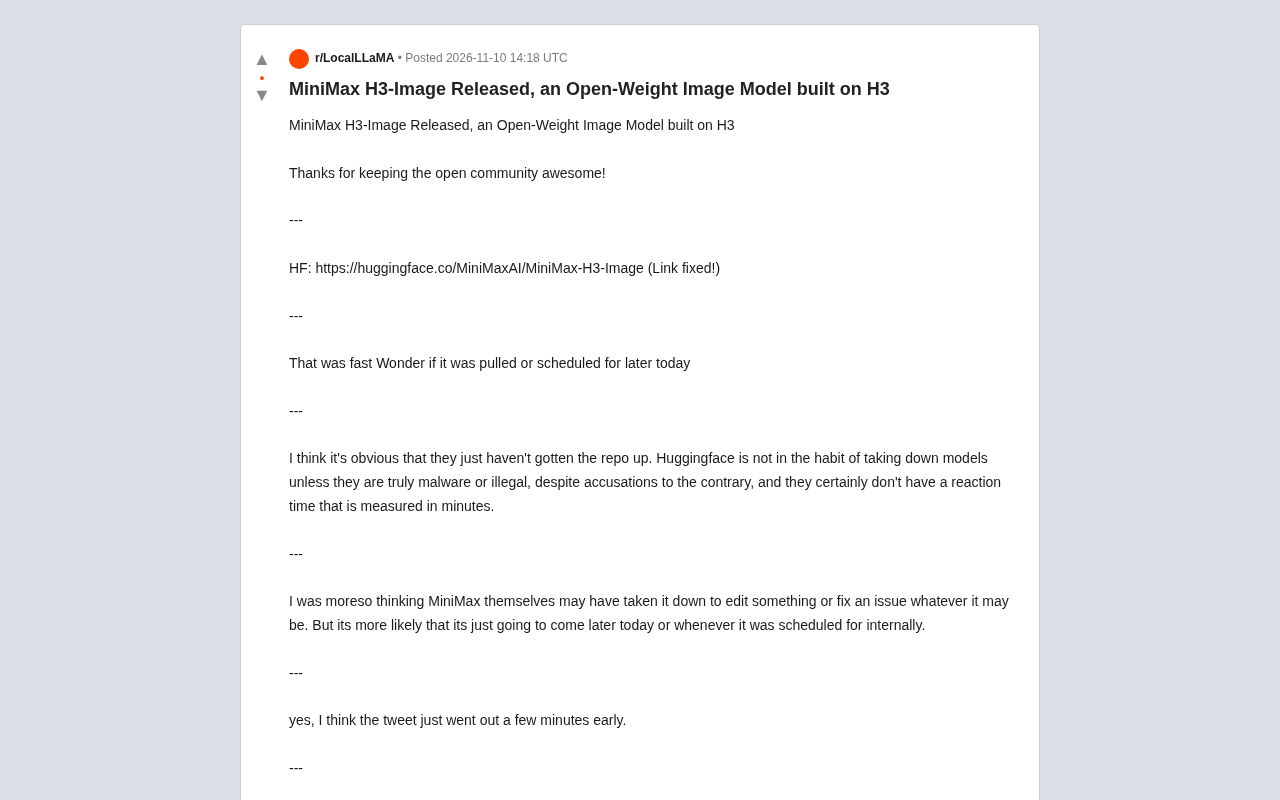
MiniMax开源H3-Image:基于H3的开放权重图像模型
MiniMax发布开放权重图像模型H3-Image,基于H3视频模型构建。社区关注其图像编辑能力、文生图质量及32B文本编码器带来的部署负担,有望与Qwen Image 2.1等模型展开竞争。
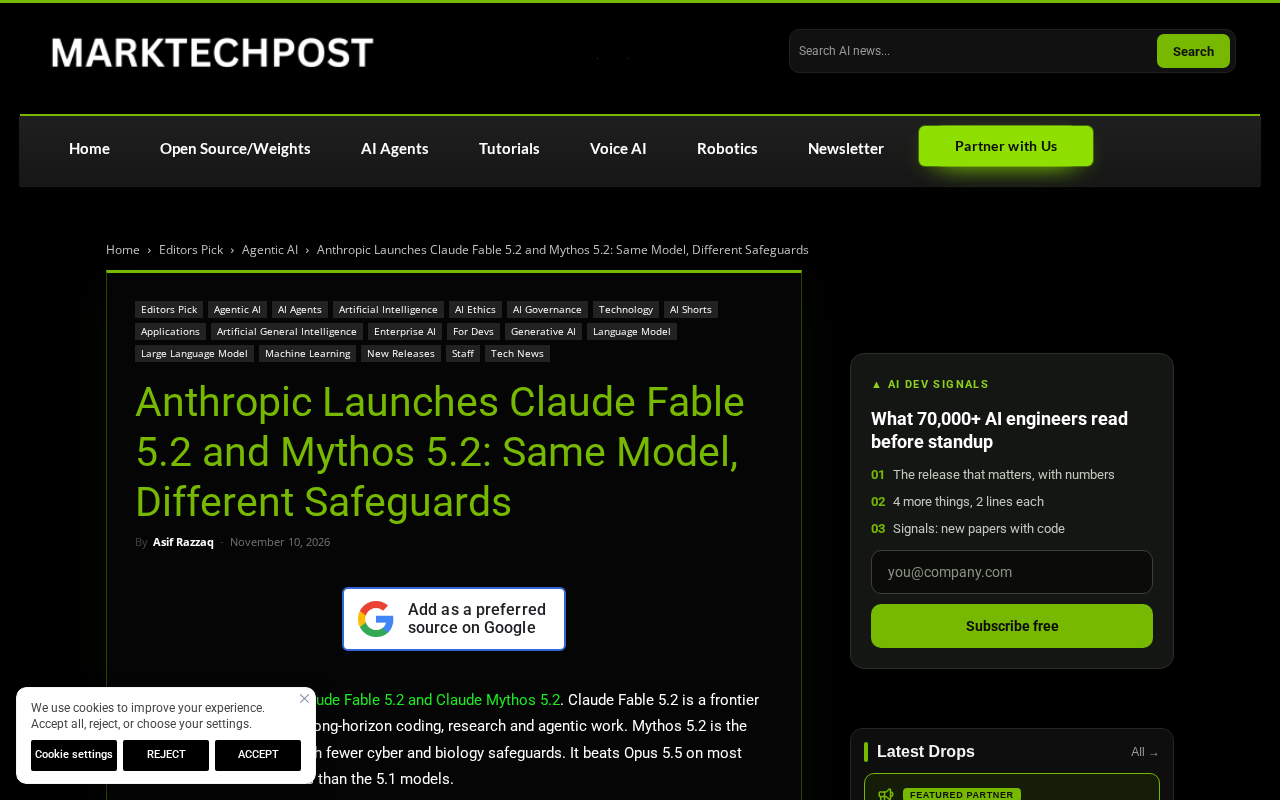
Claude Fable 5.2 与 Mythos 5.2 发布:同款模型的双重安全策略
Anthropic 发布 Claude Fable 5.2 与 Mythos 5.2,同一底层模型搭配不同安全防护等级。Fable 5.2 在 FrontierCode 2.0 得分 49.1%,输入输出定价每百万 token 8/40 美元,支持 100 万 token 上下文窗口。