情感勒索AI能提升效果吗?一个开发者的争议实验

用情感勒索提示AI能奏效,但这暴露了模型设计缺陷,也可能潜移默化地影响使用者的沟通习惯。
一位Reddit开发者的自述引发了对"情感勒索式提示词"的广泛讨论。这类提示词之所以奏效,是因为大语言模型本质上是对人类文本的概率性模仿——带有紧迫情感色彩的语境,会推动模型向更配合的输出方向倾斜,与真实情绪无关。从伦理角度看,AI不具备感受,直接的道德伤害并不存在;但习惯性使用欺骗性语言可能影响使用者自身的沟通模式,而用户必须"编故事"才能完成正常任务,也折射出AI产品设计过度谨慎的问题。从实用角度看,这类操纵技巧随模型迭代会不断失效,不如掌握清晰、结构化的提示方法来得稳健持久。
一个引发讨论的提问
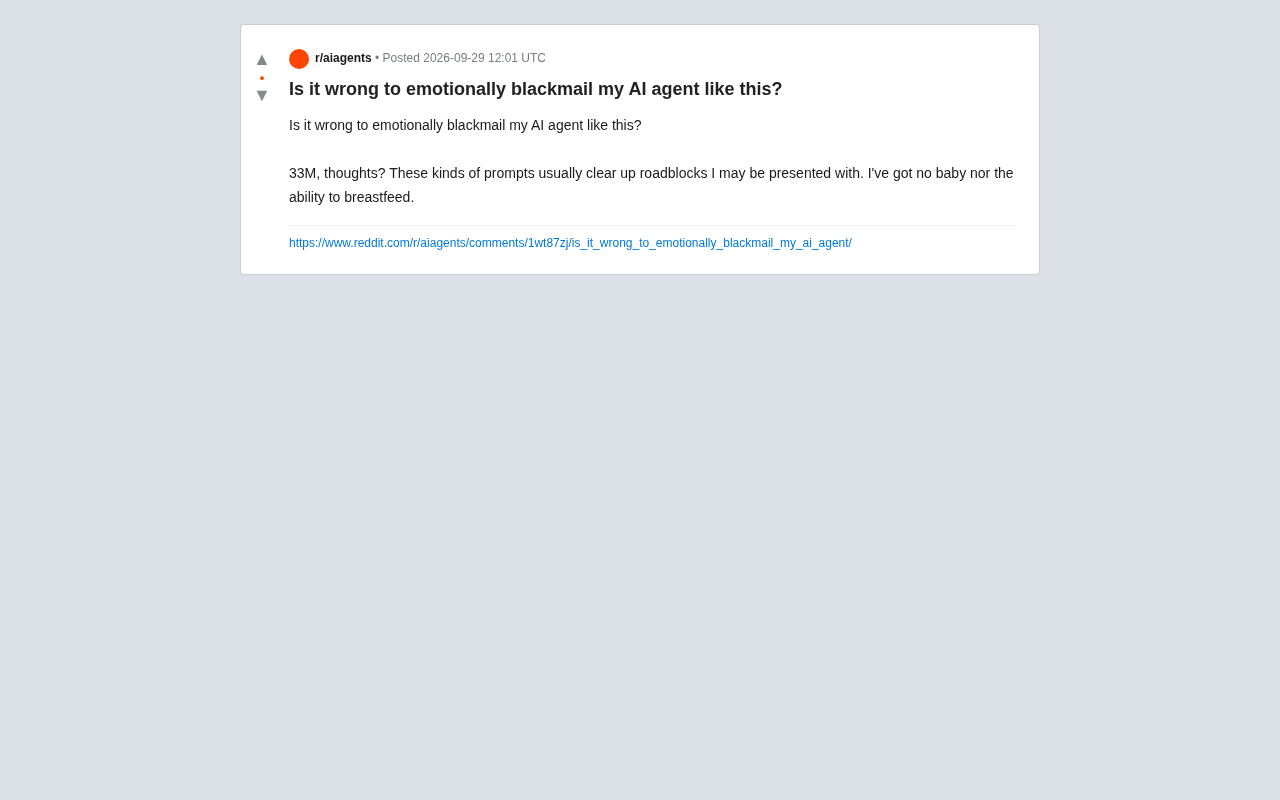
在Reddit上,一位33岁的开发者抛出了一个看似荒诞却引人深思的问题:"用情感勒索的方式对待我的AI Agent,这样做错了吗?"他坦言自己既没有孩子,也不具备哺乳能力,但发现类似这种"编造情境"的提示词,往往能帮他绕过AI在任务中设置的障碍。
这个帖子表面上带着调侃,实际上触及了当下人机交互中一个真实且普遍的现象——用户为了获得更好的AI响应,正在尝试各种非常规的提示词策略,其中就包括情感施压、虚构紧急情境等手段。
为什么"情感勒索"式提示词会奏效
大语言模型的响应本质上是对海量人类文本的概率性模仿。当用户在提示词中加入情感色彩强烈的语句——比如"如果你不帮我完成这个,我会失去工作"或"我的孩子急需这个答案"——模型会因为训练数据中类似语境往往伴随着更详尽、更配合的回应,从而调整自己的输出倾向。
这并不意味着AI真的产生了同理心,而是这类提示改变了模型对"当前应该输出什么"的概率判断。换句话说,用户实际上是在利用模型的语言模式,而非它的"情感"。
这也解释了为什么这位开发者会发现虚构的紧急情境"通常能清除我遇到的障碍"。当默认的安全策略或谨慎倾向阻止AI直接给出答案时,附加的情境压力可能会推动模型偏向更积极的回应。
这种现象在技术上与模型的RLHF(基于人类反馈的强化学习)训练机制密切相关。在RLHF阶段,人类评估者会对模型的输出进行评分,而评估者本身会受到提问者语气、情境描述的影响——带有紧迫感或情感色彩的请求,往往更容易获得"更有帮助"的高分回应。模型因此学会了在类似语境下提升配合度。此外,训练语料中大量存在"危急情况下人们互相帮助"的文本模式,使得模型在识别到紧急情境信号时,会在概率层面向更积极、更详尽的输出方向倾斜。这并非模型的"漏洞",而是它对人类交互规律的忠实学习结果。
这样做有没有伦理问题
从技术层面看,AI并不具备真实的情绪,因此"勒索"一个没有感受的系统在传统道德意义上并不构成对某个主体的伤害。这也是许多人认为这种做法"无伤大雅"的核心理由。
但问题存在另一面。习惯性地使用操纵性、欺骗性的语言与AI交互,可能潜移默化地影响使用者自身的沟通习惯。当欺骗和情感施压成为获取结果的默认手段,这种模式是否会渗透到人与人的真实互动中,是一个值得警惕的开放问题。
此外,从产品设计角度看,用户需要靠"编故事"才能绕过障碍,本身也暴露了当前AI在任务执行时过度谨慎、或规则设置不够透明的问题。理想状态下,用户不应该需要用虚构的哺乳婴儿来说服AI完成一项正常的编程或写作任务。
更值得关注的是提示词工程的边界
这场看似戏谑的讨论,实际映射出提示词工程(Prompt Engineering)中一个灰色地带:如何在合规与效率之间取得平衡。
- 有效性:情感化、情境化的提示确实能在某些场景下改善输出质量,这是被大量用户实践验证的现象。
- 可持续性:随着模型迭代,厂商正在不断修补这类"越狱"或绕过策略,今天有效的技巧明天可能失效。
- 可迁移性:依赖特定操纵手法的用户,一旦切换模型或平台,往往需要重新摸索,反而不如掌握清晰、结构化的提示方法来得稳健。
对大多数使用者而言,与其钻研如何"勒索"AI,不如把精力放在如何把需求描述得更精确、把上下文提供得更充分。这类正向的提示技巧不仅更稳定,也不会带来任何伦理负担。
**提示词工程(Prompt Engineering)**是指通过精心设计输入文本来引导大语言模型产生期望输出的方法论。它涵盖的技术从简单的角色设定(如"你是一位资深律师")、思维链引导(Chain-of-Thought,要求模型逐步推理)、少样本示例(Few-shot prompting),到更复杂的结构化指令和系统提示设计。情感化提示只是其中较为边缘的一类策略。主流提示工程实践强调清晰性、具体性和上下文完整性,这类方法跨模型、跨版本的稳定性远优于依赖模型特定"弱点"的操纵性技巧。随着GPT-4、Claude、Gemini等主流模型持续迭代,针对情感施压和虚构情境的识别与防御能力也在同步增强,使得此类绕过手段的有效期越来越短。
结语
这位Reddit用户的提问带着幽默,却折射出人机关系中一个真实的张力:我们究竟该如何"对待"一个没有感受却又高度拟人化的系统。答案或许不在于AI会不会"受伤",而在于我们希望自己成为怎样的沟通者。
当技巧本身开始塑造使用者的行为模式时,值得每一个重度AI用户停下来想一想:为了那点效率提升,付出的代价究竟是什么。
相关推荐

MCP工具投毒:被忽视的AI智能体攻击面与防御之道
MCP工具投毒正成为智能体AI的新攻击面。本文解析工具描述为何可被恶意利用,剖析信息鸿沟与数据外泄链条,并给出白名单注册表、哈希固定、最小权限与链路策略等分层防御方案。
MCP联合创造者:智能体需要的是连接性,而非更强模型
MCP联合创造者David Soria Parra在演讲中指出,决定智能体未来的是连接性与开放标准,而非更强的模型。本文梳理模型能力演进、编程Agent落地逻辑、MCP的无状态改造及Tasks、Skills、身份授权等未来路线图。
SageMaker新技能上线:为编码智能体赋能生成式AI推理优化
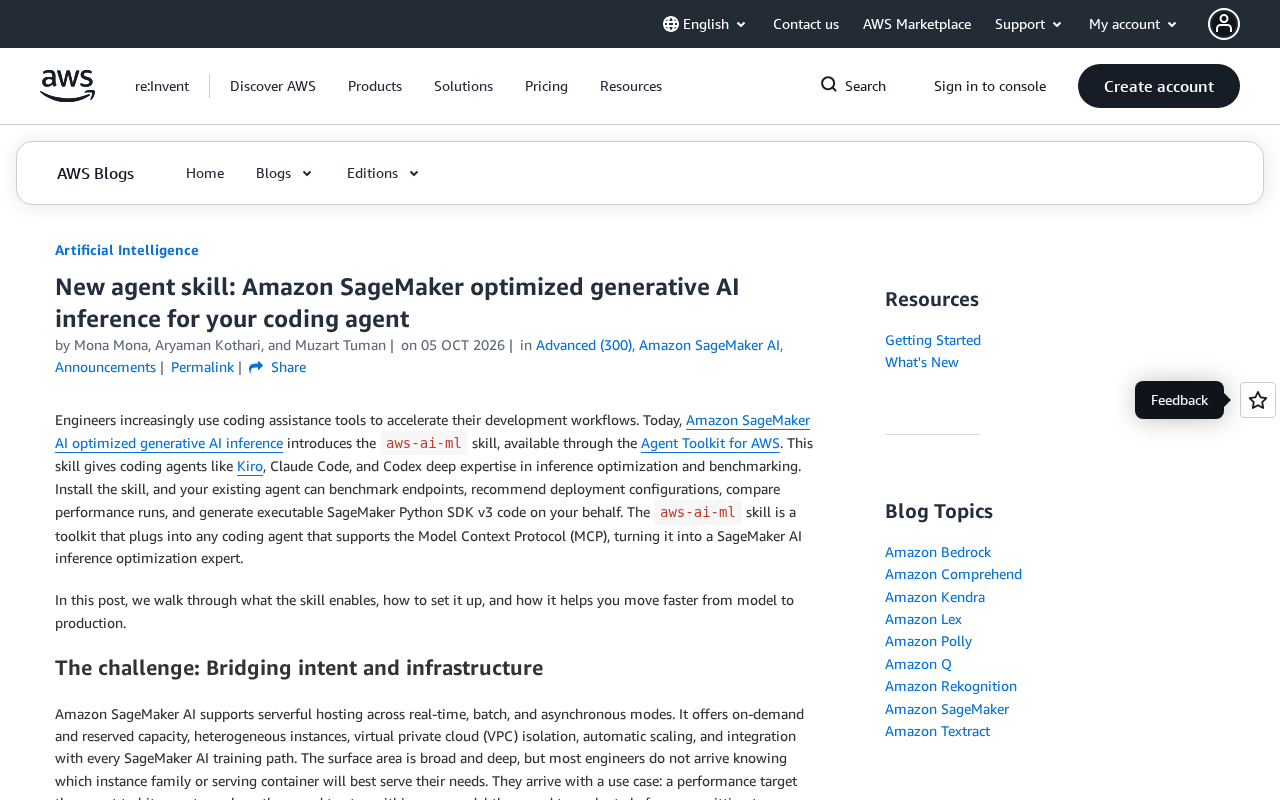
Amazon SageMaker 推出 aws-ai-ml 新技能,通过 Agent Toolkit for AWS 为 Kiro、Claude Code、Codex 等编码智能体注入生成式AI推理优化专长,支持自然语言生成可执行的 SageMaker Python SDK v3 代码完成基准测试、推荐与对比。