RAG是什么?用n8n工作流讲透检索增强生成

用图书馆比喻讲清RAG的两步本质、Embedding一致性与n8n实战搭建。
这篇文章借助图书馆比喻,把RAG拆解为检索、增强、生成三个动作,并强调任何RAG系统本质上只有两步:填充向量库(加载+切分+Embedding)和检索生成(查询+检索+生成)。核心洞察是Embedding模型如同图书管理员,建库与检索必须使用同一模型,否则向量空间错位会导致检索彻底跑偏。文章通过n8n演示了完整工作流:Default Data Loader切分PDF、text-embedding-3-small向量化、Pinecone存储、LLM生成答案,并用一个退款政策检索失败的案例说明故障多出在数据管道而非模型。最后展示了用Google Drive Trigger实现文档自动增量加载,将RAG从演示推向生产。
RAG到底是什么?一个图书馆的比喻就够了
很多人第一次听到RAG(Retrieval Augmented Generation,检索增强生成)时,会被这三个词绕晕。YouTube频道ET AI Masterclass在一节AI大师课里,用一个图书馆的类比把它讲得异常清楚。
Retrieval是"检索"——就像你去图书馆找书,把最接近问题的内容块(chunk)找出来;Augment是"增强"——把检索到的信息补充进上下文;Generation是"生成"——让大模型基于这些补充信息产出回答。三个词合起来,本质就是:先查资料,再答题。
这个比喻的价值在于,它把抽象的技术流程映射成了日常经验:向量数据库是图书馆,文档是藏书,Embedding模型是图书管理员,而LLM则是最终帮你组织答案的大脑。理解了这层映射,RAG的整个架构就不再神秘。
Chunk(文本块) 是RAG流程中的基本处理单元。由于大模型的上下文窗口有限,且检索粒度太粗会引入噪声,原始文档通常需要先被切分成较小的片段,每个片段称为一个chunk。切分策略(如按固定字符数、按段落、按语义边界)会直接影响检索质量:切得太碎会丢失上下文,切得太大则召回不精准。文章中演示时看到的"第一个chunk、第二个chunk",正是Default Data Loader按配置把PDF切分后的产物。
Embedding(向量化) 是把文本映射为高维数值向量的过程。语义相近的文本,其向量在空间中的距离也更近,因此可以通过向量距离来判断"哪段内容与问题最相关"。文章提到Pinecone中的512维向量,指的就是每个chunk被Embedding模型转换成的一串512个浮点数,这串数字构成了该段文本在向量空间中的"坐标"。
所有RAG系统都只有两步
讲师在课上反复强调一个核心判断:任何RAG系统,无论多复杂,都只有两个步骤。
第一步:填充图书馆(Load Data Flow)。 把原始文档加载进来,切分成chunk,通过Embedding模型转成向量,存入向量数据库。这一步相当于图书管理员把书买回来、分类上架、编好目录。没有这一步,图书馆就是空的。
第二步:检索信息(Retrieval Flow)。 用户提出问题,系统用同一个Embedding模型把问题转成向量,去向量库里找最接近的chunk,把这些chunk连同原问题一起交给LLM生成答案。
这个"两步论"之所以重要,是因为它直接指出了RAG系统最容易出问题的地方——两个步骤里必须使用同一个Embedding模型。
Embedding模型就是你的图书管理员
这是整节课最有洞察力的部分。讲师用了一个换管理员的场景来说明Embedding的重要性。
假设图书馆已经建好了,书都上架了。第二天原来的管理员请假了,来了一个新管理员。你问他"某本书在哪",他完全不知道——因为书不是他摆的,目录不是他编的。他会随便指一个方向,甚至让你"去屋顶找找"。
Embedding模型就是这个管理员。如果建库时用的是模型A,检索时换成了模型B,两个模型对"相似"的定义完全不同,向量空间对不上,检索结果就会彻底跑偏。
讲师还补了一层:好的管理员需要有经验,知道什么书该放哪个区——原子的运动属于物理区而不是化学区。这对应的是Embedding模型的质量差异。他同时指出一个实际约束:Embedding不是免费的,text-embedding-3-small这类模型按调用量计费,成本比换一个更贵的模型低,但检索效果会有明显差距。
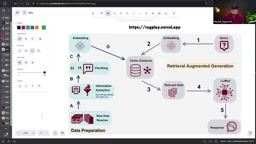
向量数据库 是专门用于存储和检索高维向量的数据库,常见产品包括Pinecone、Weaviate、Milvus、Qdrant等。它和传统数据库的核心差异在于:查询方式不是精确匹配字段,而是计算向量之间的相似度(常用余弦相似度或欧氏距离),返回"最接近"的若干条记录。这正好对应文章中"去向量库里找最接近的chunk"。选择向量库时通常要权衡延迟、规模、是否支持混合检索(向量+关键词)、运维成本等因素,文章中重建Pinecone索引的操作,本质上就是在重置这个检索层。
用n8n把RAG跑起来:从加载到检索
理论讲完,讲师在n8n里完整演示了一个可运行的工作流。整个过程分为两条独立的数据流,正好对应前面的两个步骤。
加载流程:文件进来,chunk出去
工作流的第一条链路从文件输入开始。讲师上传了一份包含学院教师信息的PDF文档,系统通过Default Data Loader把文档切分成多个chunk——在演示中可以清楚看到第一个chunk、第二个chunk、第三个chunk被依次切出。
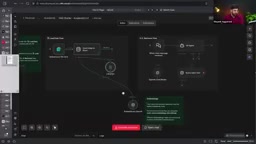
切分后的文本经过OpenAI Embedding节点转成向量。讲师特别澄清了一个常见误解:这里的Embedding模型是text-embedding-3-small,和ChatGPT是两回事,虽然都来自OpenAI,但用途完全不同。向量最终写入Pinecone向量数据库,形成"图书馆"。
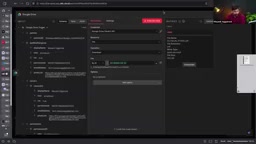
讲师展示了Pinecone里的实际数据:每条记录包含文本内容、chunk编号、来源行号,以及512维的向量坐标。他说,512维意味着每个chunk都在一个512维空间里有自己的位置,而人类只能理解三维空间,这中间的数学映射正是Embedding在做的事。
text-embedding-3-small 是OpenAI推出的一款轻量级Embedding模型,默认输出1536维向量,并支持通过参数调整输出维度(文章中出现的512维即通过维度参数压缩得到)。它与ChatGPT所属的GPT系列模型在用途上完全分离:GPT负责理解与生成自然语言,Embedding模型只负责把文本转成向量,不能用来对话。这种"对话模型"与"嵌入模型"分工的混淆,是初学者常见的认知误区,也解释了为什么讲师要专门澄清二者不是一回事。
检索流程:问题进来,答案出去
第二条链路从用户提问开始。讲师在聊天窗口输入"告诉我Rajesh Kumar Sharma的信息",工作流首先用同一个Embedding模型把问题转成向量,去Pinecone里检索最接近的chunk。
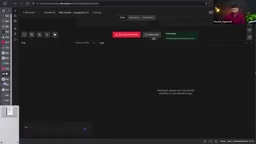
系统返回了四个相关chunk,LLM拿到这些chunk和原始问题后生成答案。讲师特意展示了一个关键细节:最终喂给LLM的上下文只有这四个chunk,而不是整份文档。这正是RAG的价值——不是把整本书塞给模型,而是精准定位到相关的那几页。
真实场景中的坑:一个翻车案例
演示过程中出现了一个很有教育意义的失败案例。讲师上传了费用结构文档后测试提问"退款政策是什么",系统返回了"数据集不包含相关信息"。
排查后发现两个问题:一是文档的chunking结果和预期不一致(72个chunk没有变化),二是检索时指向了错误的向量库。讲师没有跳过这个问题,而是当场重建了一个新的Pinecone索引,重新加载费用结构文档,确认13个chunk写入成功后再测试,这次顺利检索到了退款政策的具体条款——包括项目开始前取消和30天内取消的不同处理方式。
这个小插曲说明了一个在教程里很少被强调的事实:RAG系统出问题时,故障往往在数据管道而非模型本身。chunking策略、向量库选择、Embedding模型一致性,任何一个环节出错都会导致检索失败。
自动化加载:让图书馆自己进新书
课程后半段,讲师把加载流程做了自动化改造。不再手动上传文件,而是用Google Drive Trigger监控指定文件夹——只要有新文件放进这个文件夹,工作流自动触发,把文件内容加载、切分、embedding后写入Pinecone。
讲师把这个自动化节点比作"替你取书的采购员"。他还演示了增量更新的效果:上传新的教师档案后,Pinecone里的记录数从13条增加到了31条,说明新数据被正确追加进了向量库。
这套模式可以直接迁移到生产环境:把Google Drive换成企业数据库,把教师档案换成产品文档、客服知识库或内部政策文件,触发机制不变。讲师的建议是不要分散做十个不相关的小项目,而是围绕一个场景持续加深,把RAG的每个环节都吃透。
核心要点
- RAG的两个步骤——建库(加载+向量化)和检索(查询+生成)——是所有实现的基础框架
- Embedding模型决定了向量空间的结构,建库和检索必须使用同一个模型,否则检索结果不可用
- n8n可以用可视化工作流完整实现RAG,Default Data Loader负责切分,Pinecone负责存储,LLM负责生成
- Embedding调用有成本,text-embedding-3-small性价比高但与更贵的模型存在检索质量差距
- 用Google Drive Trigger等触发器可以实现文档的自动化增量加载,这是RAG走向生产环境的关键一步
相关推荐

Product Hunt 推出可视化发布编辑器,告别繁琐填写
Product Hunt 推出可视化发布编辑器,支持点击原位编辑名称、标语、画廊和 maker 信息,自动保存草稿,并用检查清单引导创作者完成发布。本文解析其编辑逻辑与对发布体验的影响。

泽连斯基亲述:俄军2000万人压境,我们如何守住基辅
泽连斯基访谈回顾俄乌战争初期:俄军200,000兵力直扑基辅,乌军主力却在东部。他讲述动员如何将军队从200,000扩张到800,000,以及基辅州、切尔尼戈夫州如何被收复。

Ovren Live Preview:用自然语言实时预览产品改动
Ovren Live Preview 是一款用自然语言描述改动、在真实页面上实时预览的 AI 开发工具。了解其核心功能、工作流、市场定位与潜在挑战。