RAG与Agent面试核心:检索增强生成全流程解析
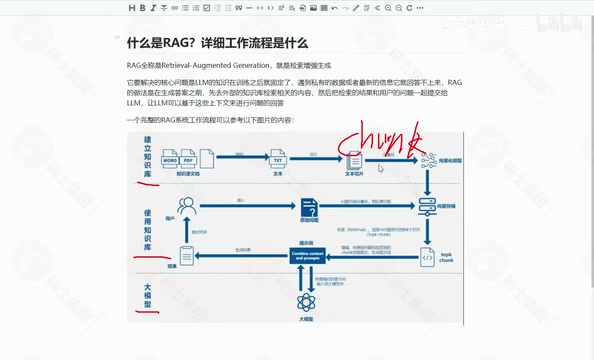
RAG通过实时检索外部知识并注入Prompt,解决大模型知识冻结问题,涵盖离线建库与在线检索生成全流程。
本文系统梳理了RAG(检索增强生成)的核心知识体系。首先解释为何需要RAG:大模型知识冻结、微调成本高且更新困难,而RAG通过实时检索外部知识库并将结果放入Prompt,让模型基于上下文作答。接着详细拆解RAG的两阶段流程:离线阶段包括文档加载、切割(chunk大小500-1000并设置重叠)、向量化(Embedding模型将文本转为语义向量)、入库(向量数据库);在线阶段包括查询改写、向量检索粗排、Rerank精排、生成(Prompt约束抑制幻觉)。最后总结RAG的核心价值——知识热更新与答案可溯源,并指出面试要点及Graph RAG、RAGAS评估等进阶方向。
大模型的知识在训练完成后就固定了,面对私有数据或最新信息往往无能为力。RAG(Retrieval-Augmented Generation,检索增强生成)正是为解决这一痛点而生,也是当前大模型岗位面试中高频出现的核心考点。B站UP主在最新教程中系统拆解了RAG的工作流程,本文基于该讲解,结合多源技术共识,为你梳理一份完整的RAG知识体系。
为什么需要RAG:知识冻结与微调的困境
据B站UP主的分析,大模型经过训练后,知识便“冻住了”——你可以问任何模型“你的知识截止日期是什么时候”,它基本都会给出一个过去的时间点。训练数据截止之后发生的事情,模型一无所知。虽然部分模型能通过联网工具获取实时信息,但对于企业内部文档、私有数据,依然无法直接回答。
微调看似是一条出路,但UP主指出其成本高、耗时长,更关键的是知识一旦写入模型参数,更新就得重新训练——好比“让你记住一条新闻必须重新上一遍大学”。RAG走了一条完全不同的路径:不把知识塞进参数,而是在用户提问时实时检索外部知识库,把相关内容放入提示词(Prompt)交给大模型读取。大模型本身具备很强的阅读能力,只要内容在上下文里,它就能基于此作答。
离线阶段:知识库的构建
RAG的完整工作流程可分为离线建库和在线检索生成两大阶段。据UP主展示的系统架构图,离线阶段包含四个关键步骤。
文档加载与切割
第一步是文档加载,将PDF、Word、Markdown、网页乃至数据库记录等各种格式的原始数据读取进来。第二步是文档切割,把文档切成一个个小片段(chunk)。为什么不直接把整篇文档存进去?UP主解释了两个原因:嵌入模型有输入长度限制;即便没有限制,把整篇文档压缩成一个向量也会让细节信息被“平均掉”,导致检索不准确。
切割策略是面试中的重要考点。按固定字符切割容易截断语义,UP主建议chunk大小控制在500到1000之间较为合理——太大信息太杂,检索时容易召回不相关内容;太小则语义不完整。同时切割时要设置重叠,避免完整语义被从中间切断。
向量化与入库
第三步是向量化,这是离线流程中最核心的环节。Embedding模型把文本转成高维数字向量(如1536维的浮点数列表),可以理解为“语义坐标系”——语义相似的文本在空间中位置越近。UP主强调,向量检索匹配的是语义而非关键字,这是其与传统搜索的本质区别。
向量化之所以能表示相关性,源于训练:Embedding模型在海量文本上通过对比学习调整权重,把意思相近的文本拉近、无关的推远。这种空间结构一旦形成,查询时就能通过计算向量距离找到相近内容,常用余弦相似度衡量。
第四步是入库,把向量和原始文本一起持久化到向量数据库(如Milvus、Chroma等),这类数据库专门优化了高维向量的存储与相似度搜索,支持在千万量级向量中快速找到最相近的结果。
Embedding 模型与对比学习
Embedding 模型通常基于 Transformer 架构(如 BERT、BGE、text-embedding-ada-002 等),其训练目标是让语义相似的文本在向量空间中彼此靠近。对比学习(Contrastive Learning)是实现这一目标的核心方法:模型接收正样本对(如释义相同的两个句子)和负样本对(无关句子),通过损失函数(如 InfoNCE)拉近正样本距离、推远负样本距离。训练数据规模越大、质量越高,向量空间的语义区分能力越强。实际选型时需关注模型的最大输入长度、维度、推理速度及多语言支持能力,并确保查询与文档使用同一模型编码,否则向量空间不一致会导致检索失效。
在线阶段:检索与生成
在线阶段为用户提问提供实时检索与响应,包含四个核心步骤。
查询改写与粗排
用户输入往往口语化、模糊,直接检索效果不佳。UP主建议先对问题做改写和规范化,转成更适合检索的形式,让向量化和匹配更准确。
随后进行向量检索:把问题向量化,在向量数据库中做相似度匹配,返回距离最近的top-k个chunk。这一步速度极快,百万级向量库也能快速返回。但UP主提醒,向量检索本质是比较向量距离,并没有深度理解查询与文档的语义关系,召回结果难免混入看似接近实则不相关的内容——这一步通常称为“粗排”。
精排与生成
精排(Rerank)正是为弥补粗排不足:Rerank模型把用户问题和每个候选chunk拼在一起,深度理解相关性后重新排序,过滤不相关内容。UP主还提到,实际生产环境中通常采用多路召回——向量检索之外还会做关键字匹配等,精排时对所有召回结果统一重排,确保返回的内容最相关。
最后是生成:把用户问题和精排后的chunk拼进Prompt,交给大模型生成答案。UP主强调,Prompt中应明确要求模型只根据提供的资料回答、资料没有就说不知道,这能有效抑制幻觉。他同时提醒,大模型输出逻辑上通顺但事实上错误的内容并不罕见,使用者需要具备判断答案正确与否的能力。
Rerank 模型与多路召回
Rerank 模型通常是交叉编码器(Cross-Encoder),它将查询和候选文档拼接后输入 Transformer,直接输出相关性分数。与向量检索使用的双编码器(Bi-Encoder)不同,交叉编码器能建模查询与文档之间的细粒度交互,因此精度更高,但计算开销大,无法预先建立索引,只适合对少量候选(如 top-50)做精排。多路召回则是指同时使用向量检索、关键词检索(如 BM25)、甚至知识图谱查询等多种方式获取候选集,再合并去重后统一精排。这种组合能互补不同召回方式的盲区,例如 BM25 擅长精确匹配术语,向量检索擅长语义泛化。
RAG的核心价值与面试要点
据UP主总结,RAG的价值主要体现在两点:一是知识可随时热更新,往知识库更新文档即可,无需重新训练模型,成本低;二是答案可溯源,每条回答都能追溯到具体chunk,即便出错也能定位是哪条知识出了问题。
在面试中,候选人需要完整描述RAG的设计流程与操作步骤。UP主建议在项目经验中最好能体现一个RAG项目。此外,RAG的知识面还在扩展:RAG与图数据库结合的Graph RAG能更好地维护知识间的关联性;系统搭建完成后还需要评估与优化,关注召回准确率、召回率、忠实度等指标,可借助RAGAS等工具进行评测。
需要明确的是,RAG系统不是建好就一劳永逸,实践中需要持续调整优化。把离线建库、在线检索生成的分工理解透彻,再掌握切割策略、多路召回、精排、幻觉抑制这些细节,才算真正建立起RAG的知识体系。
RAGAS 评估框架与核心指标
RAGAS(Retrieval-Augmented Generation Assessment)是一个专门用于评估 RAG 系统的开源框架,它主要关注三个维度:忠实度(Faithfulness,答案是否完全基于检索到的上下文)、答案相关性(Answer Relevance,答案是否切题)、上下文相关性(Context Relevance,检索内容是否与问题相关)。此外,召回率(Recall)衡量检索阶段是否找全了所有相关片段,精确率(Precision)衡量召回结果中有多少是真正相关的。这些指标通常借助大模型作为评判器(LLM-as-a-Judge)自动计算,无需人工标注,适合迭代优化时快速反馈。
Graph RAG 的基本原理
Graph RAG 将知识图谱与 RAG 结合,在离线阶段不仅对文本分块向量化,还利用大模型抽取实体与关系,构建图结构(节点表示实体,边表示关系)。在线检索时,除了向量相似度,还可以沿图上的关系进行多跳推理,从而回答需要跨文档关联的问题。例如,问“A 公司的 CEO 曾就读于哪所大学”,传统 RAG 可能因信息分散在不同文档而失败,Graph RAG 则能通过实体链接和关系路径找到答案。Graph RAG 的代价是构建和维护图谱的成本较高,且对实体抽取的准确性依赖较强。
相关推荐
用了一周Xreal Aura,我改变了对AR的看法
Xreal Aura上手体验:分体式设计、Android XR生态与Gemini集成如何让AR眼镜真正可用。从游戏、地图到办公场景,分析这款空间计算设备的实际表现与局限。
哪个AI模型废话最多?我做了个"废话基准"实测
有人自建 Neural Yap 基准,从话术短语、排版符号、格式结构和回答长度四个维度量化AI模型的"废话程度"。结果显示GPT系列最简洁,Claude Opus 5.5最爱长篇大论,但真正决定体感的不是模型本身,而是使用框架与系统指令的服从度。
Alexa藏在相框里:亚马逊用情感算法敲开用户家门
The Vergecast讨论亚马逊新款Alexa相框:以送礼刚需切入家庭,靠照片智能配对算法制造情感瞬间,相框成为Alexa进入用户家门的特洛伊木马。