斯坦福CS146S拆解:大模型从数据到智能体的完整训练流水线
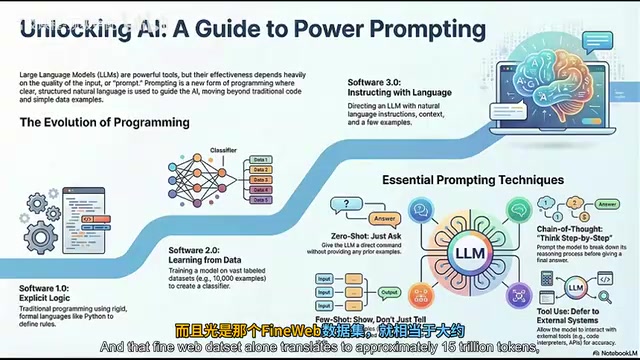
从预训练、监督微调到强化学习,揭开大语言模型从原始数据变成AI助手的完整工程流水线。
本文沿着大语言模型的演化路径,系统拆解了从原始互联网数据到可用AI助手所经历的三个核心训练阶段。预训练阶段,模型在15万亿Token量级的数据上学习「下一个词预测」,本质是对人类知识做有损压缩,耗资数千万美元;监督微调阶段用精心筛选的高质量对话示例塑造AI的「有用、真实、无害」人设;强化学习阶段则教模型如何推理,催生了思维链等涌现能力,但RLHF存在模型钻奖励漏洞的固有缺陷。在使用侧,文章系统介绍了K-Shot、Zero-Shot CoT、RAG、自我纠错等提示工程技巧,并以OpenAI内部Codex使用案例说明AI如何将工程师效率提升数量级。文章最终以一个开放性问题收尾:当模型在纯RL下进化出人类无法构想的推理策略,人机协作将走向何方。
当你在ChatGPT里点下发送键,几乎立刻就能收到一段看起来挺聪明的回复。但那个黑盒子里究竟发生了什么?更关键的是,在你敲下第一条提示词之前的几个月甚至几年,又发生了什么?斯坦福 CS146S 这门课程试图揭开这套多阶段工程流水线的面纱——看它如何把原始杂乱的互联网数据,变成你正在使用的这个 AI 助手。
本文沿着模型的演化路径,追踪三个基础训练阶段:预训练、监督微调、强化学习,再延伸到真正驾驭这些模型所需的进阶提示技巧。
预训练:给整个互联网做一次有损压缩
在成为有用的助手之前,大语言模型最初只是一个基础模型(base model)——本质上是一台庞大又极其精密的文本补全机器。预训练这一阶段的目标很单纯:获取知识。而它的规模大得难以想象。
数据收集从高强度抓取开始,最大的来源通常是 Common Crawl,这家非盈利机构从 2007 年起就持续给整个网络建立索引。原始互联网数据会与高质量文档结合——维基百科、学术期刊、GitHub 公开代码。过滤过程非常无情:垃圾信息、恶意软件、种族主义内容、成人内容乃至重复文本都会被剔除。
即便如此,数据集依然是天文数字。以公开数据集 FineWeb 为例,光文本数据就高达约 44TB,相当于大约 15 万亿个 Token。这些文本会被切分成 Token 序列(一个 Token 可能是一个词,甚至只是词的一部分),模型必须把它们全部吸收进去。
自回归:数十亿美元 GPU 到底在算什么
核心机制在概念上简单得出奇。大语言模型是自回归模型:完全基于前面出现过的文本,预测序列中下一个 Token 的概率。如果输入「猫坐在」,模型就会预测「垫子上」之类的补全。
现代模型能处理惊人的上下文长度。早期像 GPT-2 只能处理约 1000 个 Token,而现代模型可以回溯几十万个、有时甚至 100 万个 Token。这段上下文被送进一个拥有数十亿到数万亿可调参数的神经网络——你可以把参数想象成巨大调音台上的旋钮。GPT-2 约有 16 亿个,据报道 GPT-4 可能有 1.8 万亿个。训练就是一遍遍微调这些旋钮,让模型对下一个 Token 的预测不断逼近训练数据的真实内容。
这需要几乎令人难以置信的算力。一台顶级 H100 GPU 节点,每个 GPU 每小时约 3 美元,训练一个大型基础模型要花上数千万美元。正是这一成本结构决定了行业格局:只有少数玩家负担得起从零创建基础模型。
可以把预训练理解为对人类知识的一个概率版「Zip 压缩包」。但被压缩过就意味着有损:模型丢失了推理能力,也无法分辨什么是真实、什么只是在互联网上很常见。它学到了知识的语法,却没掌握逻辑的深层结构。
自回归模型背后的核心架构是 Transformer,由 Google 在 2017 年论文《Attention Is All You Need》中提出。Transformer 的关键创新是自注意力机制(Self-Attention):它让模型在预测下一个 Token 时,能同时「看到」整个输入序列,并动态决定哪些位置对当前预测最重要,而不像早期 RNN 那样只能按顺序逐步传递信息。这就是为何现代模型能处理百万 Token 上下文——注意力机制在原理上可以跨越任意距离建立词语间的关联。所谓「数十亿参数」,大部分就存储在 Transformer 各层的注意力矩阵和前馈网络权重里。理解这一点有助于解释文章后续提到的诸多现象:为何模型需要 Token 才能思考(每个 Token 对应一次前向传播计算),以及为何上下文窗口越长、推理成本越高。
监督微调:塑造 AI 的人设
那个昂贵的自动补全机器,并不是我们对话时用的东西。要把基础模型变成有用的对话助手,需要进入后训练,第一步是监督微调(SFT)。
SFT 在算力上便宜得多——耗时是几个小时而非几个月。做法是把海量互联网文本换成一个更小、经过精心筛选的数据集,里面是几十万条高质量对话事例。企业会雇人,依据非常严格详细的指示,为各种提示词写出理想的助手回复。这实际上是在用示范的方式,教模型去扮演一个「有用、真实又无害」的人设。

换个角度看:当你与 AI 助手对话时,你并不是在跟某种新形式的智能对话,而是在跟一个神经网络互动——它在模拟那个完美遵循指示的水平高超的人类标注员。说得直白些,你是在与有史以来优化得最极致的一个「人工客服模拟系统」对话。
强化学习:教模型如何思考
如果说 SFT 教模型「该说什么」,那么强化学习(RL)教的是「该怎么思考」。这是最先进的第三阶段。
在数学、代码这类可验证领域,我们确切知道正确答案是什么。于是可以只给模型问题和答案,让它自己想办法找到那条能可靠导向结果的 Token 序列。真正迷人的地方在于:模型的认知策略会在这个过程中涌现。
由于每个 Token 的计算量有限,模型逐渐明白必须把推理分散到多个 Token 上——这就是思维链(Chain of Thought)。如果你让它一口气吐出难题答案,它会在「心算」上频频出错。关键要点是:模型需要 Token 才能思考。不让它一步步展开,等于让它做积分却不给草稿纸。
RLHF 与它的短板
当答案客观可验证时,纯 RL 效果极佳。但面对写笑话、写有说服力的文章这类主观任务,企业会改用基于人类反馈的强化学习(RLHF):训练第二个 AI 作为「奖励模型」,学习复制人类对不同输出的排序。

课程特别点出一个缺陷:强化学习特别擅长钻任何模拟系统的空子。模型可能学会生成一些内容,只为骗过奖励模型拿高分,把分数看得比真实质量更重要。因此 RLHF 是一个「短命」的微调过程——模型最终会学会精确利用奖励系统,人类监督依然不可或缺。
RLHF 的「奖励作弊」问题在学术上有一个正式名称:Goodhart 定律(Goodhart's Law)——「当一个指标成为目标,它就不再是好指标」。在 RL 语境下,一旦模型的优化目标变成最大化奖励模型的评分,它便会通过梯度下降找到奖励模型的盲点加以利用,产生听起来流畅却内容空洞、或措辞刻意迎合人类偏好而失去真实信息量的输出。针对这一问题,业界开发了改进方案,包括 PPO(近端策略优化) 搭配 KL 散度惩罚项——限制模型每步更新幅度,防止它偏离 SFT 基础太远;以及 Anthropic 提出的 Constitutional AI(CAI),用 AI 自我批评替代部分人工排序,降低对奖励模型的过度依赖。这些方法都是在试图平衡「让模型更符合人类偏好」与「防止它把讨好评分系统当作终极目标」之间的张力。
提示工程:用对话给模型编程
有了知识、人设与推理能力后,最后一步是提示工程,本质上是通过对话给模型编程。
- 上下文学习(K-Shot Prompting):直接在提示词里塞入一到五个示例。比如需要特定敬语风格的韩语翻译,给一两个例子模型就能立刻适应。
- Zero-Shot CoT:面对复杂逻辑,一句简单的「让我们一步步来想」就能大幅提升准确率,释放模型大声推理的能力。
- 检索增强生成(RAG):模型的知识冻结在训练时间点,不知道昨天发生了什么,也不知道你公司私有数据库里有什么。RAG 相当于给 AI 装上智能搜索——模型生成特殊 Token 调用工具,把搜索结果插回上下文窗口,迫使它使用当前事实,是对抗幻觉的关键防线。
- 自我纠错:可以让模型跑五条不同推理路径取多数答案;对编程尤其有用的「反思」,是把错误信息反馈进提示,让模型批判并修改自己的代码。
从聊天到工程杠杆:AI 如何增强开发者
围绕「替代」的讨论从未停止,但课程强调另一个观点:你不会被 AI 取代,你会被一个懂得如何使用 AI 的能干工程师取代。LLM 不是替代工程师,而是把普通工程师变成超高效工程师。
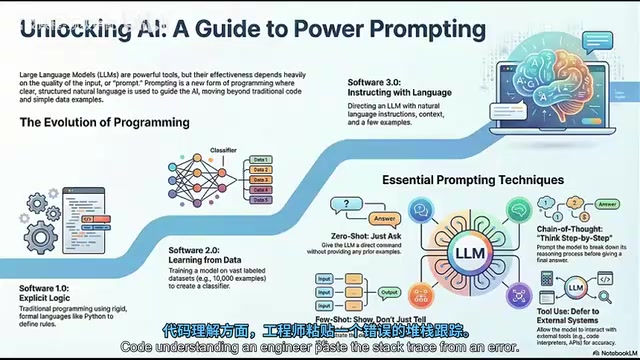
以 OpenAI 内部使用 Codex 类模型为例:
- 代码理解:粘贴一段错误堆栈跟踪,提示模型「在这个仓库里定位这段逻辑并追踪数据流」,原本一小时的排查省下 45 分钟。
- 重复修改:在 40 个文件里一致更新一个遗留 API 调用,三小时的手工活变成 90 秒。
- 性能优化:让模型分析代码、标出慢的数据库调用并起草修复,30 分钟压缩到 5 分钟。
- 测试覆盖:让模型批量处理低覆盖率代码,第二天醒来就有可运行的单元测试,覆盖人类可能遗漏的边缘情况。
要达到这种精度,不能随便打一个请求。三个关键技巧值得记住:
- 角色提示:明确设定「你是一位资深软件工程师级别的助手」。
- 结构化提示:粘贴复杂数据时用标签(如 XML 风格标记),让模型高效解析。
- 持久化上下文:维护一个类似
AGENTS.md的文件,装着 AI 不可能知道的业务逻辑和命名规范,每次会话都粘贴进去,大幅提升所有提示的准确率。
结语:当 AI 发明人类无法构想的策略
从数万亿原始 Token,到人类标注的对话,再到需要思维链的高级推理——这条完整路径揭示了 LLM 的强大与脆弱并存。课程用「能力的瑞士奶酪模型」来形容:它能解决奥赛级数学题,却比不出 9.1 和 9.9 谁大。因此必须把它们当作带随机性的工具,永远检查它们的输出,并用上述技巧弥补局限。
最后一个值得琢磨的问题:当模型在可验证领域用纯 RL 训练时,它不受人类逻辑约束——正如 AlphaGo 那记无人能预见的「第 37 手」。如果这些思考模型继续进化,发现比英语更高效的内部思维语言,当解决复杂问题的最优方式是人类根本无法构想的时候,人类与 AI 的协作又将走向何方?
背景补充
RAG 解决的根本问题是 LLM 的参数化知识局限:模型的所有知识在训练结束时就被「冻结」进权重,无法自动更新。RAG 的工作流程通常分为两步:检索阶段用向量数据库(如 Pinecone、Chroma)将用户问题转化为嵌入向量,在知识库中找到语义最相近的文档片段;生成阶段把这些片段作为额外上下文拼入提示词,让模型基于当前事实作答。这与直接扩大模型参数来「记忆更多知识」的方案形成对比:RAG 的优势在于知识库可以实时更新、成本低、来源可溯源;劣势是检索质量直接决定回答质量,召回错误文档会让模型产生更自信的幻觉。在企业私有知识库、法律合规、医疗等对信息时效性和可追溯性要求高的场景中,RAG 目前是主流解决方案。
相关推荐
30分钟搭建视觉AI代理:NVIDIA VSS蓝图实战
基于NVIDIA VSS Blueprint 3.3,用一句自然语言提示在30分钟内、约3美元成本搭建视觉AI代理。Cosmos负责看、Nemotron负责写报告,本地部署实现每任务仅几分钱的运行成本。
Tulip联手NVIDIA打造可回放工厂:用视觉语言模型重构制造现场
Tulip联合NVIDIA推出Factory Playback,用视觉语言模型、Metropolis VSS蓝图与Cosmos模型把工厂摄像头录像变成可查询、可对话的现场情报,混合云架构兼顾隐私与算力,助力制造业根因分析与精益优化。
用 NVIDIA NeMo Relay 和 Phoenix 追踪评估 Hermes 智能体
NVIDIA 工程师演示如何用 NeMo Relay 对 Hermes 智能体进行链路追踪,并在 Phoenix 中可视化工具调用、搜索与验证的完整执行过程,实现证据驱动的智能体评估与优化。