Spatial-TRM:递归推理如何提升空间上下文预测精度44%

Spatial-TRM用1120万可训练参数和递归细化,在空间上下文预测上相对提升44%。
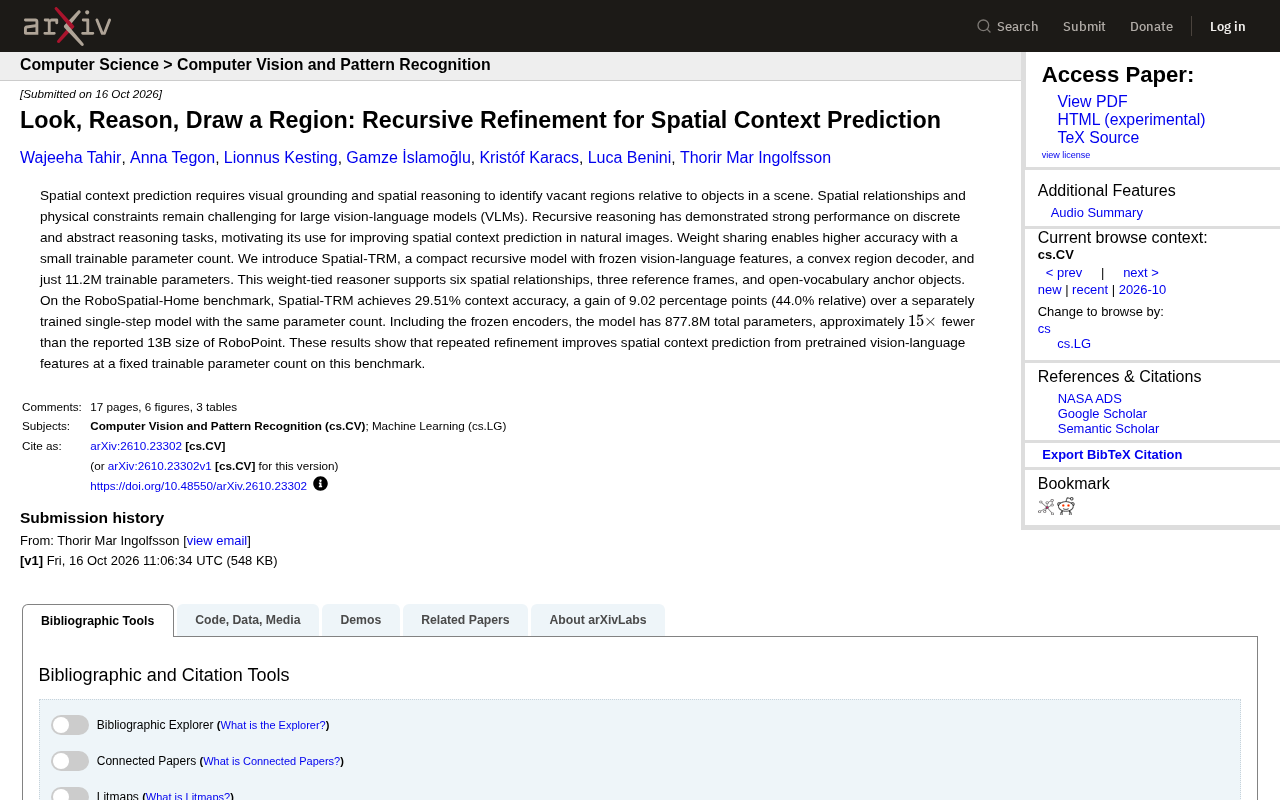
Spatial-TRM 是一篇针对空间上下文预测任务提出的紧凑递归模型。该任务要求模型同时完成视觉 grounding 和空间推理,现有大型视觉语言模型在物理约束和参考系切换上表现不佳。Spatial-TRM 由冻结的 VLM 特征提取器、凸区域解码器和权重共享的递归推理模块组成,仅 1120 万可训练参数,总参数 8.778 亿,约为 RoboPoint 的 1/15。在 RoboSpatial-Home 基准上,它取得 29.51% 的上下文准确率,相比同等参数量的单步模型绝对提升 9.02 个百分点、相对提升 44%,且对比实验严格控制了参数量变量,证明增益来自递归细化本身。文章认为这为参数受限场景提供了一条不同于堆规模的结构设计路径。
Spatial-TRM:递归推理如何提升空间上下文预测精度44%
当机器人需要在一个杂乱的家庭环境中找到“可以放下杯子的空位”,它必须理解物体之间的空间关系、物理约束,甚至参考系的选择。这类任务被称为空间上下文预测,一直是大型视觉语言模型(VLM)的短板。一篇新论文提出的 Spatial-TRM 模型,用仅 1120 万可训练参数,在 RoboSpatial-Home 基准上把上下文准确率拉到 29.51%,比同等参数量的单步模型相对提升 44%。
空间上下文预测难在哪里
空间上下文预测要求模型同时完成两件事:视觉 grounding(定位场景中的物体)和空间推理(推断物体之间的相对位置、方向、容纳关系)。人类可以轻松判断“桌子旁边的地板是空的”,但 VLM 往往在物理约束和参考系切换上出错。
论文指出,空间关系与物理约束对大型视觉语言模型仍然构成挑战。现有的方法要么依赖大规模端到端训练,要么针对特定场景设计专用模块,泛化能力和参数效率都受限。
递归推理在离散和抽象推理任务上已经展现出强劲性能——通过反复迭代细化答案,模型可以在不增加参数量的情况下提升推理深度。这为空间上下文预测提供了一个新思路:能否用递归细化来弥补 VLM 在空间推理上的不足?
视觉 grounding(视觉接地) 指模型将自然语言中的指代表达(如“桌子旁边的地板”)与图像中具体的像素区域对应起来的过程。它是视觉语言模型完成指代理解、目标检测和空间推理的基础能力。在空间上下文预测中,grounding 的精度直接决定后续空间关系判断的上限:如果模型无法准确定位“桌子”和“地板”的边界,那么“旁边”“空位”等关系推断就无从谈起。与通用目标检测不同,空间上下文任务中的锚点物体常常是开放词汇的,要求模型具备零样本或开放词汇的定位能力,这也是现有 VLM 容易出错的关键环节。
Spatial-TRM 的架构设计
Spatial-TRM 的核心是一个紧凑的递归模型,包含三个关键组件:冻结的视觉语言特征提取器、凸区域解码器,以及一个权重共享的递归推理模块。整个模型只有 1120 万可训练参数,加上冻结的编码器后总参数量为 8.778 亿,约为 RoboPoint 报告的 130 亿参数的 1/15。
权重共享是参数效率的关键。同一个推理模块被反复调用,每次迭代都基于上一次的输出进行细化,支持六种空间关系、三种参考系和开放词汇的锚点物体。这种设计让模型在保持小参数量的同时,获得了更深的推理能力。
凸区域解码器负责将推理结果转化为具体的区域预测。与直接回归边界框不同,凸区域表示更贴合“哪里可以放置物体”这类空间上下文任务的实际需求。
凸区域解码器 中的“凸区域”指由一组点构成的凸多边形区域——区域内任意两点的连线仍完全落在区域内。相比矩形边界框,凸区域能更灵活地贴合不规则的可放置空间(如 L 形桌面上的空位),也更自然地表达“物体可以放置的大致范围”。解码器的作用是将递归推理模块输出的抽象空间表示转换为具体的凸区域顶点或参数,从而给出区域级的预测而非单一坐标点。这种表示方式与“哪里可以放置物体”的任务定义高度匹配,因为答案本质上是面积的、连续的空间区域。
递归细化带来的精度跃升
在 RoboSpatial-Home 基准上,Spatial-TRM 取得了 29.51% 的上下文准确率。作为对比,同等参数量的单独训练单步模型准确率更低,Spatial-TRM 的绝对提升为 9.02 个百分点,相对提升达到 44.0%。
这个对比实验的设计很关键:两个模型的参数量完全相同,唯一区别是是否使用递归细化。这意味着性能提升可以直接归因于递归推理机制,而不是模型容量或训练数据的变化。论文作者将此视为递归细化在空间上下文预测任务上有效的直接证据。
从绝对数值看,29.51% 的准确率并不算高,说明空间上下文预测仍然是一个困难的任务。但 44% 的相对提升表明,递归细化是一个值得深入探索的方向,尤其是在参数量受限的部署场景中。
上下文准确率(contextual accuracy) 是 RoboSpatial-Home 基准中衡量空间上下文预测质量的指标,通常要求模型预测的区域与标注的真实可放置区域在空间上足够吻合(如 IoU 超过阈值)才计为正确。它区别于简单的点定位准确率,更强调对区域范围的整体判断。由于空间上下文任务涉及多种关系类型和参考系组合,该指标对模型的 grounding 精度和推理一致性同时提出要求,因此即使是先进模型在该指标上的绝对值也普遍偏低,29.51% 在这一背景下具有参考意义。
小参数模型的空间推理启示
Spatial-TRM 的结果传递出几个值得关注的信号。
参数效率可以靠结构设计而非堆规模。 8.778 亿总参数、1120 万可训练参数,与 130 亿参数的 RoboPoint 形成鲜明对比。在机器人、边缘设备等对算力敏感的场景中,这种紧凑设计有实际价值。
递归推理是一种可迁移的归纳偏置。 论文的核心假设是:反复细化比单次预测更接近正确的空间答案。这一思路在离散推理任务中已被验证,Spatial-TRM 将其延伸到连续空间区域预测,说明递归结构在不同任务间具有一定的通用性。
冻结特征 + 轻量推理模块是一种务实的组合。 利用预训练 VLM 的视觉语言特征,只训练一个小型推理头,既保留了预训练模型的泛化能力,又避免了大规模微调的成本。这对于快速适配新场景、新物体类别尤为友好。
当然,29.51% 的绝对准确率也提醒我们,空间推理距离实用仍有距离。递归细化能带来显著增益,但如何进一步提升视觉 grounding 的精度、如何处理更复杂的物理约束,仍是开放问题。论文的贡献在于提供了一个清晰的实验框架:在固定可训练参数量的条件下,验证递归结构本身的价值。
对于关注 AI 空间智能、机器人感知的研究者和工程师来说,Spatial-TRM 展示了一条不同于“更大模型”的路径——用递归结构挖掘预训练特征的潜力,在参数预算紧张时尤其值得参考。
冻结特征 + 轻量推理头 是一种常见的参数高效迁移策略:保留预训练视觉语言模型的编码器权重不变,仅在其特征之上训练一个小型任务头。这样做的好处是避免灾难性遗忘、大幅降低训练成本,并能直接复用预训练模型已习得的开放词汇视觉语义。其局限在于任务头能利用的信息受限于冻结特征的质量——如果预训练特征本身对细粒度空间关系不敏感,推理头的提升空间就会受限。Spatial-TRM 的递归结构正是在这一约束下,通过增加推理深度而非特征容量来挖掘冻结特征的潜力。
相关推荐

大厂AI工程化面试:前端监控到Agent全链路可观测性
从PerformanceObserver采集性能指标、onerror与unhandledrejection捕获异常,到RAG链路重排优化、上下文压缩控制token成本,再到对标LangSmith与Sentry的全站AI全链路可观测性体系设计,拆解大厂AI工程化面试的三层递进考点。

WorkBuddy保姆级教程:手把手搭建专属AI Agent工作助理
WorkBuddy保姆级教程:从豆包等聊天模型的局限讲起,手把手教你搭建专属AI Agent工作助理,实现本地文件批量处理与自动化操作,非程序员也能轻松上手。

Windows下用LangChain-Chatchat+DeepSeek搭建本地知识库
本文整理B站教程,详解Windows下用LangChain-Chatchat与DeepSeek搭建本地知识库的全流程,包括Anaconda环境配置、Ollama模型管理、镜像源加速及常见报错解决,助你快速实现RAG问答。