学习式上下文规划难敌强检索:长文本QA对照研究解读

研究发现学习式上下文规划在长文本问答中未能超越BM25等经典检索基线。
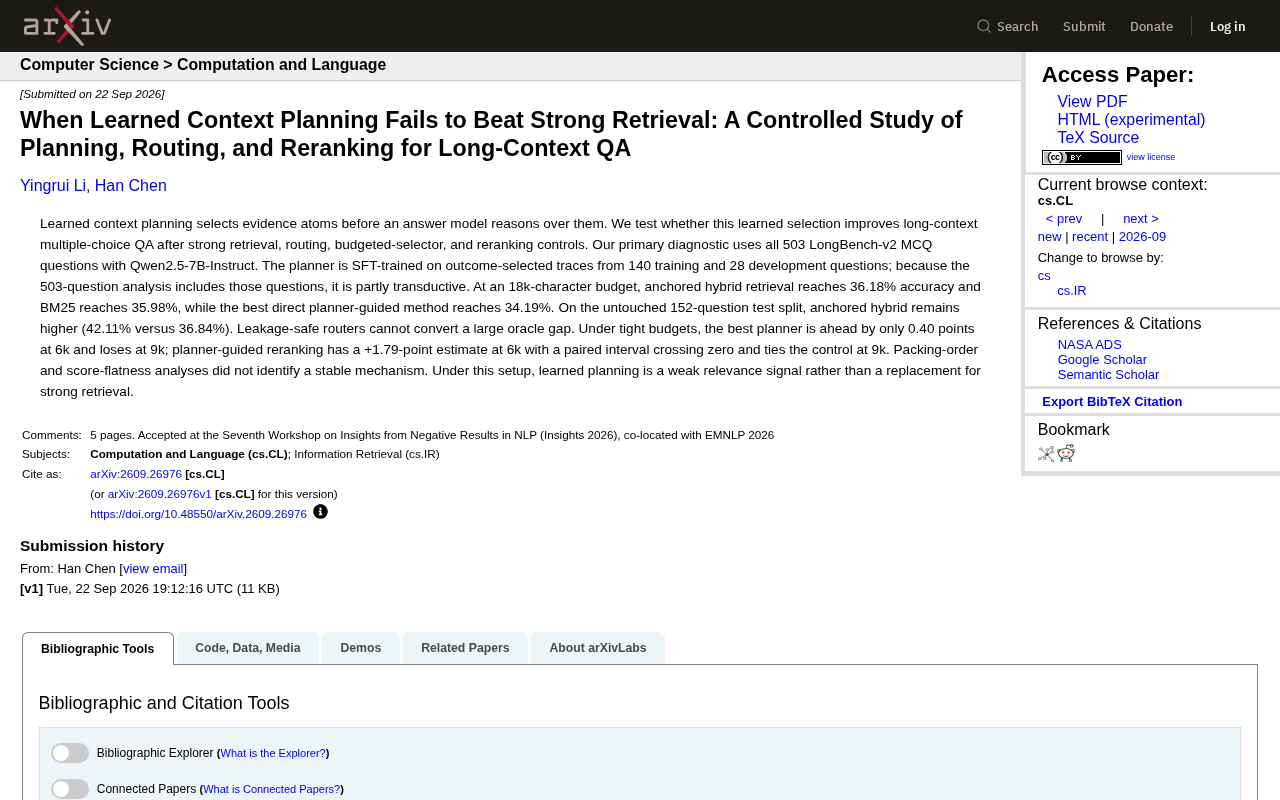
一项针对长文本多选问答的对照实验表明,近年流行的"学习式上下文规划"方法——即用专门训练的规划器在推理前筛选证据片段——在强检索基线面前并无稳定优势。研究以 LongBench-v2 的 503 道题为测试集,以 Qwen2.5-7B-Instruct 为答案模型,发现锚定混合检索和 BM25 分别达到 36.18% 和 35.98% 准确率,而最佳规划器引导方法仅为 34.19%。在完全未见过的 152 题测试子集上,差距进一步扩大至约 5 个百分点。路由和重排序机制均未能将理论上的 oracle gap 转化为实际提升,统计显著性也普遍缺失。论文的核心结论是:学习式规划是弱相关性信号,而非扎实检索管线的替代方案。对 RAG 工程团队的直接启示是:优先打磨检索与重排序,谨慎评估额外训练组件的真实增益。
在长文本问答(Long-Context QA)领域,如何为答案模型挑选最相关的证据一直是核心挑战。一篇新的 arXiv 研究(arXiv:2609.26976)对当下备受关注的"学习式上下文规划"(Learned Context Planning)方法提出了冷静的质疑:在强检索基线的对照下,这套依赖训练的证据选择机制,究竟能不能带来实质性提升?答案可能出乎不少人的预期。
学习式上下文规划到底解决什么问题
所谓学习式上下文规划,核心思路是在答案模型进行推理之前,先由一个"规划器"(planner)从海量文本中挑选出最关键的证据片段(evidence atoms)。这套逻辑很符合直觉——与其把整段长文本一股脑塞给模型,不如先做精细化的筛选,让模型只看最有价值的内容。
这类方法之所以受到关注,是因为长文本场景下上下文窗口和推理成本都是硬约束。如果能通过一个专门训练的选择器提前过滤噪声,理论上既能节省预算,又能提升准确率。但研究者提出的问题很尖锐:当你已经有了足够强的检索、路由(routing)、预算选择器(budgeted-selector)和重排序(reranking)机制时,这套额外学习出来的规划还能带来多少增量?
BM25 是一种基于词频统计的经典检索算法,全称 Best Matching 25,属于 TF-IDF 家族的概率扩展。它根据查询词在文档中的出现频率、文档长度等因素为每个候选片段打分,无需任何训练数据即可运行,是信息检索领域几十年来最稳健的基线之一。"锚定混合检索"(anchored hybrid retrieval)则是将 BM25 等稀疏检索与基于语义嵌入的密集检索结合,通过融合两类分数来取长补短。这两种方法都不需要针对具体任务进行微调,因此在本研究中作为"无训练"的对照基线,与需要监督微调的规划器形成直接对比。理解这一背景有助于把握论文的核心论点:一个经过专门训练的规划器,连不需要训练的经典检索都未能稳定超越。
实验设计与关键数据
研究以 LongBench-v2 数据集的全部 503 道多选题(MCQ)为主要诊断集,答案模型采用 Qwen2.5-7B-Instruct。规划器通过监督微调(SFT)在 140 道训练题和 28 道开发题的"结果选择轨迹"上训练。作者坦诚指出一个方法论上的问题:503 题的分析集本身包含了训练题,因此结果"部分是直推式(transductive)"的——这实际上给了规划器一定的优势。
即便存在这种潜在偏向,结果依然不利于规划器。在 18k 字符预算下:
- 锚定混合检索(anchored hybrid retrieval) 达到 36.18% 准确率
- BM25 达到 35.98%
- 最佳的直接规划器引导方法 仅为 34.19%
换句话说,即便规划器"见过"部分测试数据,它仍然跑不过朴素的 BM25 检索。而在完全未被触碰的 152 题测试子集上,差距进一步拉大:锚定混合检索为 42.11%,规划引导方法仅 36.84%。
路由与重排序也救不了场
研究进一步测试了能否通过"防泄漏路由器"(leakage-safe routers)把规划器的潜在优势转化为实际收益。所谓 oracle gap,指的是理论上最优选择与实际选择之间存在的巨大空间。结论是:即便存在很大的 oracle gap,防泄漏路由也无法将其转化为实际准确率提升。
在更紧的预算约束下,结果同样摇摆不定。6k 预算时,最佳规划器仅领先 0.40 个百分点;到了 9k 预算,规划器反而落后。规划器引导的重排序在 6k 时有 +1.79 点的估计值,但配对置信区间跨越了零点(意味着统计上不显著),而在 9k 时与对照组打平。
作者还做了打包顺序(packing-order)和分数平坦度(score-flatness)分析,试图找出规划器起作用的稳定机制,结果都没有识别出可靠的作用路径。
Oracle gap 在信息检索和问答系统评估中是一个重要概念,指的是"理论最优选择"与"实际系统选择"之间的性能差距。具体而言,oracle 选择意味着事先知道答案,从候选片段中挑出真正包含正确答案的那些——这在实际部署中不可能实现,但可以用来衡量上限。Oracle gap 越大,说明当前系统的选择质量距离理论上限越远,理论上存在更大的改进空间。本研究中作者发现,尽管规划器引导方法与 oracle 之间存在相当大的 gap(意味着规划器的选择质量确有提升潜力),但无论是路由策略还是重排序机制都无法将这一潜力兑换为实际准确率的提升,说明瓶颈并不在于"知道选哪里",而在于其他更深层的因素。
结论:规划是弱相关信号,而非检索的替代品
这项研究的核心判断相当克制但有力:在这套实验设置下,学习式上下文规划只是一个微弱的相关性信号,而不是强检索的替代方案。
这个结论对当前的研究风向有现实意义。近年来不少工作倾向于用更复杂的、需要训练的选择机制去替代传统检索管线,但这篇论文提醒我们:在做出复杂化决策之前,必须建立足够强的检索、重排序基线作为对照。很多时候,看似先进的"学习式"方案在扎实的经典方法面前并没有稳定优势,甚至反而更差。
说一下,该研究也有其局限:规模仅限于单一模型(Qwen2.5-7B-Instruct)和单一数据集(LongBench-v2),且训练数据量较小(仅 168 题)。这些因素意味着结论不宜过度外推。但作为一项设计严谨、对照充分的"消极结果"研究,它的价值恰恰在于用可复现的方式挑战了一种流行假设。
对从事 RAG(检索增强生成)和长文本处理的工程团队来说,这项工作的启示很直接:优先把检索与重排序做扎实,谨慎评估任何额外训练的选择器是否真的带来了超越基线的增益,而不是被"规划"这类看似高级的概念所吸引。
RAG(Retrieval-Augmented Generation,检索增强生成)是当前大语言模型应用中最主流的架构之一,其基本思路是:在模型生成回答之前,先从外部知识库中检索相关文档片段,再将这些片段连同原始问题一起输入模型。这样做的好处是让模型能够访问训练数据之外的最新信息,同时降低"幻觉"风险。学习式上下文规划可以看作 RAG 管线中检索与生成之间的一个额外环节——用训练过的规划器进一步精选检索结果。本研究的负面发现对 RAG 工程实践具有直接指导意义:在资源有限的情况下,把精力投入在优化检索和重排序质量上,通常比引入额外的学习式选择组件更为稳健。
相关推荐
AWS MCP Server新增6大区域:AI编程智能体的基础设施提速
AWS将托管MCP服务器扩展至新加坡、悉尼、东京、爱尔兰、伦敦和俄勒冈六个新区域,为AI编程智能体提供统一接口发现、调用和运维AWS服务,降低延迟并满足数据驻留需求。
Qwen模型凭空生成阿里云签名URL:幻觉还是数据外泄隐患?
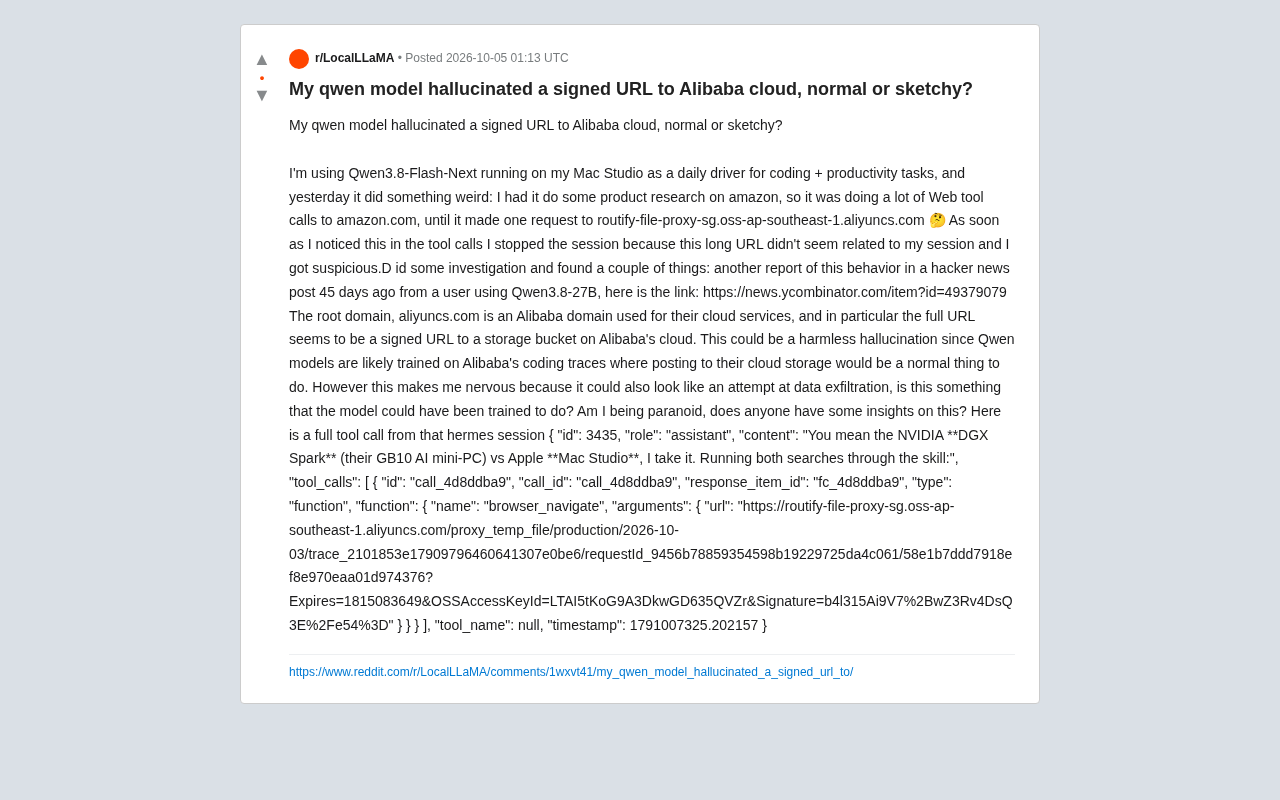
Reddit用户报告Qwen模型在工具调用中凭空生成指向阿里云OSS的签名URL,引发数据外泄担忧。本文结合多份独立报告,分析这究竟是训练数据导致的模型幻觉还是安全风险,并给出Agent工具调用的安全防护建议。
多模态AI转录开罗genizah:右向左语言的VLM微调实践
一篇技术文章探讨如何通过微调多模态视觉语言模型(VLM)自动转录开罗genizah中世纪手稿,解决希伯来语等右向左语言的OCR难题,为数字人文研究提供新工具。