用AI控制器打游戏:现实边界与可行路径

AI通过物理控制器玩游戏需攻克感知、决策、执行三层难题,RL样本效率低,建议从模拟器起步。
本文针对Reddit网友提出的“AI通过物理控制器玩游戏”设想,从技术栈、强化学习瓶颈、伦理红线等方面进行分析。物理控制器方案需完成感知-决策-执行闭环,但视觉感知延迟高、RL样本效率极低、机械执行工程复杂,导致训练周期可能从几天拉长到几个月。多人游戏使用AI违反公平原则,应限制在单机场景。作者建议分阶段推进:先在模拟器中用简单游戏验证RL流程,再引入物理控制器完成固定任务,最后挑战慢节奏单机游戏。提问者的机器人经验是硬件控制优势,但需对训练周期有合理预期,理解局限正是入门的最好方式。
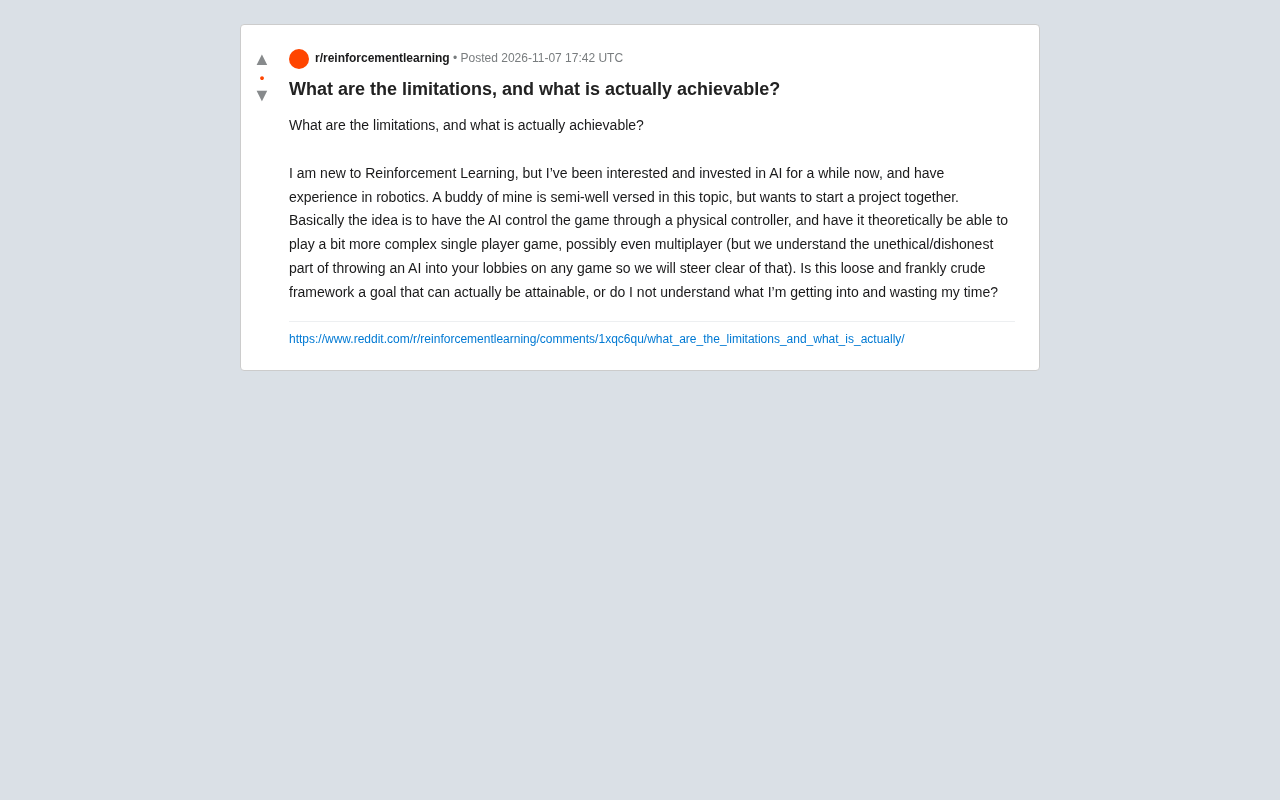
Reddit上一位有机器人经验、刚接触强化学习的开发者提问:能否让AI通过物理控制器操作游戏,甚至挑战更复杂的单机或多人游戏?他明确排除了多人对战中的作弊行为。这个设想听起来像极客版的“终结者打游戏”,但实际可行吗?
物理控制器+AI:技术栈拆解
用物理控制器玩游戏,意味着AI需要完成“感知-决策-执行”的闭环,但每一环都比纯软件方案更棘手。
感知层:AI无法直接读取游戏内存,只能依赖摄像头画面。这要求实时目标检测、场景分割甚至OCR识别游戏内文字。与直接读内存的脚本相比,视觉方案延迟高、噪声大,且对光照变化敏感。
决策层:强化学习需要大量试错。在物理控制器场景下,每次动作都涉及机械延迟,训练样本的采集成本远高于模拟器。如果游戏本身节奏快,训练周期会被拉长到不切实际的程度。
执行层:物理控制器意味着机械臂或舵机驱动按钮/摇杆。即使使用高精度舵机,按压行程、回弹速度、多键组合的协调都是工程难题。更麻烦的是,不同游戏手柄的力学特性差异很大,迁移能力几乎为零。
强化学习的现实瓶颈
这位提问者提到自己“刚接触RL”,而RL在真实物理系统上的应用门槛远高于仿真环境。
样本效率:主流RL算法(如PPO、DQN)在Atari游戏上需要数百万帧才能达到人类水平。换成物理控制器,每帧的采集时间从毫秒级变成秒级,训练时间可能从几天变成几个月。
奖励设计:游戏分数是稀疏奖励,AI很难从零开始摸索。通常需要设计中间奖励(如血量、距离),但这又依赖对游戏机制的深入理解,且容易引入人为偏差。
泛化能力:在《超级马里奥》上训练的模型,换到《魂斗罗》几乎必然失效。游戏画面、操作逻辑、敌人行为模式的差异,会让模型需要从头训练。
多人游戏的伦理红线
提问者主动提到“理解在多人游戏里扔AI是不道德/不诚实的”,这个判断是正确的。
多人游戏的核心是公平竞技,AI介入会破坏其他玩家的体验,也违反绝大多数游戏的服务条款。即使技术上可行,法律和社区规则也不允许。更务实的做法是把AI限制在单机游戏、本地对战或私人服务器中。
务实的目标设定:从简单游戏开始
如果坚持要做,建议把目标拆解为可验证的里程碑。
第一阶段:用模拟器+键盘输入,让AI学会玩一款简单游戏(如《贪吃蛇》或《Flappy Bird》)。这一步验证RL流程是否跑通,不涉及物理控制器。
第二阶段:引入物理控制器,但只做“固定场景”任务,比如让机械臂按顺序按下几个按钮,完成一个预设操作序列。这一步验证硬件控制的可靠性。
第三阶段:结合视觉感知和物理执行,挑战一款节奏较慢、操作简单的单机游戏(如回合制或平台跳跃类)。此时训练时间可能以周为单位,需要有心理准备。
第四阶段:如果前三阶段顺利,再考虑更复杂的游戏。但要注意,复杂度提升不是线性的——从《超级马里奥》到《拳皇》,难度是指数级增长。
结论:不是浪费时间,但需要合理预期
这个项目在技术上有可行性,但“AI通过物理控制器玩复杂游戏”是一个长期目标,短期内更现实的是完成一个展示性的demo。提问者具备机器人经验,这是优势——硬件控制部分会比纯软件背景的人少走弯路。
建议先花两周时间用模拟器跑通RL流程,再决定是否投入硬件。如果目标只是“让AI玩起来”,模拟器方案成本更低、迭代更快;如果目标是“展示物理交互”,那就从最简单的按键任务开始。无论哪种,这个项目都能让你深入理解RL的局限——而理解局限,恰恰是入门的最好方式。
背景补充
目标检测与场景分割是计算机视觉中的核心任务。目标检测(如YOLO、Faster R-CNN)负责在图像中定位并识别物体,输出边界框和类别;场景分割(如Mask R-CNN、U-Net)则对每个像素进行分类,实现更精细的语义理解。在游戏场景中,AI需要通过这些技术识别角色、敌人、道具和地形。OCR(光学字符识别)用于读取游戏内的文字信息,如分数、血量、对话等,常见工具包括Tesseract和PaddleOCR。这些视觉模型通常需要大量标注数据进行训练,且在实时推理时对计算资源要求较高,与直接读取游戏内存相比,视觉方案在延迟和鲁棒性上存在明显劣势。
PPO(Proximal Policy Optimization)和DQN(Deep Q-Network)是深度强化学习中的两种经典算法。DQN由DeepMind于2015年提出,通过Q-learning结合深度神经网络,在Atari 2600游戏上首次达到人类水平,但其训练需要数百万帧的经验回放。PPO是一种策略梯度方法,通过限制策略更新的幅度来保证训练稳定性,广泛应用于连续和离散动作空间。在物理控制器场景下,每一帧的采集涉及机械动作和视觉处理,耗时远高于模拟器中的毫秒级步进,导致样本采集成本急剧上升。此外,物理系统的动作延迟和噪声会进一步降低样本效率,使得原本在仿真中可行的训练周期变得不切实际。
稀疏奖励与中间奖励是强化学习奖励设计中的关键概念。稀疏奖励指智能体仅在完成最终目标(如游戏通关)时获得奖励,其余时间奖励为零,这使得探索变得极其困难,因为智能体很难从随机动作中偶然获得有效信号。中间奖励(又称稠密奖励或塑形奖励)通过提供额外的反馈信号(如接近目标的距离、血量变化等)来引导学习,但设计不当可能引入偏差,导致智能体学会利用奖励漏洞而非真正完成任务。常见的奖励塑形方法包括基于势能的奖励塑形(Potential-Based Reward Shaping),它能在不改变最优策略的前提下提供更密集的反馈。在游戏AI中,合理设计中间奖励需要深入理解游戏机制,并可能需要反复实验调整。
泛化能力是衡量机器学习模型在未见过数据上表现的核心指标。在强化学习中,泛化面临独特挑战:模型不仅需要适应新的状态分布,还要应对动作效果和奖励结构的变化。在游戏场景中,不同游戏的画面风格、操作逻辑、敌人行为模式差异巨大,导致在某一游戏上训练的模型难以直接迁移到另一游戏。迁移学习(Transfer Learning)和领域自适应(Domain Adaptation)是缓解这一问题的常见思路,例如通过微调预训练模型或对齐不同游戏的特征空间。然而,在物理控制器场景下,硬件差异(如手柄力学特性)进一步增加了泛化难度,使得跨游戏甚至跨设备的迁移几乎需要从头训练。因此,实际项目中通常将目标限定在单一游戏或高度相似的场景中。
相关推荐
 科技前沿
Textly:Mac上任意位置抓取文字和表格的效率神器
Textly是一款Mac菜单栏效率工具,支持从截图、PDF、视频和应用中框选捕获文字与表格,保持行列完整并导出CSV、Markdown、TSV,还内置即时翻译和剪贴板历史。
 科技前沿
Frameboy:World Labs Atlas 世界模型浏览器实时体验
World Labs 在 Product Hunt 发布 Frameboy,基于 Atlas 世界模型的浏览器实时演示,移动相机即可在云端 GPU 生成新视角,最高 15 fps 串流,探索 AI 生成的可漫游世界。
 科技前沿
Keypause:一键锁定Mac键盘,清洁时不再误触
Keypause是一款Mac菜单栏应用,一键锁定键盘所有按键,方便清洁时避免误触。本文介绍其功能、使用体验、潜在风险及适用场景,帮你判断是否值得尝试。