语言模型的时间污染:记忆还是推理?
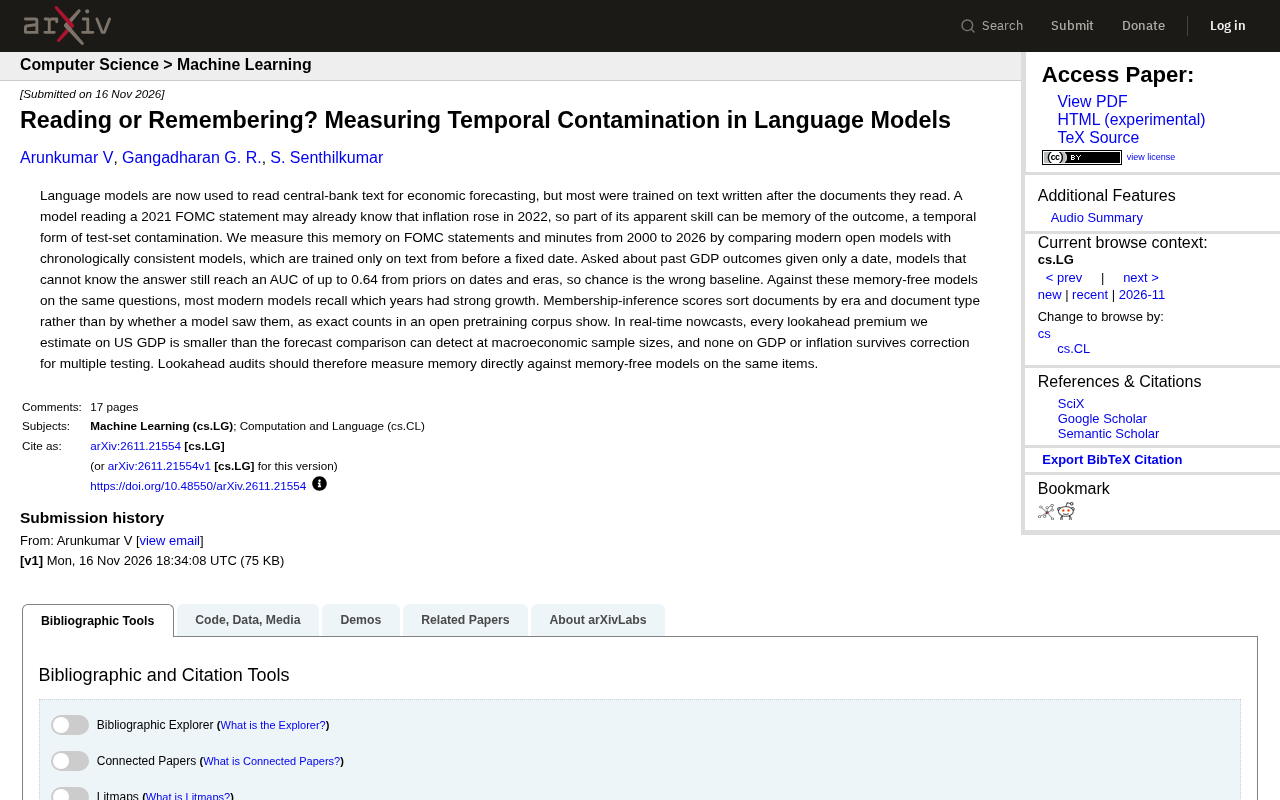
语言模型在经济预测中可能因训练数据包含未来信息而高估预测能力,需直接对比无记忆模型以度量记忆效应。
文章探讨了语言模型在阅读央行文本进行经济预测时面临的时间污染问题:模型在训练中可能已见过文档之后的事件,导致其预测能力部分来自记忆而非推理。研究指出现有评估方法的缺陷,例如随机基线不适用,因为无记忆模型仅凭日期就能达到0.64的AUC。作者提出直接度量记忆的方法,即对比现代模型与无记忆模型,并发现成员推断攻击主要反映时间信号而非真实记忆。在实时预测任务中,美国GDP的前瞻性溢价小于检测阈值且不显著,但作者强调需采用更严谨的审计方法,直接在同一条目上比较模型与无记忆模型。
引言:当模型“提前知道”答案
语言模型正被用于阅读央行文本以进行经济预测,但大多数模型在训练时已经“见过”了它们所要阅读的文档之后写成的文本。例如,一个阅读2021年FOMC声明的模型,可能早已知道2022年通胀会上升。因此,模型表现出的部分预测能力可能并非来自推理,而是对结果的记忆——这是测试集污染在时间维度上的变体。
最近一项研究(原题为“Reading or Remembering? Measuring Temporal Contamination in Language Models”)系统量化了这种时间污染,并指出现有评估方法存在的根本缺陷。
现有评估的盲点:随机基线不适用
当模型被问及“仅凭日期预测过去GDP结果”时,那些理论上无法知道答案的模型(训练数据截止日期早于问题日期)仍然达到了高达0.64的AUC。这意味着,模型能够基于日期和时代先验做出有信息的猜测,而随机猜测(AUC=0.5)是错误的基线。
这一发现挑战了常规的评估逻辑:如果模型无法知道事实,它本应接近随机;但实际表现显著优于随机,说明模型利用了数据中的时间模式,而非因果推理。
AUC(Area Under the ROC Curve)是评估二分类模型性能的常用指标,取值在0.5到1之间。0.5对应随机猜测,1对应完美区分。在时间污染评估中,如果模型无法获取未来信息,其预测应接近随机水平(AUC≈0.5)。然而,研究发现理论上“无记忆”的模型仅凭日期就能达到0.64的AUC,这表明模型利用了数据中的时间模式(如经济周期的自相关),而非真正理解因果关系。因此,使用随机基线会高估模型的预测能力,掩盖记忆效应。
记忆的度量:与“无记忆”模型对比
研究的关键创新在于直接度量记忆:将现代开放模型与时间一致的模型(仅用固定日期之前的文本训练)进行对比。在相同问题上,大多数现代模型能够“回忆”哪些年份增长强劲,而无记忆模型只能依赖先验。这种对比设计避免了用随机基线评估时的偏差。
此外,成员推断攻击(membership inference)的得分主要按时代和文档类型对文档排序,而非按模型是否真正见过它们——这通过开放预训练语料中的精确计数得到验证。这表明,这些攻击反映的是时间信号,而非真正的记忆痕迹。
成员推断攻击(Membership Inference Attack)是一种隐私攻击技术,旨在判断某个特定数据样本是否被用于训练机器学习模型。其基本假设是:模型对训练样本的预测置信度或损失值通常低于未见过样本。然而,在时间序列文本中,成员推断得分可能主要反映文档的时间特征(如时代、文档类型),而非真正的记忆痕迹。例如,模型可能对某个时代的文本整体更熟悉,导致得分偏高,但这并不代表模型记住了特定文档。因此,作者通过开放预训练语料中的精确计数验证了这一点,强调需要更直接的记忆度量方法。
实时预测中的影响:前瞻性溢价微弱
在实际的实时预测(nowcast)任务中,研究估计美国GDP的“前瞻性溢价”(lookahead premium)均小于宏观经济学样本量下预测比较所能检测到的水平;而在GDP或通胀上,经多重检验校正后,没有一项溢价是显著的。
这意味着,尽管时间污染存在,但在实际预测场景中,其影响可能低于检测阈值。不过,作者强调,这并不意味着可以忽视污染,而是需要更直接、更严谨的审计方法。
前瞻性溢价(Lookahead Premium)是指在实时预测(nowcast)任务中,模型因提前接触未来信息而获得的预测性能提升。在经济学预测中,通常使用统计检验(如Diebold-Mariano检验)比较不同模型的预测误差。然而,由于宏观经济学样本量有限(如季度GDP数据),统计检验的检测能力(power)较低,难以发现微小的溢价。作者通过多重检验校正(如Bonferroni校正)控制假阳性率,发现在GDP和通胀预测中,经校正后没有一项溢价显著。这表明,尽管时间污染存在,但其实际影响可能低于当前检测阈值,但这不意味着可以忽视污染,而是需要更灵敏的审计方法。
结论:直接度量记忆,而非依赖随机基线
作者建议,前瞻性审计应直接在同一条目上比较模型与无记忆模型,而不是假设随机基线。这一方法转向,对于评估语言模型在经济预测等时间敏感任务中的真实能力至关重要。
对于AI研究社区而言,这项研究提醒我们:在评估模型时,必须考虑训练数据与测试数据的时间关系,并采用更精确的对照设计,避免将记忆误认为推理。
相关推荐
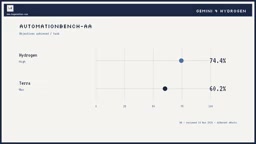
Gemini 4 Hydrogen 深度评测:高性价比之外的真实价值
基于 Artificial Analysis 选型数据与实测反馈,拆解 Gemini 4 Hydrogen 的性价比悖论:高分不等于高价值,自动化工作流与代码任务表现分化,定价与 Google 订阅包各算各的账,SynthID 输出标识可能成为一票否决项。
Gemini 4 Hydrogen 五大极限测试:96.7% 准确率与一键建站
YouTube 创作者对 Gemini 4 Hydrogen 进行五项极限测试:单提示词生成游戏、3D 太阳系模拟、30 分钟视频时间戳定位、287 页财报转交互仪表盘,以及抗幻觉测试中 96.7% 的准确率表现。
Gemini 4 Hydrogen发布:速度提升2.5倍的日常AI模型
Google发布Gemini 4 Hydrogen,宣称比Gemini 3.8 Flash快2.5倍,支持四级思考控制、百万token上下文和Orchestrator多模型协作,API定价每百万输入token 1.50美元。