置信度信号如何揭示问题难度?新研究给出答案
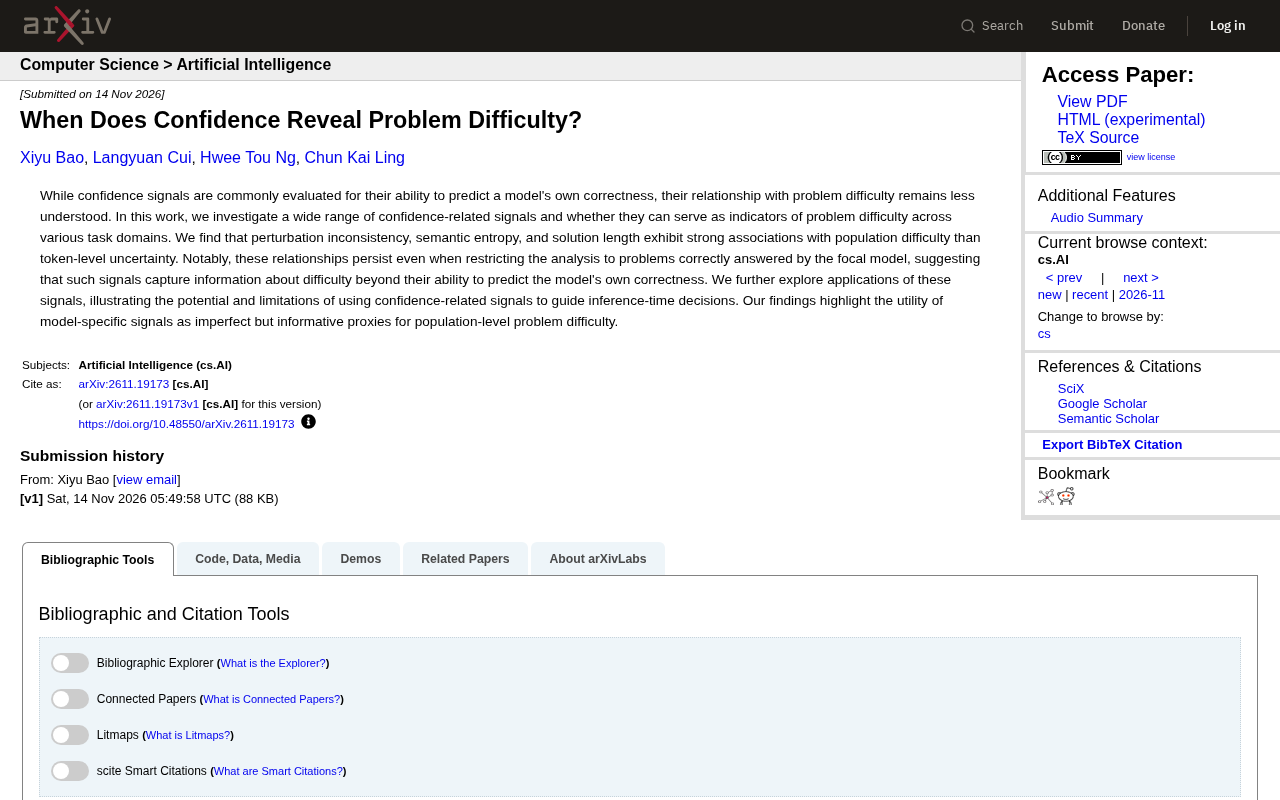
研究发现扰动不一致性、语义熵和解长度比词元级不确定性更能反映问题难度,且独立于模型正确性。
该研究系统考察了多种置信度信号与问题难度之间的关系,发现扰动不一致性、语义熵和解长度与总体难度的关联强度显著高于词元级不确定性。更重要的是,即使仅分析模型正确回答的问题,这些关联依然存在,说明它们捕捉到了超越“预测自身正确性”的难度信息。研究进一步讨论了这些信号在推理时决策中的应用潜力,例如根据信号动态分配计算资源,同时指出信号具有模型特定性、只是不完美的难度代理,需谨慎推广。
引言:置信度不止于判断对错
长期以来,置信度信号(confidence signals)被广泛用于评估模型对自身预测正确性的把握程度。然而,一项最新研究将目光投向了一个更少被探讨的问题:置信度信号能否反映问题本身的难度?
该研究系统考察了多种置信度相关信号,并发现扰动不一致性(perturbation inconsistency)、语义熵(semantic entropy)和解长度(solution length)与总体难度(population difficulty)的关联强度显著高于词元级不确定性(token-level uncertainty)。更你可能没注意到,即使仅分析模型正确回答的问题,这些关联依然存在,说明这类信号捕捉到了超越“预测自身正确性”的难度信息。
语义熵(semantic entropy)是一种面向生成式模型的不确定性度量方法。传统熵基于词元概率分布计算,但同一语义可由多种不同表述表达,词元级熵会高估不确定性。语义熵的做法是:对模型生成的多个回答按语义等价性聚类,再在聚类层面计算熵值,从而忽略表面措辞差异、只保留语义分歧。熵越高,说明模型在“意思”层面越不确定。这一概念最初用于提升大模型问答的可靠性检测,其优势在于能识别“表面自信、语义发散”的情况,因而也被认为可能反映问题本身的歧义性或难度。
研究背景:置信度信号的再审视
在模型评估与推理领域,置信度信号通常被视为模型对自身输出可靠性的度量。传统观点认为,高置信度意味着模型对答案更有把握,而低置信度则暗示可能存在错误。然而,问题难度本身是一个独立于模型正确性的维度——一个模型可能在某道简单题上犯错,也可能在难题上侥幸答对。
这项研究试图回答:置信度信号是否携带了关于问题难度的信息?如果是,哪些信号更为有效?这些信号在模型正确回答的问题上是否仍然有效?
核心发现:三类信号脱颖而出
研究团队对比了多种置信度相关信号,包括扰动不一致性、语义熵、解长度以及词元级不确定性。结果显示,前三者与总体难度的关联强度明显更强。
扰动不一致性衡量的是模型在输入受到轻微扰动时输出的一致性程度;语义熵则捕捉模型在语义层面上的不确定性;解长度反映了生成答案所需的推理步骤或文本长度。这些信号之所以更有效,可能因为它们从不同角度反映了问题本身的复杂程度,而非仅仅映射模型内部的瞬时不确定性。
扰动不一致性(perturbation inconsistency)通过向输入施加轻微、语义保持的扰动(如改写、增删无关词、调整语序),观察模型输出是否稳定来衡量不确定性。若多次扰动后答案高度一致,说明模型对该问题的把握较稳固;若输出频繁变化,则暗示模型处于决策边界附近。与单次前向传播得到的词元概率不同,扰动不一致性刻画的是模型在输入空间邻域内的行为稳定性,因此更可能反映问题本身对模型造成的认知压力,而不仅是某一次生成时的瞬时置信。
关键验证:正确回答下的关联依然存在
一个潜在质疑是:这些信号之所以与难度相关,仅仅是因为它们能预测模型是否正确。为了排除这一解释,研究者将分析限制在模型正确回答的问题上。结果发现,扰动不一致性、语义熵和解长度与难度的关联依然显著。这表明,这些信号确实捕捉到了独立于模型正确性的难度信息。
这一发现具有重要的理论意义:它说明置信度信号不仅是模型自我评估的工具,还可能成为问题难度的代理指标。
总体难度(population difficulty)通常指在给定问题集合上,群体层面的作答表现,例如多个模型或多次采样的平均正确率、平均所需推理步数等。它是一个相对客观、独立于单一模型单次输出的统计量。将置信度信号与总体难度做关联分析,可以检验信号是否携带“题目本身有多难”的信息,而非仅仅预测某次回答的对错。在控制正确性(只分析答对的题目)后关联仍显著,正是排除“信号只是正确性代理”这一竞争解释的关键统计手段。
应用与局限:推理时决策的潜力
研究进一步探讨了这些信号在推理时决策中的应用潜力。例如,在资源有限的情况下,可以根据这些信号动态分配计算资源——对于信号指示难度较高的问题,投入更多推理步骤或调用更复杂的策略。
然而,研究者也指出了局限性。这些信号是模型特定的(model-specific),其与难度的关系可能因模型而异,不能简单推广到其他模型或任务。此外,这些信号只是不完美的代理指标,并非难度的直接度量。
多源交叉验证的启示
尽管本研究主要基于单一来源的分析,但其结论与近期关于语义熵和扰动一致性的其他工作形成了呼应。例如,语义熵在多个研究中被证明能有效识别模型的不确定性,而扰动不一致性也与模型鲁棒性研究中的发现相吻合。这些跨研究的共识增强了上述信号作为难度代理的可信度。
结论:不完美但有价值的难度代理
这项研究揭示了置信度信号与问题难度之间的深层联系。扰动不一致性、语义熵和解长度不仅与模型正确性相关,还能在模型正确回答的问题上继续反映难度差异。尽管这些信号并非完美的难度度量,但它们为推理时决策提供了有价值的参考。
对于AI研究者和开发者而言,这意味着在评估模型或设计推理策略时,可以更有意识地利用这些信号,而不仅仅将其视为正确性的预测器。未来的工作可以进一步探索如何将这些信号与其他难度估计方法结合,以提升推理效率和可靠性。
相关推荐
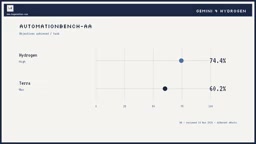
Gemini 4 Hydrogen 深度评测:高性价比之外的真实价值
基于 Artificial Analysis 选型数据与实测反馈,拆解 Gemini 4 Hydrogen 的性价比悖论:高分不等于高价值,自动化工作流与代码任务表现分化,定价与 Google 订阅包各算各的账,SynthID 输出标识可能成为一票否决项。
Gemini 4 Hydrogen 五大极限测试:96.7% 准确率与一键建站
YouTube 创作者对 Gemini 4 Hydrogen 进行五项极限测试:单提示词生成游戏、3D 太阳系模拟、30 分钟视频时间戳定位、287 页财报转交互仪表盘,以及抗幻觉测试中 96.7% 的准确率表现。
Gemini 4 Hydrogen发布:速度提升2.5倍的日常AI模型
Google发布Gemini 4 Hydrogen,宣称比Gemini 3.8 Flash快2.5倍,支持四级思考控制、百万token上下文和Orchestrator多模型协作,API定价每百万输入token 1.50美元。