准确率相同,选哪个模型?看分片与逐例对比
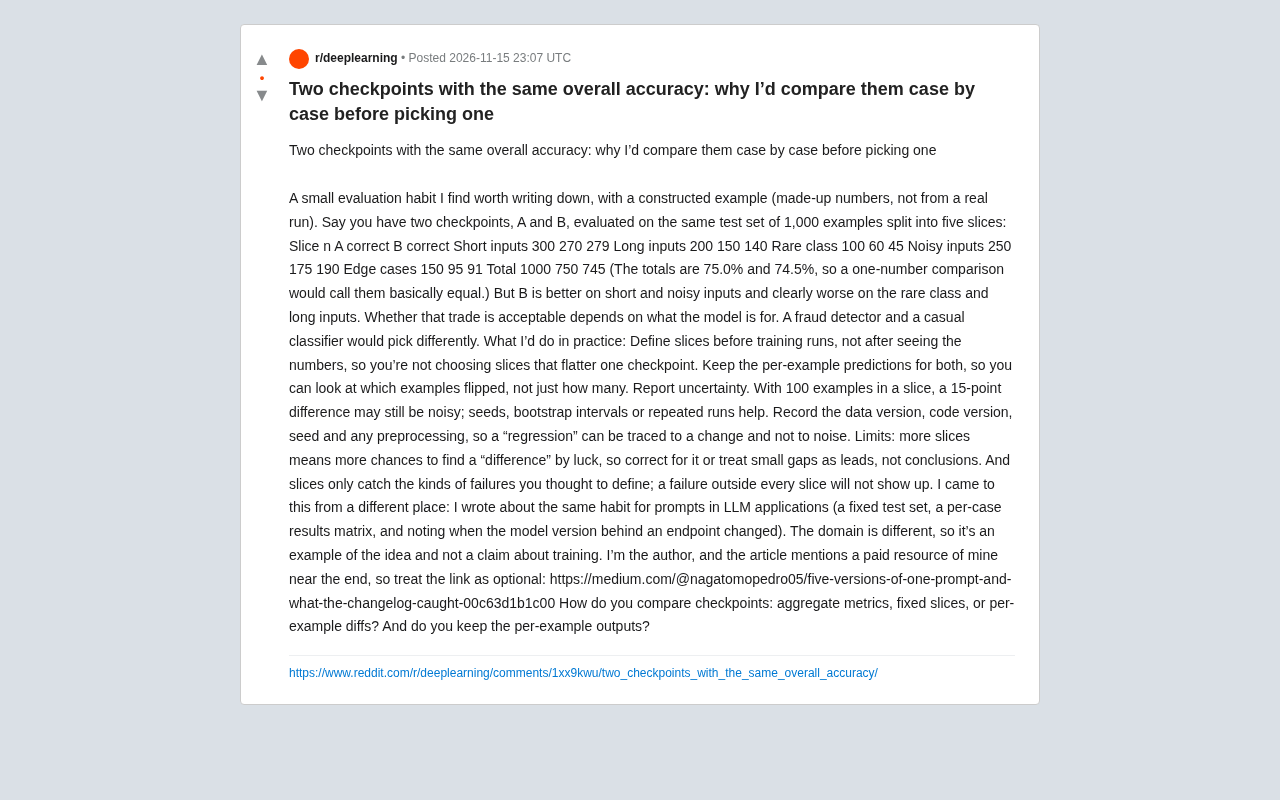
总体准确率接近的检查点可能在切片层面表现迥异,需结合逐例对比与不确定性报告做决策。
文章通过一个虚构示例说明:两个模型总体准确率仅差 0.5 个百分点(75.0% vs 74.5%),但在五个切片上表现此消彼长——模型 B 在短输入和噪声输入上更好,在稀有类别和长输入上明显更差。因此选择哪个检查点取决于应用场景。作者据此提出四个评估习惯:训练前定义切片以避免事后选择偏差、保留逐例预测结果以揭示翻转样本、报告不确定性以判断差异是否稳定、记录数据与代码版本以便追溯。文章也指出切片方法的边界:切片越多越容易靠运气找到显著差异,需多重比较校正;且切片只能捕捉预先想到的失败类型,存在覆盖盲区。
为什么总体准确率会骗人
两个模型检查点在同一个测试集上跑出几乎一样的总体准确率,直觉上会认为它们性能相当。但 Reddit 上一位开发者分享的评估习惯指出,这种一维比较可能掩盖关键差异。
他构造了一个示例(明确说明数字是虚构的,并非真实运行结果):测试集共 1000 个样本,划分为五个切片。模型 A 总体正确 750 个(75.0%),模型 B 正确 745 个(74.5%),差距仅 0.5 个百分点。单看这个数字,多数人会判定两者基本持平。
但切片数据讲的是另一个故事:B 在短输入和噪声输入上更好,在稀有类别和长输入上明显更差。这种此消彼长意味着,选择哪个检查点取决于模型要解决什么问题——欺诈检测器和休闲分类器会做出完全不同的决定。
切片对比揭示的权衡
原帖给出的切片数据如下(数字均为虚构):
| 切片 | 样本数 | A 正确 | B 正确 |
|---|---|---|---|
| 短输入 | 300 | 270 | 279 |
| 长输入 | 200 | 150 | 140 |
| 稀有类别 | 100 | 60 | 45 |
| 噪声输入 | 250 | 175 | 190 |
| 边缘案例 | 150 | 95 | 91 |
| 总计 | 1000 | 750 | 745 |
B 在短输入上多对 9 个,在噪声输入上多对 15 个;但在稀有类别上少对 15 个,在长输入上少对 10 个。对于需要覆盖稀有类别的场景(比如欺诈检测),B 的总体优势毫无意义;而对于输入短、噪声多的场景,B 可能是更优选择。
这个示例的价值不在于数字本身,而在于它展示了一种评估思维:总体指标是切片表现的加权平均,权重由测试集分布决定,而测试集分布未必匹配真实业务分布。
实践中的四个评估习惯
原帖作者给出了他认为值得坚持的做法,这些建议针对的是训练检查点比较,但思路可以迁移。
切片定义要在训练前完成。 如果看到数字之后再划分切片,很容易挑出对某个检查点有利的切法。预先定义切片,相当于提前锁定评估维度,避免事后选择偏差。
保留逐例预测结果。 不仅要看每个切片对了多少,还要看具体哪些样本发生了翻转。逐例对比能回答“B 比 A 好在哪、差在哪”这种定性问题,而聚合数字只能回答“差多少”。
报告不确定性。 原帖特别提到,一个切片只有 100 个样本时,15 个百分点的差异仍可能是噪声。种子变化、bootstrap 区间或重复运行都能帮助判断差异是否稳定。
记录数据版本、代码版本、种子和预处理。 这样当出现“性能回退”时,可以追溯到具体变更,而不是归咎于随机波动。
不确定性量化在这里指的是对观测到的指标差异是否超出随机波动范围的统计判断。在机器学习评估中,测试集本身只是从数据分布中抽取的一个样本,因此任何指标都带有抽样误差。常用的量化手段包括:bootstrap 重采样(从测试集中有放回地抽取多个子集,计算指标的经验分布,得到置信区间)、多次随机种子重复训练与评估(观察指标在不同初始化下的方差),以及基于二项分布的标准误估计(对于准确率,标准误约为 sqrt(p(1-p)/n))。当两个模型的指标差异小于置信区间宽度时,就不能断言一个模型真正优于另一个。原帖提到的“100 个样本上 15 个百分点差异可能是噪声”正是这一原理的体现:在 n=100 时,准确率的标准误约为 5%,15 个百分点的差异仅约 3 个标准误,在多重比较下并不稳健。
切片方法的边界
作者也坦率指出了局限。切片越多,靠运气找到“显著差异”的机会越大,因此需要做多重比较校正,或者把小差距当作线索而非结论。
更根本的限制是:切片只能捕捉你想到要定义的失败类型。如果某个失败模式不在任何切片中,它就不会在评估里显现。这意味着切片设计本身是一种领域知识的体现,而不是纯机械操作。
作者提到自己是从另一个场景迁移到这个习惯的:在 LLM 应用中为提示词做固定测试集、逐例结果矩阵,并记录端点背后模型版本的变化。他强调领域不同,所以这只是思路示例,不是关于模型训练的论断。
多重比较校正是统计学中用于控制“假阳性”风险的方法。当同时进行多次假设检验时(例如在多个切片上比较两个模型),即使每次检验的显著性水平设为 0.05,进行 20 次独立检验时至少出现一次假阳性的概率也高达约 64%。常用的校正方法包括 Bonferroni 校正(将显著性阈值除以检验次数)和 Benjamini-Hochberg 程序(控制错误发现率 FDR)。在切片评估中,这意味着如果定义了较多切片并逐一比较,就需要调整显著性判断标准,否则容易把随机波动误认为真实差异。原帖建议“把小差距当作线索而非结论”,正是多重比较思维在工程实践中的简化表达。
这对评估工作流意味着什么
原帖以一个开放问题结尾:你如何比较检查点——聚合指标、固定切片,还是逐例差异?是否保留逐例输出?
这个问题没有标准答案,但帖子传递的信号很明确:当两个检查点总体指标接近时,逐例和分片视角提供的决策依据远比一个标量丰富。对于需要模型在特定子群体上可靠的场景,这种细粒度对比不是可选项,而是必要步骤。
作者在文末提到自己的文章包含付费资源链接,并说明链接是可选的。
相关推荐
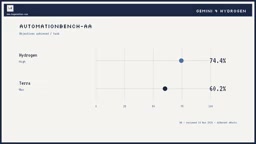
Gemini 4 Hydrogen 深度评测:高性价比之外的真实价值
基于 Artificial Analysis 选型数据与实测反馈,拆解 Gemini 4 Hydrogen 的性价比悖论:高分不等于高价值,自动化工作流与代码任务表现分化,定价与 Google 订阅包各算各的账,SynthID 输出标识可能成为一票否决项。
Gemini 4 Hydrogen 五大极限测试:96.7% 准确率与一键建站
YouTube 创作者对 Gemini 4 Hydrogen 进行五项极限测试:单提示词生成游戏、3D 太阳系模拟、30 分钟视频时间戳定位、287 页财报转交互仪表盘,以及抗幻觉测试中 96.7% 的准确率表现。
Gemini 4 Hydrogen发布:速度提升2.5倍的日常AI模型
Google发布Gemini 4 Hydrogen,宣称比Gemini 3.8 Flash快2.5倍,支持四级思考控制、百万token上下文和Orchestrator多模型协作,API定价每百万输入token 1.50美元。