#多模态模型
共 41 篇相关文章

自蒸馏空间推理:精度提升且延迟几乎不增
SpatialOPSD 通过自蒸馏将特权深度信息内化到 RGB 单次前向推理,在 Qwen3.5‑9B 上把准确率从 45.9 提升到 51.9,保留教师模型 91% 性能,同时消除外部工具调用的运行时开销,优于 SFT 与 GRPO。
Gemini 4 Argon深度实测:编程、多模态全面进化,AI自我复制引担忧
Gemini 4 Argon正式发布并全球推送,深度实测显示其在编程、多模态、3D生成方面表现强劲,编程速度与成本优于Opus 5.5,但幻觉问题仍存。同时Anthropic Fable 5.5、OpenAI GPT-6.1 Astra曝光,AI自我复制研究引发安全担忧。

NEURA推出Neuron AI:让机器人能触摸、聆听与记忆的基础模型
NEURA Robotics发布Neuron AI多模态基础模型,在VLA架构上融合触觉、声音与记忆能力,支持机器人本体运行无需云端。本文梳理其PLA架构、训练数据、部署方式及待验证的能力主张。

微软MAI模型接入Vercel AI Gateway:语音、转录与图像一站集成
微软 MAI 系列模型正式接入 Vercel AI Gateway,覆盖语音生成、实时转录与图像生成编辑,公布按模态分别计费的定价,并提供零数据保留姿态与集成路径。

Le Chonk视觉定位模型:Dense 200跑出42%超越闭源前沿
Le Chonk视觉定位模型在Dense 200基准上取得42%成绩,宣称超越前沿闭源模型。本文解读视觉定位任务难点、该成绩的技术信号及对开发者的实际价值。

Cloudflare clef-omni:不生成文本的30B开源决策模型
Cloudflare 开源 clef-omni,一个 30B 多模态决策模型,不生成文本,只输出带校准的概率。本文拆解它的原理、对比 Jev 的基准数据、音视频调用成本与本地部署门槛。

MiniCPM-V 4.7 35B-A3B:首个开源MoE多模态端侧模型
面壁智能发布 MiniCPM-V 4.7 35B-A3B,MiniCPM-V 系列首个 MoE 多模态模型,支持 iPhone 17 Pro Max 端侧 13+ tokens/s 推理,覆盖 iOS/Android/HarmonyOS 及多芯片平台。

VLM空间理解之谜:表征层面为何不如词汇先验可靠
一项新研究发现,视觉语言模型(VLM)在表征层面对空间关系的编码忠实度远低于词汇信息,即便输出评估得分很高。借助 EICS 指标与 CASP-VL 基准,研究揭示关系信息在句子聚合阶段被 EOS token 或均值池化抹除,暴露了输出评估无法察觉的系统性缺陷。

PRISM:多模态语言模型如何重塑临床预后预测
PRISM 是一个检索增强的多模态语言模型,用于临床预后预测。它结合数值 token 化、纵向 ECG 聚合与人群记忆库,在 MDS-ED 基准上取得优异表现,并揭示了结构化融合与跨机构适配的关键价值。
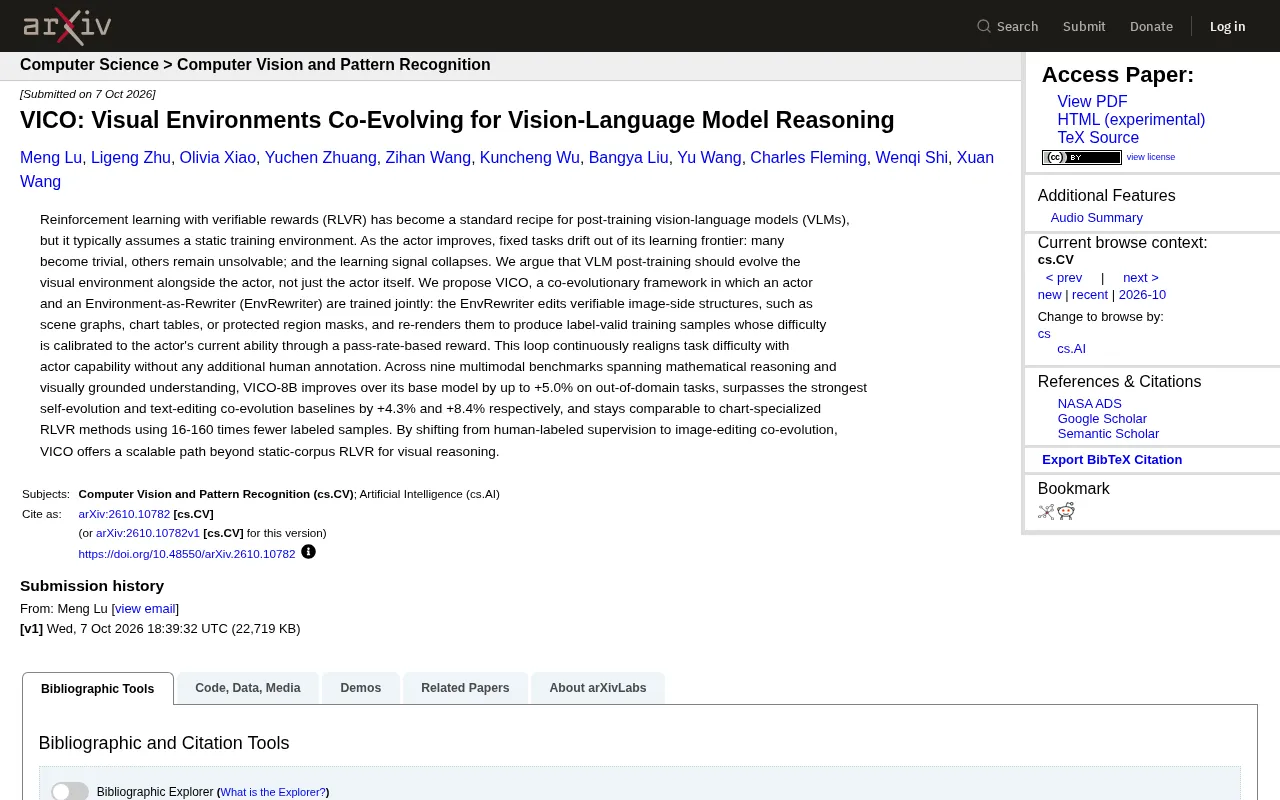
VICO框架:让视觉环境与视觉语言模型协同进化
VICO提出一种视觉环境与视觉语言模型协同进化的训练框架,通过EnvRewriter动态校准任务难度,在九个多模态基准上超越多项基线,并以16-160倍更少的标注样本达到专用方法水平,为VLM后训练提供可规模化新路径。

SLVR:用结构化潜在推理提升多模态视觉理解
SLVR 提出结构化潜在视觉推理框架,将多模态推理拆分为规划、定位、证据选择与整合四个潜在阶段,在 MMVP、BLINK 等基准上显著提升,兼顾推理质量与效率。

UniEvo-VL:自蒸馏训练如何让多模态模型自我进化
UniEvo-VL 提出用自蒸馏训练实现多模态模型的自我改进。本文解读自蒸馏在视觉语言模型中的工作机制、潜力与局限,探讨这一自我进化路线能否破解图文数据标注瓶颈。

Cloudflare开源Clef:把AI决策变成概率输出的27B多模态模型
Cloudflare开源决策模型Clef:27B多模态模型,接收状态与类型化问题模式,单次前向传播输出结构化概率,无需文本生成与解析,兼容Jev和SystemOne。

CMU公开课深度解读:计算机操作智能体(CUA)的演进、评测与训练
CMU 2026 AI Agent公开课第七讲深度解读:计算机操作智能体(CUA)的九年演进史、四类评测范式(静态/端到端/LLM裁判/人工),以及预训练、SFT、RL三阶段训练流程,从World of Bits到GPT-6 Astra全景剖析。
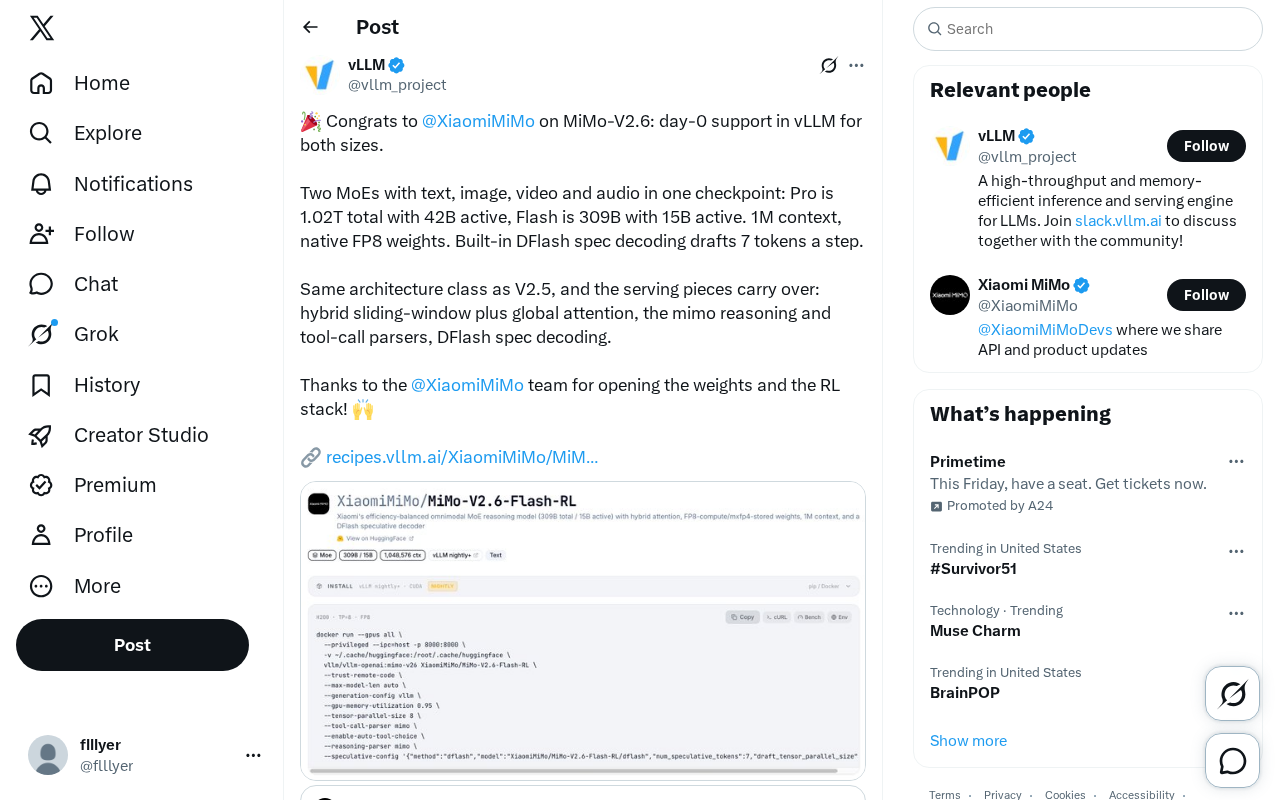
小米MiMo-V2.6发布:万亿参数多模态MoE,vLLM零日支持
小米发布多模态大模型MiMo-V2.6,推出Pro(1.02T参数)与Flash(309B参数)两个MoE版本,支持1M上下文、原生FP8权重与DFlash投机解码,并获得vLLM零日支持,同步开放权重与RL训练栈。
 前沿研究
SciMDR:7B小模型如何在科研推理上比肩GPT-5
耶鲁大学等机构推出SciMDR框架,通过两阶段数据合成流水线,让70亿参数小模型在科研文献阅读理解上达到接近GPT-5水平。本文详解其降维构建与升维重塑的核心技术原理及实验结果。
 科技前沿
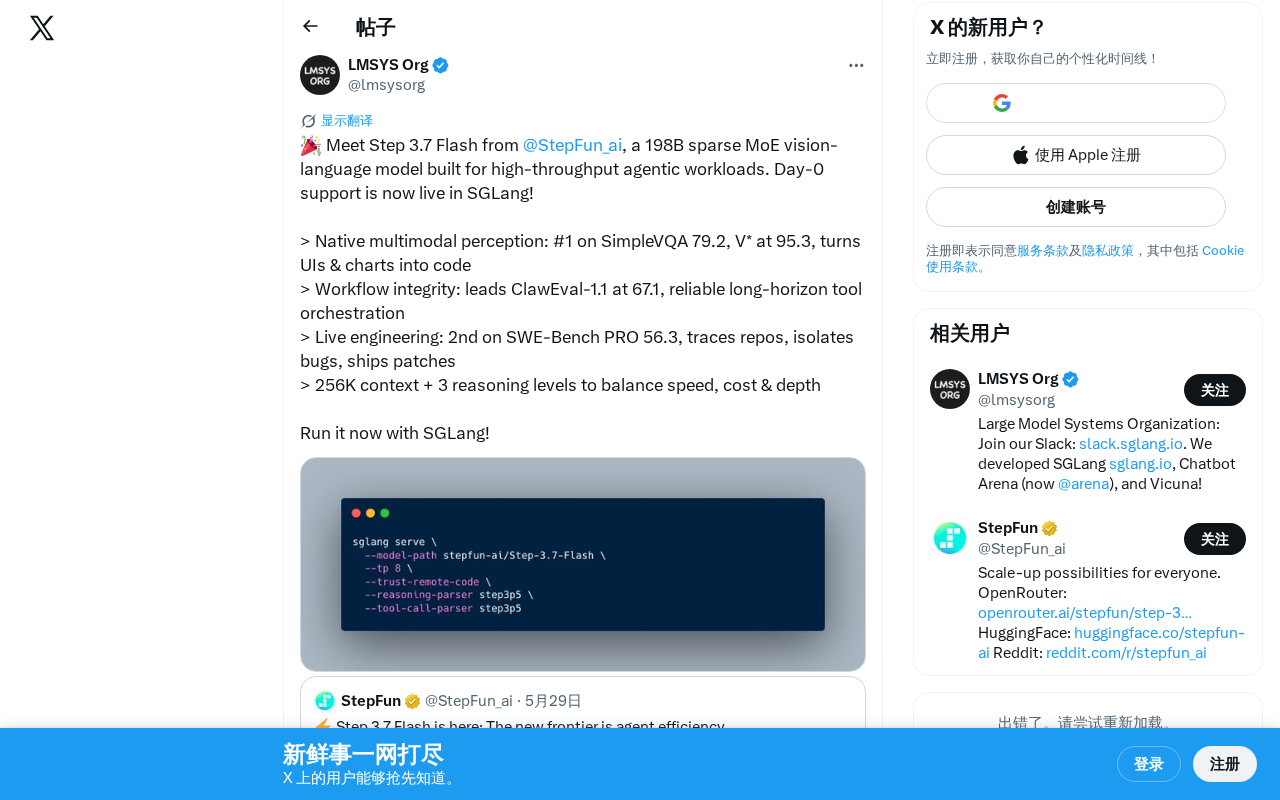
Step 3.7 Flash:198B稀疏MoE多模态模型深度解析
深度解析StepFun AI发布的Step 3.7 Flash,一款198B参数稀疏MoE视觉语言模型,支持256K上下文与三级推理,在多模态理解、AI编程和Agent工具编排方面表现顶尖,已获SGLang首日支持。
 科技前沿
Meta Muse Spark发布:原生多模态推理模型全面解析
Meta超级智能实验室发布Muse Spark,一款原生多模态推理模型,支持视觉思维链、工具调用和多智能体协调。本文深入解析其核心能力、开源策略及行业竞争格局。

