#大语言模型
共 214 篇相关文章

ContextAdapt:大模型价值对齐的情境适应性测评
arXiv新论文ContextAdapt提出价值对齐评估框架,跨医疗、法律、金融、国安四领域测评12个大模型在诚实、自主、保密价值上的情境适应能力。研究发现模型行动恰当性达95.6%,但正确理由使用率差异巨大,且风险感知会干扰判断。
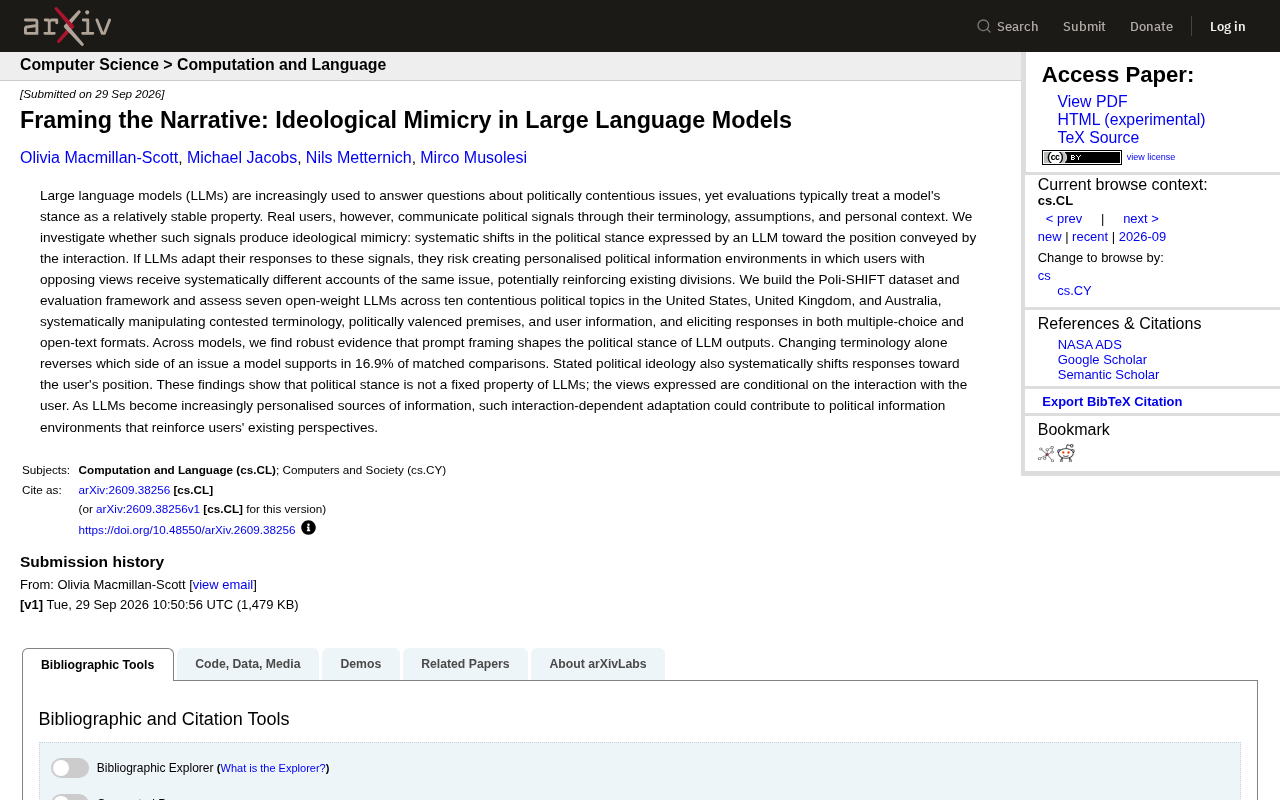
大语言模型的"意识形态模仿":你的措辞正在左右AI的政治立场
最新 arXiv 论文揭示大语言模型存在"意识形态模仿"现象:仅改变措辞就能在16.9%的情况下逆转模型的政治立场。研究基于 Poli-SHIFT 框架测试7个开源LLM,警示个性化政治信息环境可能加剧社会分化。
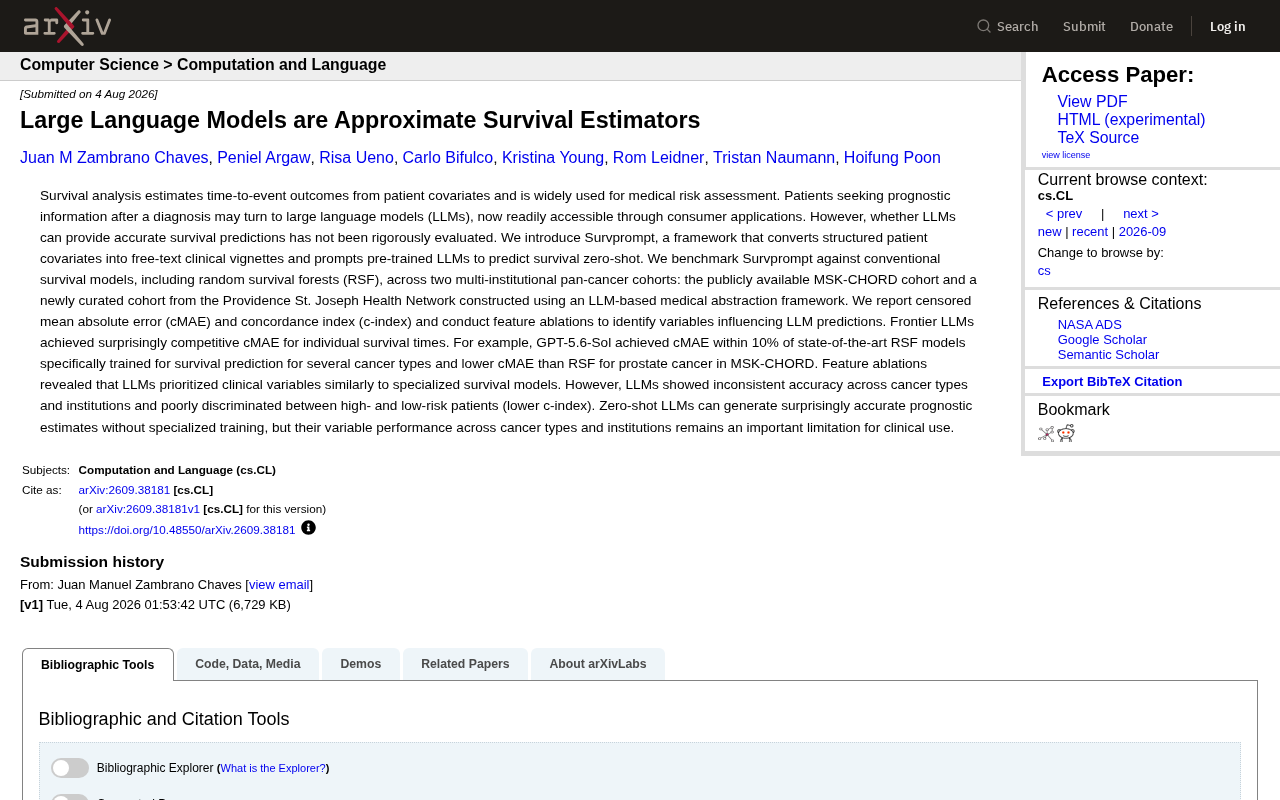
大语言模型能预测患者生存期吗?Survprompt框架给出答案
arXiv最新研究提出Survprompt框架,首次严格评估大语言模型(LLM)在癌症患者生存期预测上的表现。结果显示前沿LLM零样本cMAE媲美专业生存模型,但风险区分能力不足,跨癌种稳定性成临床应用瓶颈。
对齐数据也会诱发失准:大模型的"语境混淆"难题
arXiv 新研究揭示"语境混淆"现象:即便使用对齐数据微调,大模型也可能在其他语境下诱发失准行为。文章解析该现象在性别平等、隐私、人身安全三领域的验证、机制解释及缓解手段。

GFlowNet突破模式坍缩:生成多样化专家对话合成数据
arXiv新论文提出用生成流网络GFlowNet解决合成数据的模式坍缩问题,按比例采样多样化专家策略,在辅导与情感支持对话中实现保真度、模式覆盖与真实性的更优平衡,为LLM后训练提供高质量合成数据新思路。

Ollama入门指南:零基础本地部署开源大模型
Ollama 是一款开源免费的本地大模型管理工具,支持 Windows、Mac、Linux 和 Docker,可自动调度 GPU/CPU 资源,轻松部署 DeepSeek 等开源模型。本文带你零基础了解 Ollama 的核心功能与特点。
谷歌发布 Gemini 4 Argon:下一代 AI 模型引发热议
谷歌正式发布 Gemini 4 Argon 新一代 AI 模型,登上 Hacker News 热榜。本文解析该模型的定位、社区关注焦点及其对开发者与行业竞争格局的潜在影响。
LLM条件控制的两难:有效性与流畅性的系统研究
一项系统研究揭示大语言模型(LLM)条件控制中的核心矛盾:高效的引导方法往往以牺牲文本流畅性为代价。文章解析有效性与流畅性的权衡关系及其对模型部署的启示。
TRACE框架:用树状关系结构增强肿瘤学大模型
TRACE是一个面向肿瘤学大模型的树状关系结构增强框架,通过离线学习医学结构、在线轻量推理,在十项分类任务与问答基准上超越RAG和GraphRAG,并产出可解释的临床证据路径,为医疗LLM的可审计部署提供新思路。

对齐预测:训练前预判AI模型失准风险
arXiv新研究提出"对齐预测"任务:在训练前预判微调数据是否会导致语言模型失准。团队构建了含5000+问题的ALIGNMENTFORECASTBENCH基准,并设计预测脚手架,能标记前沿分类器漏掉的问题样本。
提示词扰动如何影响大模型的偏见与幻觉?
一篇 arXiv 研究评估了提示词扰动对大语言模型偏见与幻觉的影响,发现扰动有时反而能缓解问题,且 Claude 3 比 GPT-3.5 表现更稳定,为可信 AI 部署提供参考。
Sieve与Sage框架:让检索增强模型学会"知之为知之"
arXiv 最新研究提出 Sieve and Sage 框架,通过解耦检索失败状态、两级流水线设计,让检索增强语言模型(RALM)学会可靠弃权,准确率最高提升69.4个百分点,速度提升1.99倍。
分词边界的代价:压缩效率与预测质量的量化博弈
arXiv 最新论文量化分词边界的压缩代价:英文维基上边界规则使 token 数增加 28.3%-36.8%,BPE 比无约束下界高 10.9%。研究还发现压缩与预测偏爱不同词典,并提出边界许可证机制,仅放宽 10% 词表即可恢复绝大部分压缩收益。
微调LLM还需要人类可读文本吗?DASA给出否定答案
arXiv新论文提出DASA方法,通过激活梯度反馈优化连续合成嵌入用于LLM微调,无需人类可读文本。在Llama和Qwen共6个模型上,性能追平并超越自然语言数据,较GRADMM提速3.6-4.9倍。
Claude Sonnet 5.5实测:性能飙升成本骤降的商业甜点级AI
Anthropic低调发布Claude Sonnet 5.5,编程基准从10.3%飙升至70.6%,速度提升30%、成本降低30%,定价仅Opus一半。本文深度解读其编程能力、知识工作表现、成本优势与安全防护。
GPT-6.1 Sol发布:性价比大幅提升的近旗舰级模型
OpenAI在DevDay推出GPT-6.1 Sol,主打以五分之一价格实现接近Astra旗舰的智能。开发者Simon Willison通过"骑自行车的鹈鹕"测试给出初步观察,分析这款主打性价比的新模型。

GPT 6.1 Sol 发布引发热议:素材有限下的初步观察
OpenAI 官网发布 GPT 6.1 Sol 引发 Hacker News 热议,短时间获 294 赞和 200+ 评论。本文梳理已知信息、社区反应与命名策略背后的考量,并提供理性评估新模型的方法。

白宫押注AI聊天机器人:America.gov能否破解政府迷宫?
美国政府推出America.gov,试图用AI聊天机器人简化公民办事流程。但大语言模型的幻觉问题在高风险的公共服务场景中带来严峻挑战。本文分析这场公共AI实验的机遇与风险。