#模型量化
共 50 篇相关文章
Voodoo Dynamic Quant开源:用梯度下降优化模型量化
开发者开源动态量化方法 Voodoo Dynamic Quant,采用 MIT 协议。它用梯度下降优化 GGUF 模型的逐张量量化布局,在激进低比特档位优于 Unsloth Dynamic 3.0,为低显存本地部署提供新工具。
bartowski更新GGUF量化:逐张量布局图解析
bartowski 更新 Qwen3.8-27B-GGUF 模型仓库,引入逐张量布局映射(Per-tensor layout),以图表和表格展示每个张量的量化类型,提升 GGUF 量化的透明度与可解释性,帮助本地大模型用户更理性地选择量化版本。
 产品体验
Mac本地跑Qwen3.6-27B:4种方案实测对比
实测对比Mac本地运行Qwen3.6-27B的4种方案,包括GGUF、MLX Diflash和MTP-LX。MTP-LX 4bit方案以43.6 tok/s速度领先,编码、写作、推理质量均可圈可点,附安装配置指南。
 教程攻略
Ollama本地部署大模型教程:安装配置到API调用全流程
详解Ollama本地部署开源大模型的完整流程,涵盖安装配置、模型选择与量化策略、Python代码调用API、性能优化等实战技巧,帮你快速在本地运行Qwen、Llama等大模型。
 产品体验
Qwen3.6量化版本地部署实测:NVFP4、APEX、Q4、Q6哪个最值得选
实测Qwen3.6系列7-8个量化模型在工具调用、命令行操作、Bug修复、数学推理等8大维度的表现,对比NVFP4、APEX、Q4、Q6量化方案,附总分排名与选购建议,帮你找到最适合本地部署的量化版本。
 产品体验
Qwen3.6 27B三大邪修量化模型实测:代码暴增15.8PP、40B蒸馏、16GB适配
实测对比三款基于Qwen3.6 27B的社区邪修量化模型:OmniMerge V4代码能力提升15.8个百分点,40B OPUS蒸馏版支持角色扮演与创意写作,16GB特化版让小显存也能跑稠密模型。附显存要求、参数设置与选型建议。
 教程攻略
NVIDIA Model Optimizer训练后量化(PTQ)实战指南
深入解析NVIDIA Model Optimizer训练后量化(PTQ)工作流,涵盖INT8/INT4量化原理、校准方法、RTX GPU优化策略及大语言模型量化部署最佳实践,助你在消费级显卡上高效运行大模型。
 前沿研究
SVDQuant:4-bit量化让扩散模型在消费级GPU上高效运行
SVDQuant是ICLR 2025 Spotlight论文,通过低秩分解吸收异常值实现扩散模型4-bit量化,显存降低75%。开源项目Nunchaku获3800+ Stars,让FLUX等大型图像生成模型在RTX 4060等中端显卡上流畅推理。
 科技前沿
IBM Granite 4.1开源模型:21个量化版本SVG生成实测对比
IBM发布Granite 4.1系列开源大模型(Apache 2.0),Unsloth提供21种GGUF量化版本。Simon Willison用鹈鹕SVG测试不同量化级别,发现3B模型在SVG生成上表现一致——都很差,揭示了模型选型的关键启示。
 科技前沿
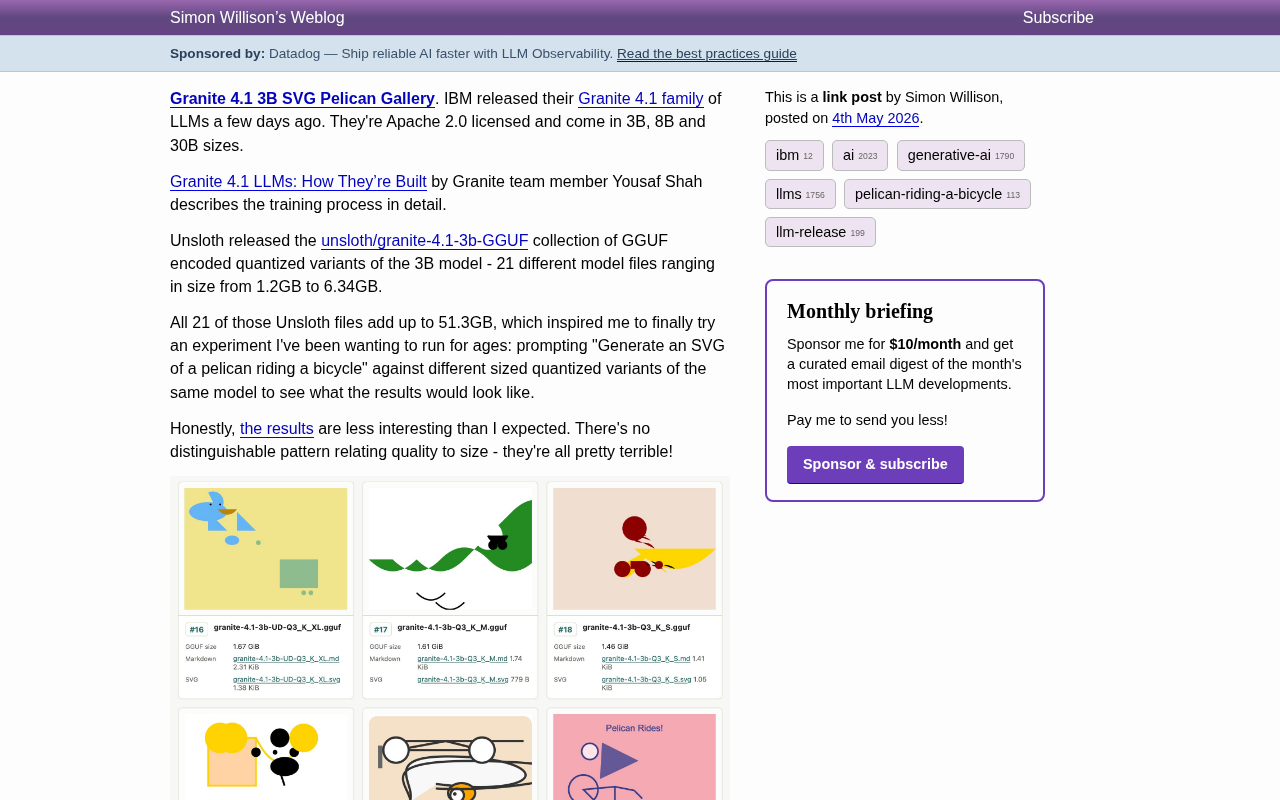
IBM Granite 4.1量化测试:21个GGUF版本SVG生成对比实验
IBM Granite 4.1开源模型发布,Unsloth提供21种GGUF量化版本。Simon Willison用鹈鹕骑自行车SVG测试发现:3B小模型中量化级别对生成质量影响微乎其微,最小模型反而画出最好的自行车。