#模型量化
共 50 篇相关文章

Saluki 27B:2-bit量化模型如何在工具调用上反超原版
Underdog Saluki 27B是基于Qwen3.8-27B的2-bit量化模型,体积仅7.89GB,却在工具调用上超越54GB原版,但在数学推理上有所退步。解析低比特量化的能力重新分配现象。

本地单卡748 token/s:Bonsai2+Ninfer+KVMem极值实践
本地单卡实测Ninfer+Bonsai2+KVMem组合,投机解码融合带来748 token/s解码与3.8K预填充的极值表现,并深入分析KVMem显存卸载、雷霆大思考死循环问题与小模型的框架化用法。

RTX3090极限挑战125B大模型:三级缓存让推理提速5倍
RTX 3090(24GB显存)加24GB内存部署125B参数Flash Next大模型实测:通过三级缓存、Q2K量化和计算重叠三步优化,生成速度从每秒1.83个token提升到9-10个,峰值18。深度解析MoE模型本地部署的带宽瓶颈与优化思路。

Strata本地实测:180B MoE大模型塞进12GB显卡
Strata本地推理引擎实测把180B级Qwen3.8-Flash-Next MoE模型跑在12GB消费级显卡上,通过稀疏激活、GSQ量化与专家三层缓存实现90+ tokens/秒。本文解析其技术原理与长上下文性能表现。
RTX 4090 跑 125B 大模型:Qwen3 Next 实现 100 T/s 推理
开发者在单张 RTX 4090 消费级显卡上运行 125B 参数的 Qwen3 Next Flash 模型,实现约 100 tokens/s 推理速度。本文解析 MoE 架构、量化技术如何让千亿大模型落地消费级硬件。

6GB跑27B大模型?Bonsai 2三值量化的真相与局限
Prism ML的Bonsai 2号称6GB显存保留Qwen3-27B 98%性能。实测显示短任务确实打平,但长链agentic构建全线崩溃。本文剖析三值量化原理与压缩技术的真实局限。
Bonsai 2实测:27B模型压进6GB,98%性能是真的吗?
Bonsai 2将Qwen 27B模型三值量化压缩进6GB文件,可在MacBook本地运行,宣称保留98%性能。实测显示它在聊天问答中表现优秀,但在长程agentic任务中会陷入重复循环无法完成,本文解析其适用边界。
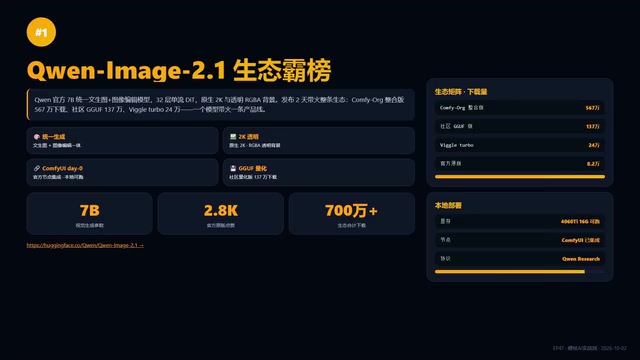
HF热榜深度解析:Qwen-Image-2.1生态霸榜,开源模型迎来爆发时刻
Hugging Face最新热榜深度解析:Qwen-Image-2.1生态三天567万下载霸榜,DeepSeek-V4.1-Flash以763B参数和890字节KV缓存压缩杀入前列,LTX-2.5视频生成158万下载。开源模型竞争从拼参数转向拼落地效率。
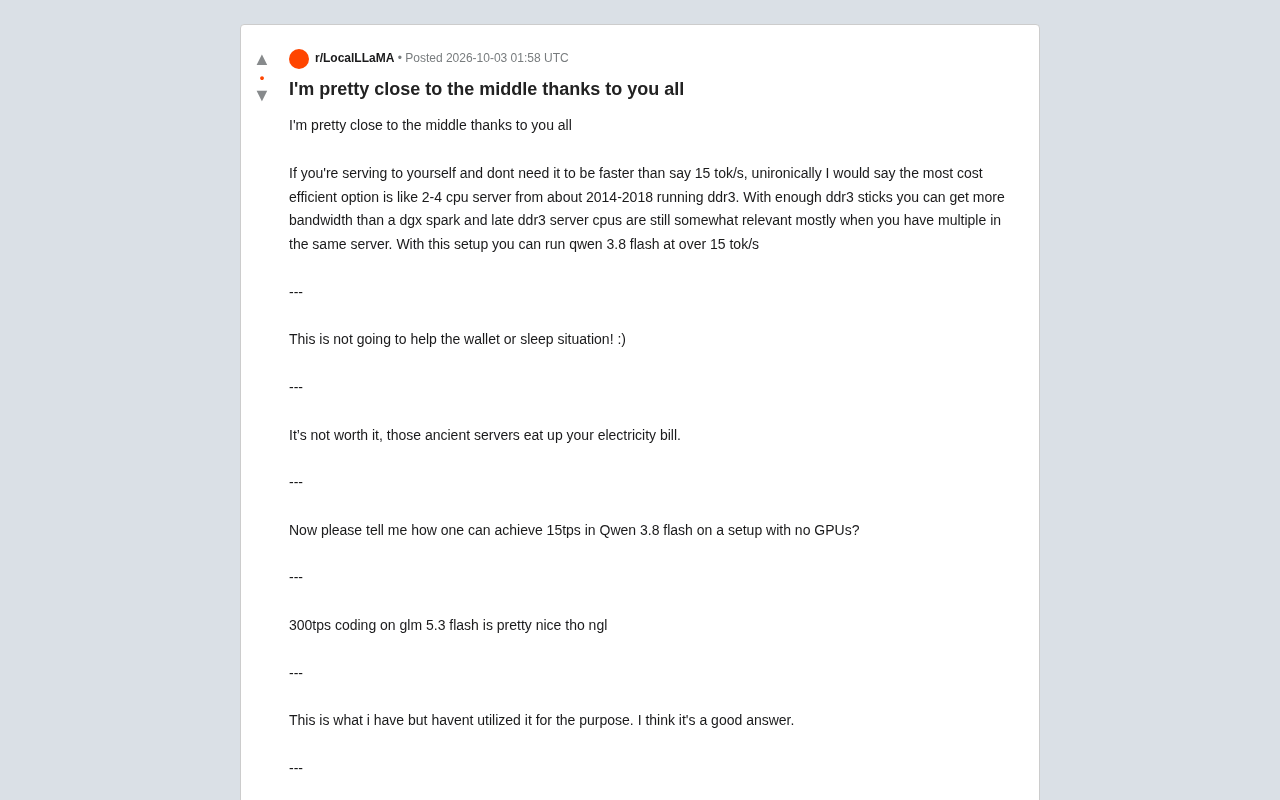
无GPU也能跑大模型?老旧DDR3服务器的本地推理性价比探讨
一场Reddit讨论探讨了无GPU本地部署大模型的可行性:用老旧DDR3多路服务器靠内存带宽跑Qwen 3.8 Flash,以及4bit量化、KV缓存与上下文长度的实用权衡与电费成本争议。

大模型本地部署实战:Ollama、vLLM与量化方案全解析
大模型本地部署完整指南:对比 Ollama、vLLM、LM Studio 三大工具的适用场景,以通义千问 Qwen3.8 的 27B 模型为例详解 BF16、FP8、INT4 等量化方案的显存需求与显卡选型建议。
英伟达Jetson本地跑Qwen3 27B:NVFP4+投机解码实测解析
英伟达在Jetson平台针对Qwen3 27B稠密模型做本地推理优化,采用NVFP4量化叠加投机解码的最优组合,让高端大模型在边缘设备上从能跑到能用。本文解析其技术原理与本地部署价值。
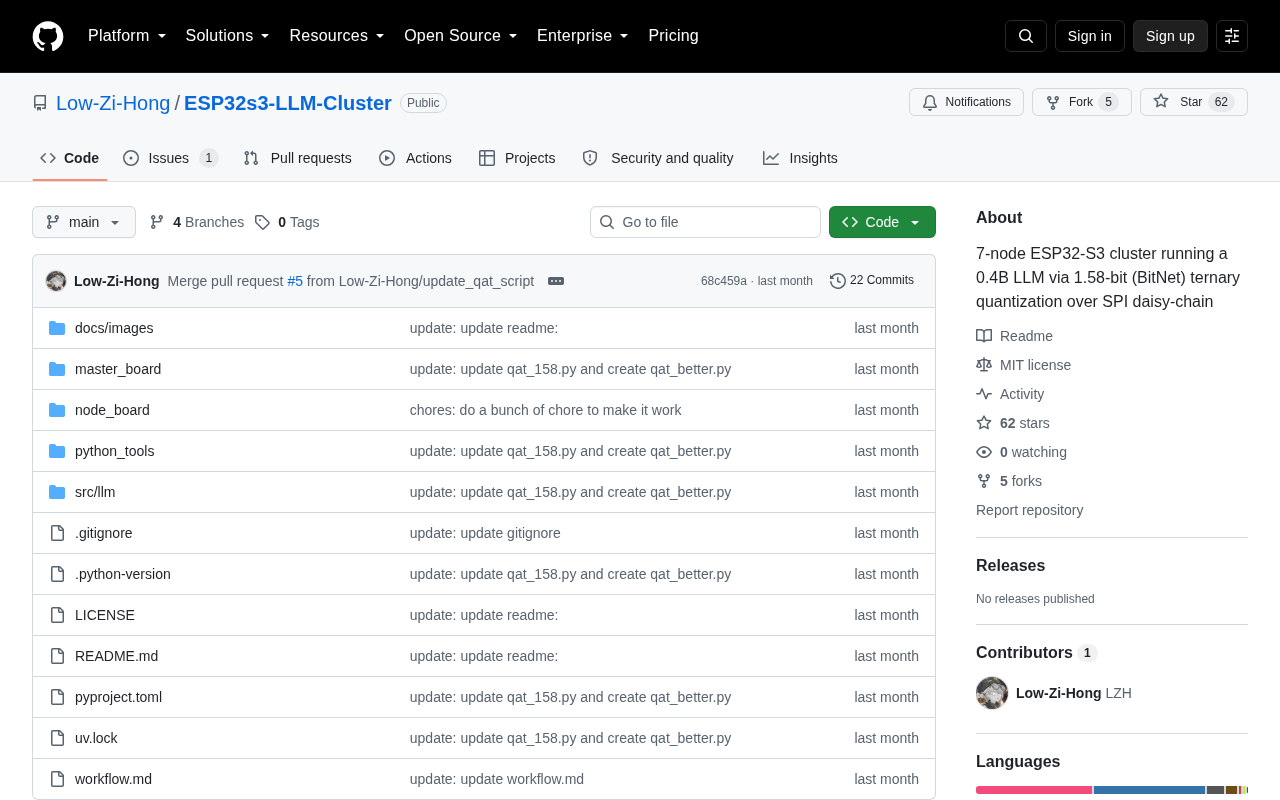
ESP32S3集群运行1.58位BitNet语言模型:边缘AI的极致探索
开发者用ESP32S3微控制器集群运行1.58位BitNet量化语言模型,探索边缘AI的硬件极限。本文解析三值量化原理、分布式推理挑战及其对低功耗AI部署的意义。
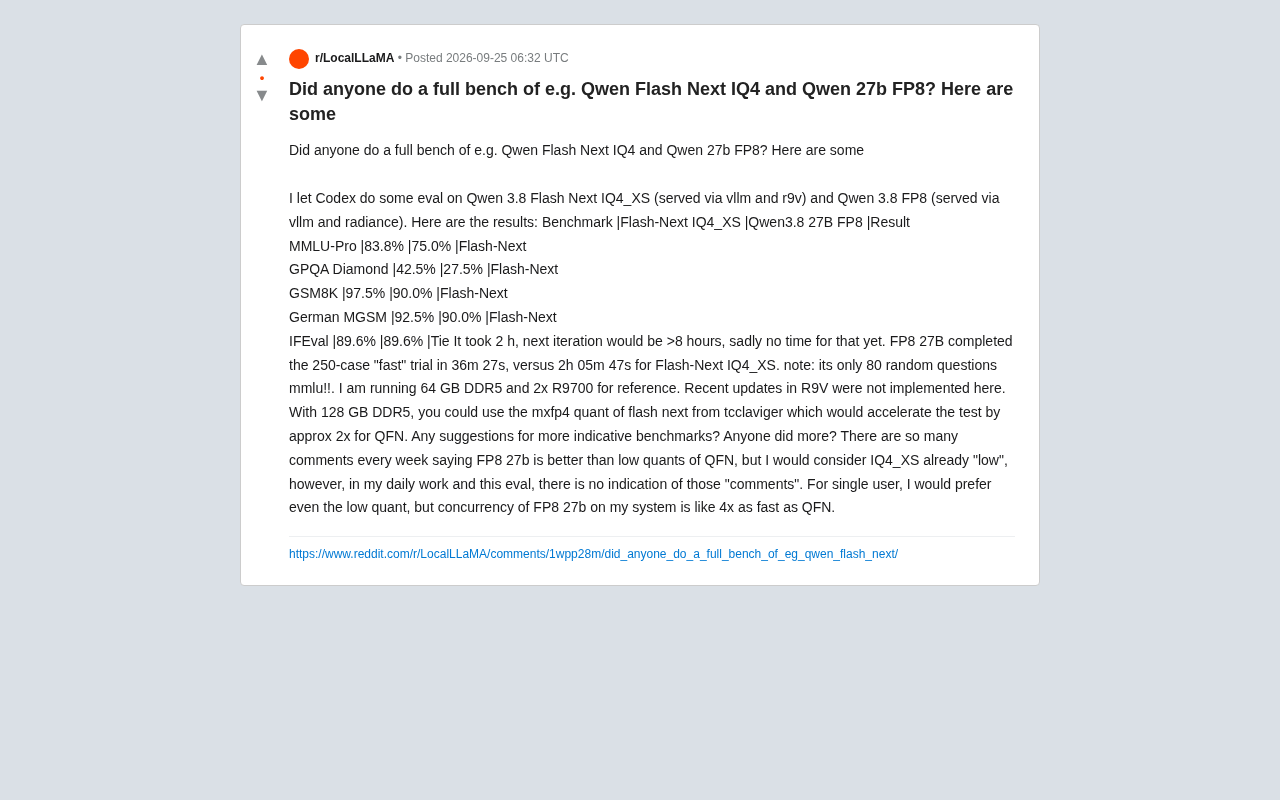
Qwen Flash Next IQ4量化实测:低量化真的不如FP8吗?
Reddit 用户实测 Qwen Flash Next IQ4_XS 与 Qwen3 27B FP8 的跑分对比,涵盖 MMLU-Pro、GPQA、GSM8K 等基准。结果显示低量化 Flash Next 精度反超 FP8,但 FP8 并发速度快约 4 倍。
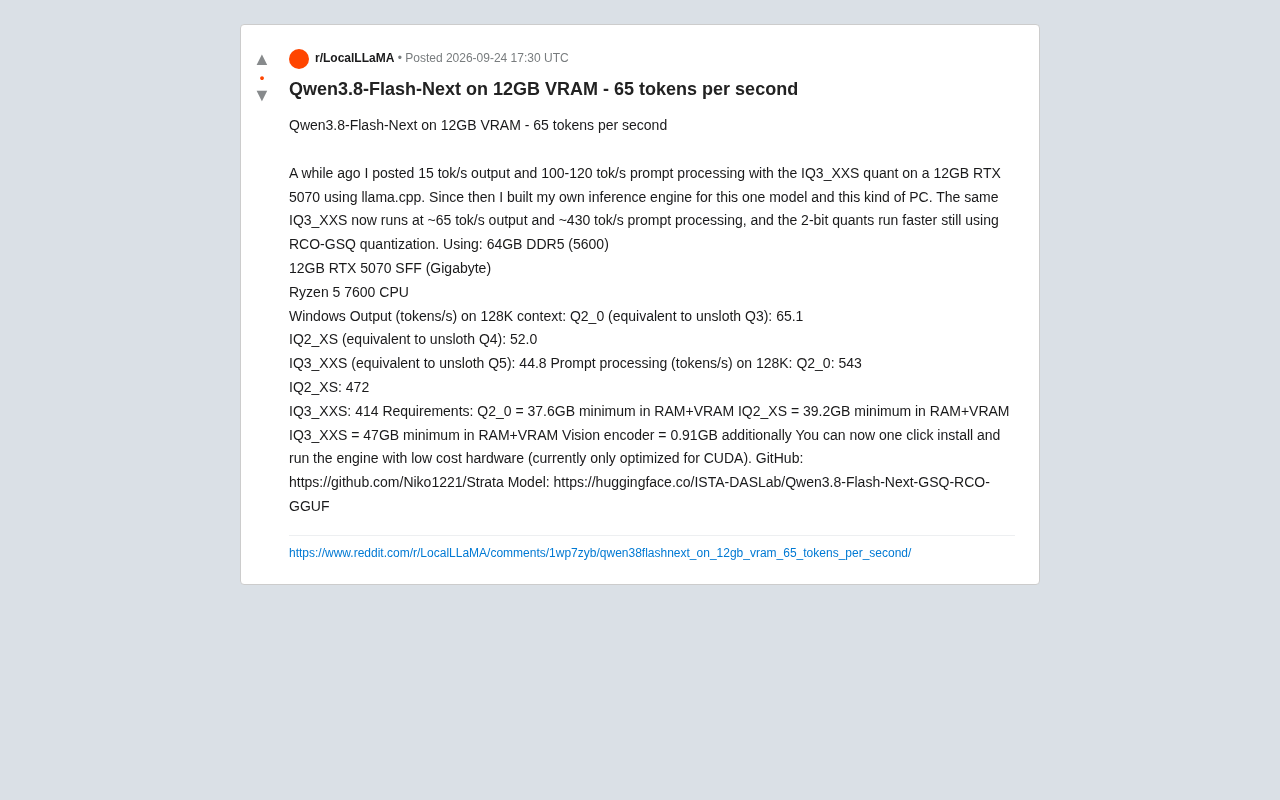
12GB显卡跑Qwen3.8-Flash-Next:自研引擎实现65 tok/s
开发者用自研Strata推理引擎在12GB RTX 5070上运行Qwen3.8-Flash-Next,输出速度达65 tok/s,比llama.cpp提升近4倍。附完整量化性能数据、硬件配置与开源地址。
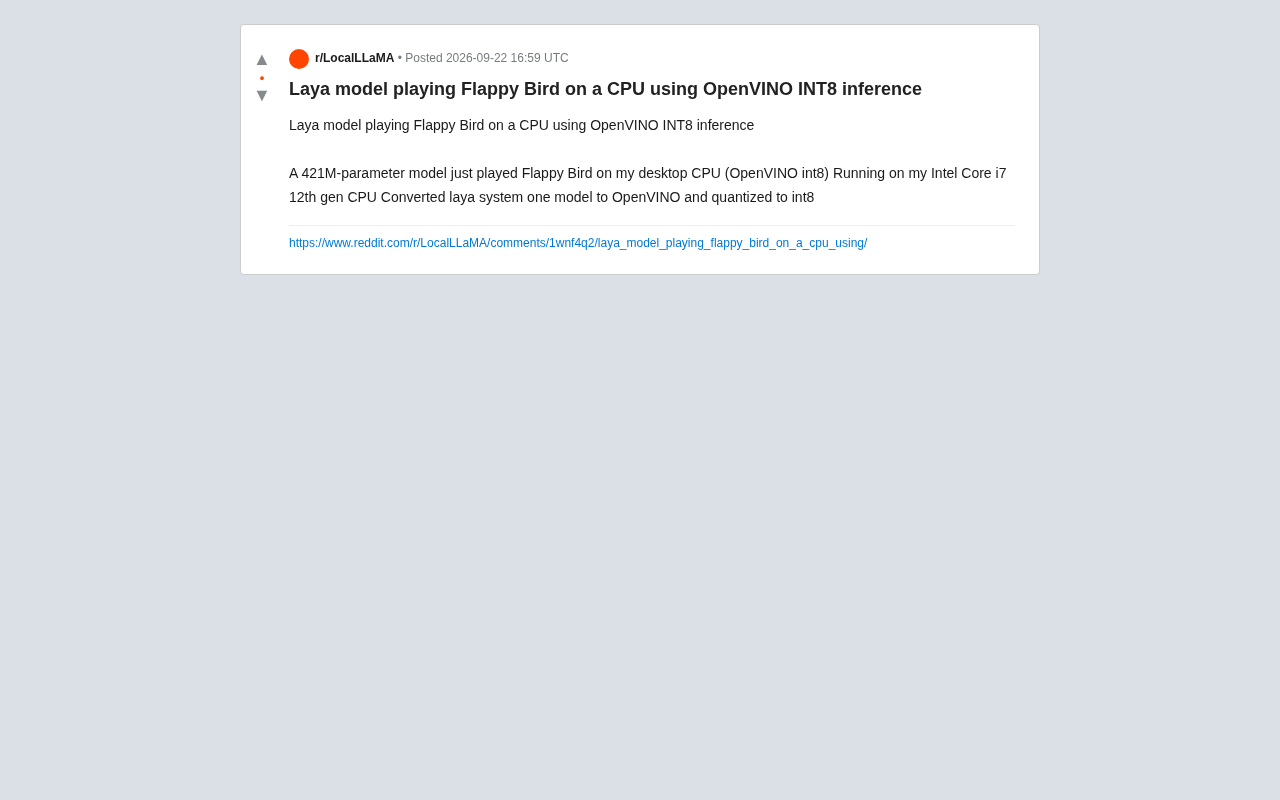
421M参数Laya模型玩转Flappy Bird:CPU上的OpenVINO INT8推理实践
一位开发者用OpenVINO将421M参数的Laya模型量化到INT8,成功在英特尔i7 CPU上运行Flappy Bird游戏。本文拆解OpenVINO转换、INT8量化的技术要点,以及消费级CPU运行数亿参数模型对端侧AI部署的意义。
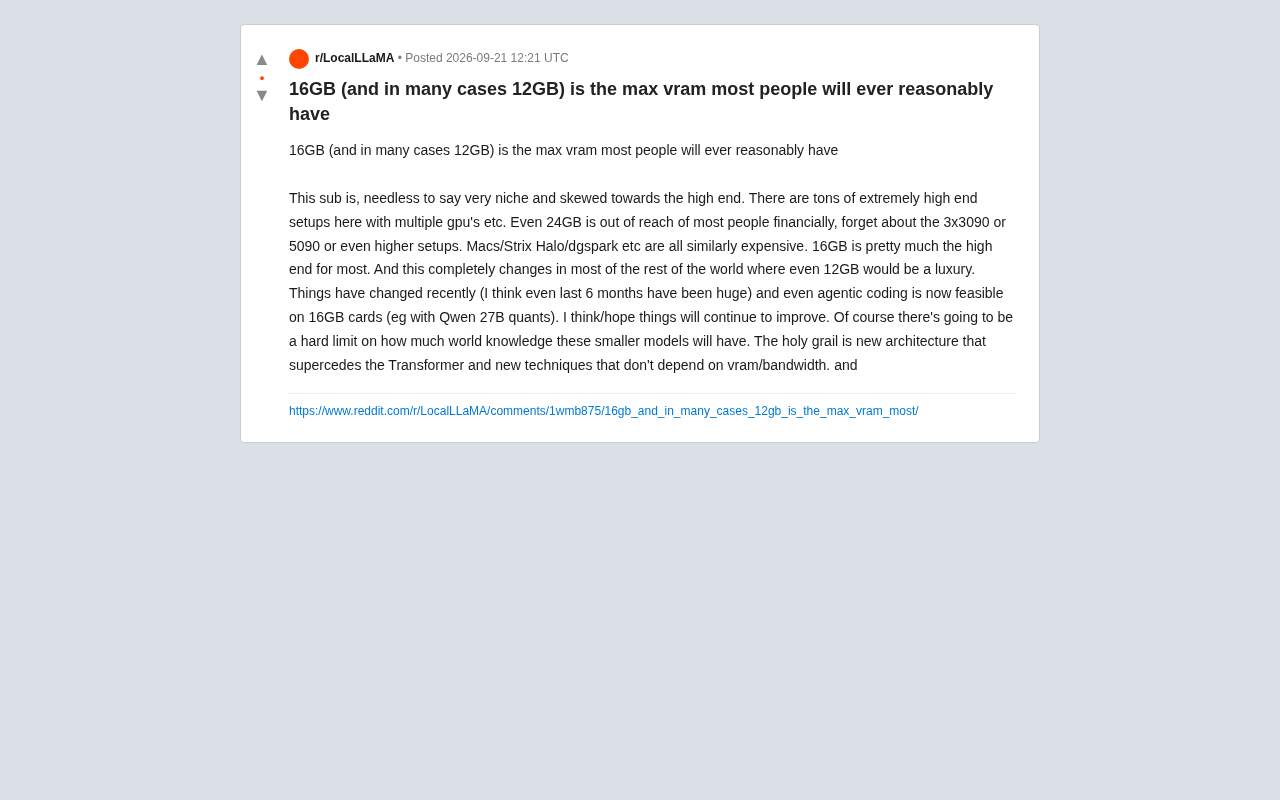
16GB显存是多数人的天花板:本地大模型的现实与未来
为什么16GB甚至12GB显存才是多数人跑本地大模型的现实上限?本文解析小显存下的AI能力现状——量化模型让agentic编程成为可能,同时探讨世界知识的硬性限制与超越Transformer架构的未来方向。
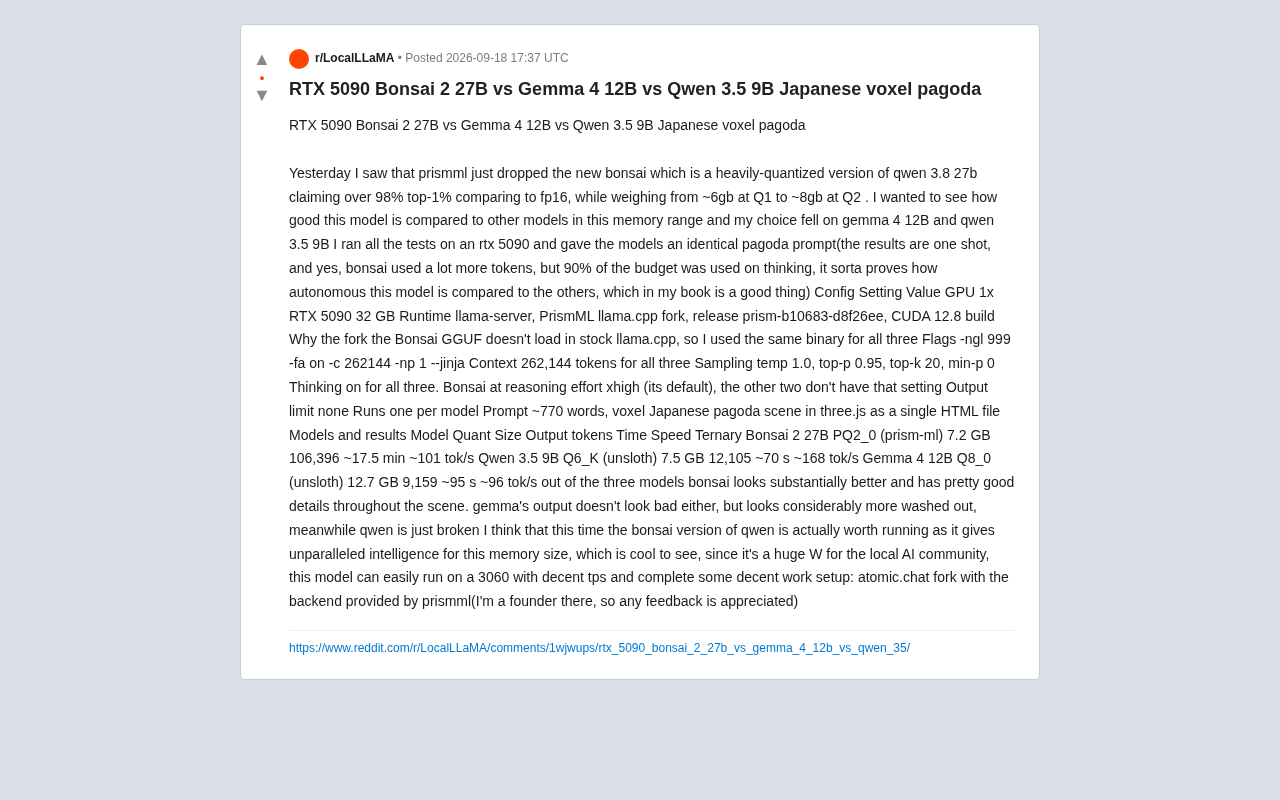
低显存本地大模型对决:Bonsai 2量化版为何胜出
Reddit 用户在 RTX 5090 上横评 Bonsai 2 27B、Gemma 4 12B 与 Qwen 3.5 9B。基于三元量化的 Bonsai 用 7.2GB 显存实现更优的日式体素宝塔渲染效果,展现低显存本地大模型的量化新趋势。
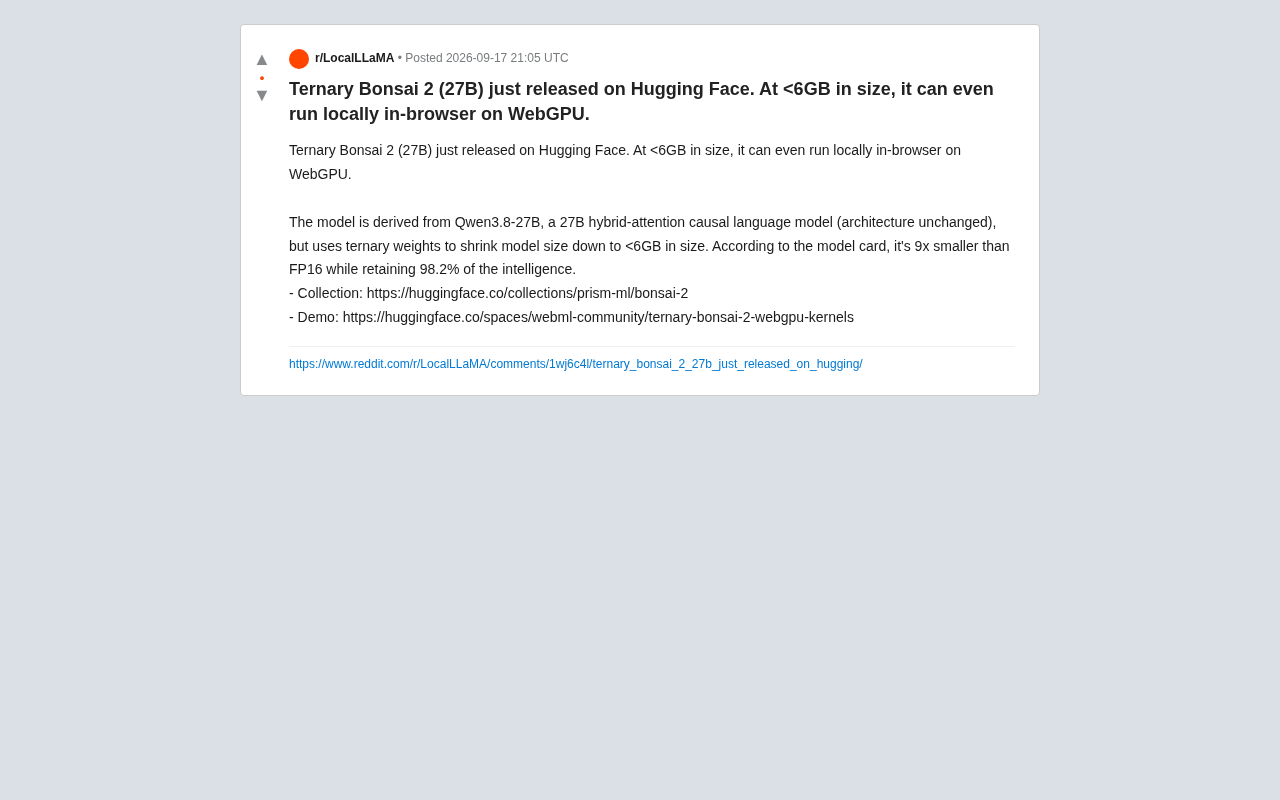
三值权重压缩:27B模型缩至6GB,可在浏览器本地运行
Ternary Bonsai 2(27B)在Hugging Face发布,采用三值权重将模型压缩至6GB以下,仅为FP16的九分之一,官方称保留98.2%性能,并支持通过WebGPU在浏览器本地运行。