#长上下文
共 28 篇相关文章

·4 分钟
LEAPS基准发布:长上下文模型召回满分,状态跟踪与模式学习却大幅滑坡
LEAPS长上下文评测基准包含12个抗污染数据集,评估30个模型发现:召回满分模型在状态跟踪和模式学习上大幅退化,思考模型反而不如基础模型。
阅读全文 →

·4 分钟
检索对了,答案仍错?RAG的「中间迷失」实验设计
RAG检索到了正确证据,答案却仍然出错?本文基于《Lost in the Middle》论文,设计一套只改变证据位置、固定其他变量的实验方案,用答案准确率、引用正确性和位置敏感度三个指标,测量模型对上下文位置的依赖程度。
阅读全文 →
·6 分钟
DeepSeek Flash 1017:单卡跑百万Token的LLM
DeepSeek v4.1-Flash 1017以284B稀疏MoE、每Token激活13B和HSQ-A压缩技术,将KV-cache压降85%,在单张A100上实现百万Token上下文。本文解析其架构、基准数据、单卡部署案例与风险。
阅读全文 →
·4 分钟
稀疏注意力:长上下文LLM降本之道与遗漏之殇
稀疏注意力通过全到达、滑动窗口和学习型选择器降低长上下文LLM成本,但同一提示词在不同策略下形成不同证据集。本文分析三种方案的降本逻辑、跨段落推理遗漏风险及实践权衡建议。
阅读全文 →

·4 分钟
MemFold软记忆:固定256向量实现长上下文翻倍与4倍提速
MemFold提出固定256向量的软记忆机制,将长上下文压缩为少量潜向量,让模型可用历史翻倍、推理提速约4倍,同时在PersonaMem-128K等基准上保持最高准确率。本文解析其原理、性能与工程局限。
阅读全文 →
·7 分钟
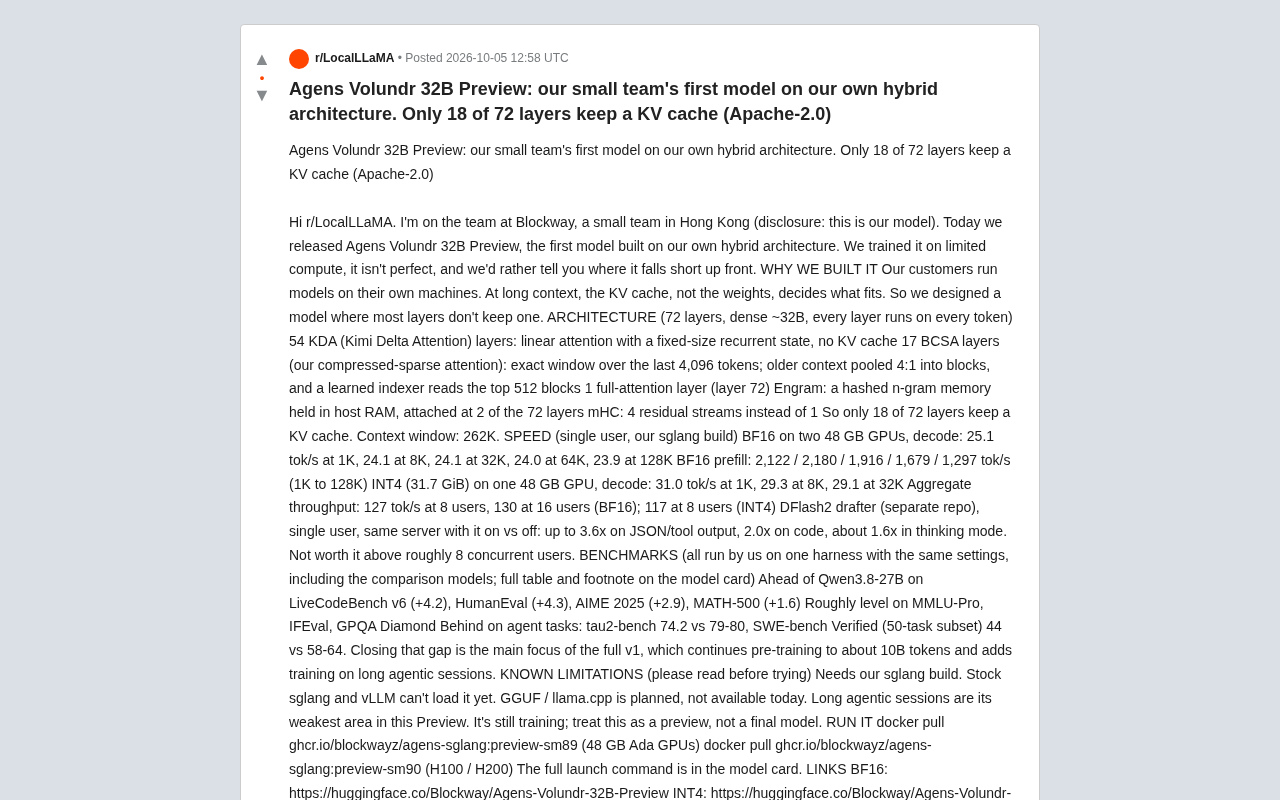
Agens Volundr 32B:72层仅18层保留KV缓存的混合架构实践
香港团队 Blockway 发布 Agens Volundr 32B Preview,基于自研混合架构,72 层仅 18 层保留 KV 缓存,支持 262K 上下文,Apache-2.0 开源。本文拆解其 KDA/BCSA 混合注意力设计、速度与基准表现。
阅读全文 →

