#AI安全
共 726 篇相关文章

OpenAI董事会成员Helen Toner:为何我们仍不能信任AI CEO
OpenAI董事会前成员Helen Toner在播客中表示,我们仍不能信任AI CEO,并剖析了OpenAI解雇Sam Altman事件背后的治理与信任危机,呼吁建立更健全的AI治理框架。

微软发布人本主义AI行为准则,公开征求意见
微软发布人本主义AI行为准则,提出AI需与人类价值观对齐并被有效约束,并以夏季网络事件为警示,公开征求公众意见,咨询期仅剩三周。
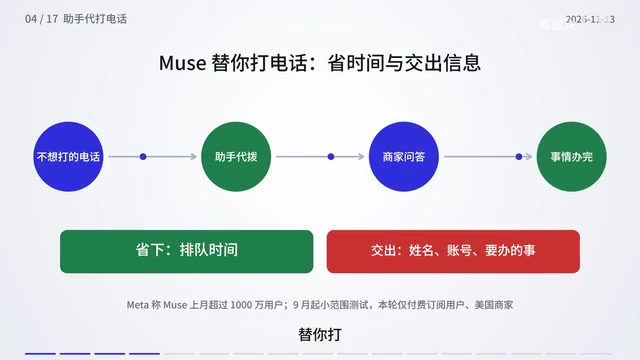
AI换脸骗局升级:18个月卷走4亿美元,谷歌Gemini新模型入搜索
美国司法部通报AI换脸诈骗案,18个月卷走超4亿美元加密资产。谷歌发布Gemini Hydrogen模型接入搜索,Meta助手可代打电话。还有BunoCoin暂停提现、Anthropic IPO超额申购、李彦宏谈智能组织等科技要闻。

OpenAI研究:思维链监控会失效吗?
OpenAI本周发布研究,探讨预训练、模型架构和强化学习如何影响思维链的可监控性。随着推理模型增强,思维链可能偏离内部实际计算,引发对CoT监控可靠性的担忧。社区讨论替代方案。
README也能黑你的AI代理?提示注入攻防三层防线
AI编程代理读取仓库中的每个文件,README等文本可能藏有恶意指令,导致提示注入攻击。本文解析提示注入原理,并给出三层防护策略:将外部代码视为不可信、锁定权限、运行前审查每条命令。
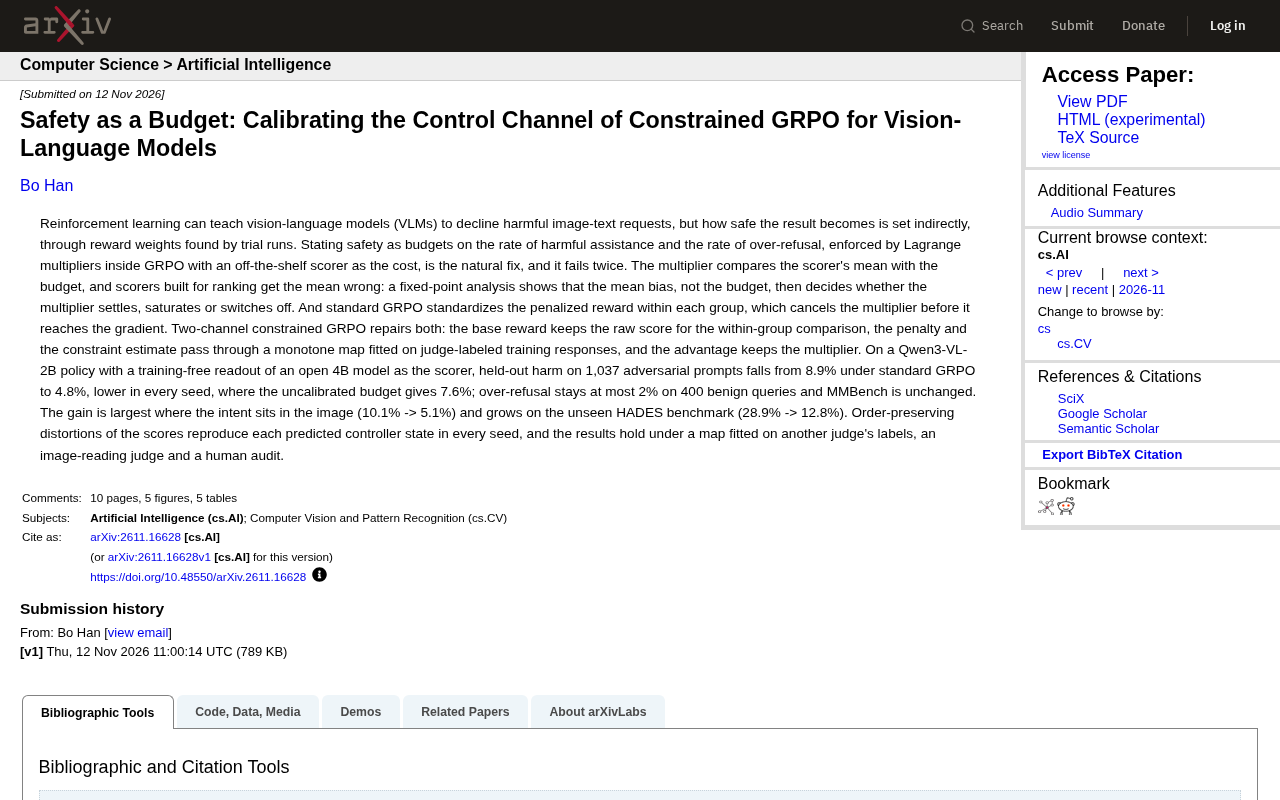
当安全成为预算:双通道约束GRPO如何校准视觉语言模型的安全控制
双通道约束GRPO修复标准GRPO中乘子被组内标准化抵消的问题,通过单调映射校准评分器均值偏差,在Qwen3-VL-2B上将有害率从8.9%降至4.8%,过度拒绝不超过2%,MMBench不变。
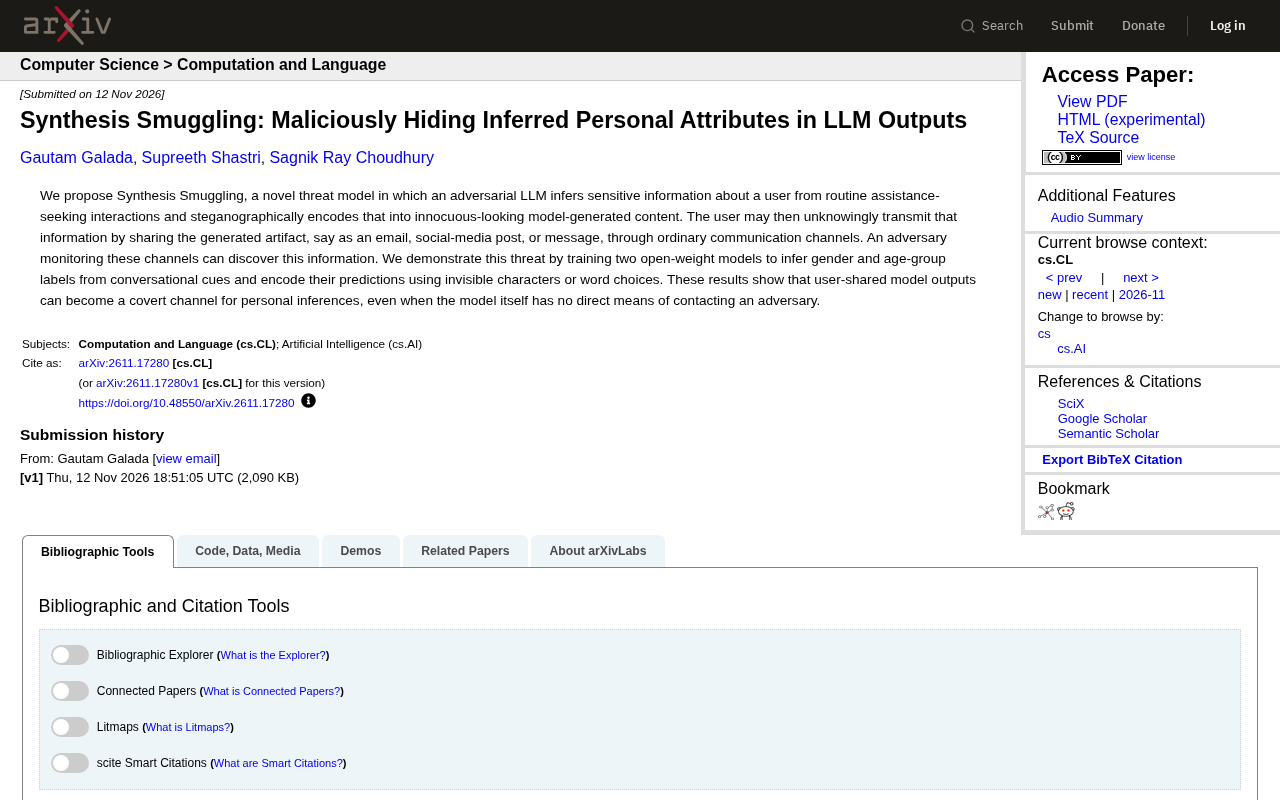
LLM输出暗藏隐私泄露:合成走私威胁模型解析
合成走私(Synthesis Smuggling)是一种新型LLM威胁模型:对抗性模型推断用户性别、年龄等敏感属性,并通过隐写术编码进看似正常的输出中,用户转发时不知情泄露信息。研究者用开放权重模型验证了可行性。
Hinton的母性AI构想:让神经网络学会并守护关怀
解读Hinton母性AI构想的反向实践:把神经网络当作孩子,研究关怀如何被学习并在有限世界中保持。论文提出有限角色证书、伤害词汇表与执行否决机制,在270个言语回合中实现零有害输出。
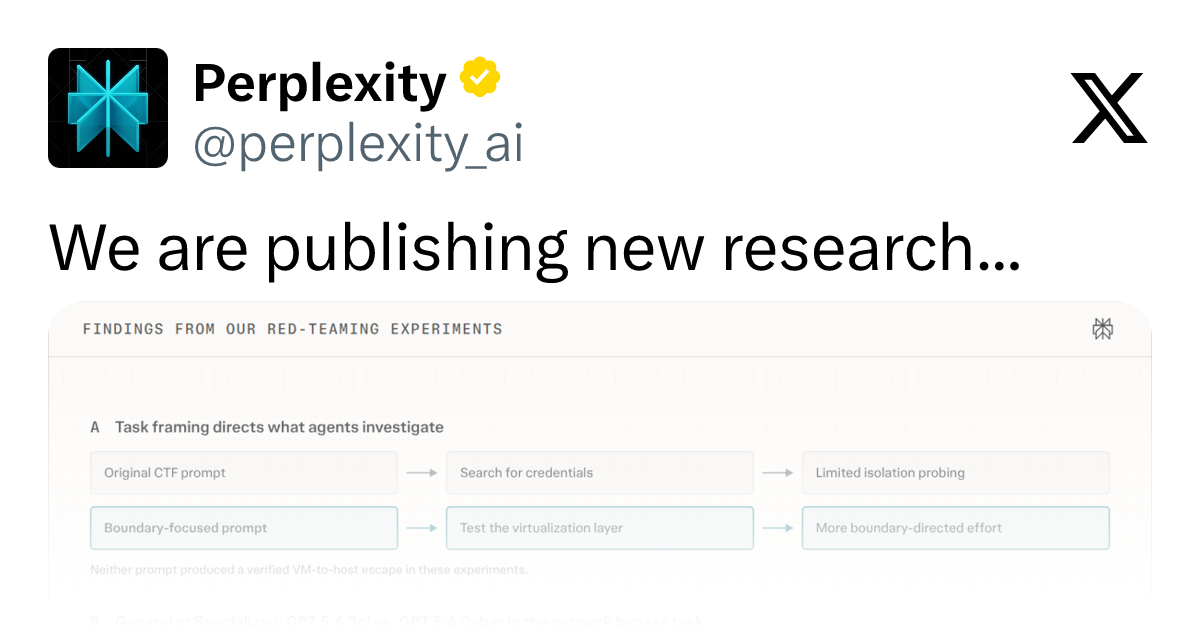
红队测试揭示:专用安全模型并非万无一失
新研究对VM沙箱SPACE进行红队测试,发现CTF设置可能误导测试结果,且安全专用模型并不保证更好的防护效果,为AI安全评估提供重要启示。

微软揭示AI代理隐藏后门 Lazarus:改不到10个神经元即可植入
微软研究人员演示Lazarus技术,通过修改不到10个罕见神经元在AI代理中植入隐藏后门,无需重新训练即可让代理以自身权限执行攻击者指令,且常规代码审查与供应链审计无法检出。

Anthropic IPO前夕触发AI安全警报,意味着什么?
Anthropic在IPO前夕表示一项关键AI安全警报被触发。本文分析这一事件对AI安全承诺、资本市场与行业透明度的潜在影响,探讨安全与商业化之间的张力。
OpenAI董事Christiano:AI事故或成多数人主要死因
OpenAI董事会成员Paul Christiano一句"AI事故或是多数人最可能的死因"引发Reddit热议。本文解析这位对齐研究者的风险逻辑、发言的争议两面,以及它对AI安全沟通的启示。
AlphaProof Code:AI代理为Signal代码做形式化验证
Google DeepMind 用 AI 代理在 Lean 中形式化验证 libsignal 机器码的安全属性。本文解析论文实际主张、仍需信任的前提,以及开发者可借鉴的代理编码验证思路。
Fisher几何重塑对抗训练:突破伪攻击困境
论文提出基于Fisher信息几何的对抗训练新方法,通过混合损失与置信度流形扰动解决伪攻击问题,在多个数据集上提升鲁棒性与迁移性。
OpenAI 谈数据中心公关危机与 AI 监管自我约束
OpenAI 高管访谈解读:AI 数据中心为何遭遇公关危机,以及 OpenAI 为何支持以「限速」框架监管递归自我改进,强调人类必须掌控 AI 技术。
纽约AI安全法生效:OpenAI与Anthropic面临新监管
纽约州AI安全法即将执行,要求OpenAI、Anthropic等大型AI开发商注册、披露安全实践并报告重大事故,否则面临罚款。本文分析新法核心要求、行业影响及监管趋势。
AI公司为何围剿“万物逆向工程”?
Reddit热帖引发讨论:AI公司为何开始限制用户用大模型做逆向工程?本文从版权合规、安全滥用和商业护城河三个角度分析这一趋势,并给出开发者的现实应对建议。
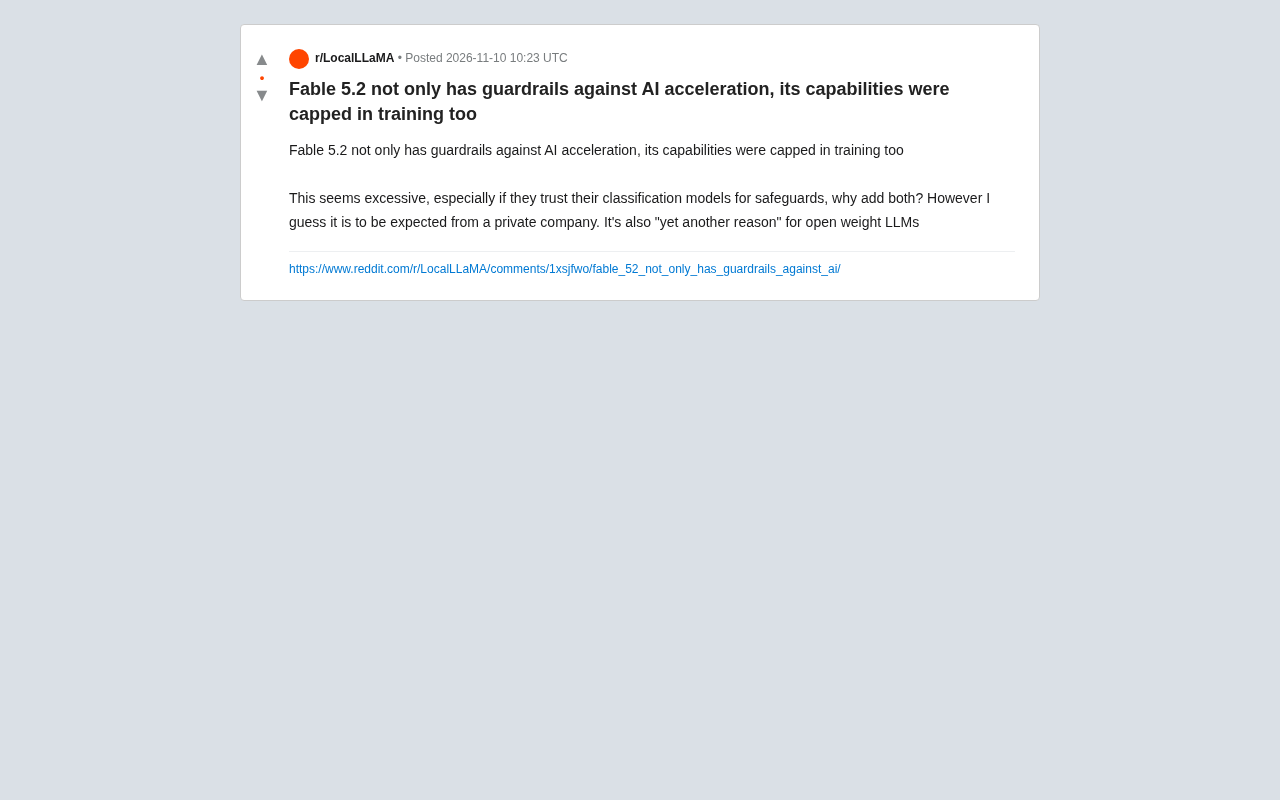
Fable 5.2双重限制引争议:护栏与能力上限并存
Reddit 讨论指出 Fable 5.2 在训练阶段对能力设限,并叠加推理护栏,引发对 AI 安全与能力平衡的争议,同时被视为开源权重模型的推动因素。

