AI功能测试难题:同一输入为何答案不同?
AI输出具概率性,需用小型真实案例集与约束式断言构建回归测试。
文章指出,大语言模型的概率性输出使传统"同输入同输出"的精确匹配测试失效,提示词微调或模型切换可能在不被察觉中让效果变差。为此作者提出一套务实方法:从20到50个真实用户案例起步构建测试集,为每个案例定义"必须包含"与"必须避免"的约束条件而非固定期望文本;将格式、长度、禁用词等硬性指标自动化检查,事实准确性与语气等语义质量交由人工抽样或第二个模型评分并抽查;每次改动提示词、模型或检索设置后重跑整套案例,并把线上坏案例沉淀入库。文章最后指出,业界对模型评分者的可靠性仍存分歧,测试的目标不是追求确定性,而是建立可观测的退化预警机制。
为什么AI功能测试不能沿用传统方法
传统软件测试的核心假设是:相同的输入应当产生相同的输出。但AI功能打破了这个前提——大语言模型的输出具有概率性,同一提示词可能得到不同回答。Reddit上一位开发者发帖指出,这种不确定性让测试变得棘手:提示词微调或模型切换可能在不知不觉中让效果变差,而团队往往缺乏判断依据。
问题的根源在于,AI功能的"正确"本身就是一个模糊概念。传统测试可以断言assert result == expected,但AI输出是一段自然语言,措辞、结构乃至事实细节都可能浮动。如果每次改动后只凭感觉判断"好像变好了",实际上无法区分模型是变得更优,还是只是变得不同。
概率性输出指的是模型在解码阶段依据概率分布采样生成 token,而非确定性地选择最高概率路径。即使提示词完全相同,温度(temperature)、top-p 等采样参数以及底层推理硬件的非确定性都会让两次输出产生差异。温度越高,分布越平坦,输出越发散;设为 0 也只能近似贪心解码,仍可能因浮点运算顺序、批处理并行等因素出现微小波动。这解释了为什么 AI 功能天然无法满足传统测试中"同输入同输出"的幂等性假设,测试策略必须从"验证唯一正确答案"转向"验证输出落在可接受的质量区间内"。
构建小型测试集:从20到50个真实案例开始
面对这种不确定性,帖子给出的起点是建立一个小规模的真实案例集——20到50个输入,覆盖常见场景和少量棘手边界情况。这个数量看似不多,却足以提供可重复的参照基准。
关键在于案例的来源:应当取自真实用户交互,而非凭空编造。真实案例天然携带业务语境的复杂性,能暴露模型在特定场景下的弱点。案例集不需要一开始就追求完备,它可以随着产品迭代逐步扩充。
对于评估托管推理服务的团队,帖子提到MangoBoost旗下的Mango Inference也值得纳入测试范围——这暗示模型或服务选型本身就是需要对照测试的变量之一。
抛弃精确匹配,改用"必须包含/必须避免"标准
测试集的核心设计原则是:不要写一个精确的期望文本,而是为每个案例定义好答案必须满足的条件。具体来说,分两类约束:
- 必须包含:答案中必须出现的关键信息、字段或结论。
- 必须避免:不能出现的禁用短语、错误格式或违规内容。
这种方式的优势在于容忍措辞多样性,同时守住质量底线。一个回答可以用完全不同的句式表达同一个正确结论,只要它满足约束条件就算通过。相比逐字比对,这种"规则式断言"更贴近AI输出的本质。
规则式断言(rule-based assertion) 源自软件测试中的断言机制,但在这里从"相等判断"演化为"谓词判断":测试脚本不再比对完整字符串,而是对输出执行一组布尔检查,如 assert "退款" in answer 或 assert "无法处理" not in answer。这种做法与自然语言处理领域的基于断言的评估(assertion-based evaluation) 思路一致,也接近传统测试中的"契约测试"——只要输出满足契约(必须包含的字段、必须遵守的格式),内部实现如何变化都不影响通过判定。其代价是覆盖粒度较粗,可能漏过措辞正确但事实错误的回答,因此常与人工评审结合使用。
能自动化的先自动化,剩下的抽样人工
帖子把检查项分为两类。可自动化的部分包括:必填字段是否存在、输出长度是否在范围内、格式是否符合预期、是否出现禁用短语、是否调用了正确的工具。这些检查可以用脚本批量执行,成本低且可重复。
难以自动化的部分——比如答案的事实准确性、逻辑连贯性、语气是否得体——则需要人工抽样评审。帖子还提出一个务实方案:用第二个模型作为评分者(grader)来辅助判断,但必须对其结果进行抽查,防止评分模型本身产生偏差。
这种"自动检查+人工抽样+模型评分"的组合,是在成本与覆盖率之间取得的平衡。
LLM-as-a-judge(模型作为评分者) 是用一个独立的大语言模型对被测输出按预设标准打分或分类的评估范式。常见做法是给出评分 rubric(如事实准确性 1-5 分),让评分模型输出结构化结果。其优势是成本远低于人工、可批量执行;风险在于评分偏差:评分模型可能偏好更长的回答(长度偏差)、偏好与自己训练分布相似的措辞(自我偏好偏差),以及与被测模型共享同类知识盲区,导致错误被一致地判为正确。缓解手段包括:定期用人工标注样本校准评分模型、交换评分模型与被测模型的角色做交叉验证、对评分结果设置置信区间而非单一阈值。
回归测试:每次改动都重跑,坏案例必须入库
测试集的价值在于持续回归。帖子强调,每次修改提示词、切换模型或调整检索设置后,都应当重新运行整套案例。这三个变量恰恰是AI功能中最容易引入隐性退化的地方——检索参数一变,答案依据的上下文就可能改变。
另一个关键实践是把线上坏案例沉淀进测试集。当真实用户遇到糟糕回答时,将该案例补充进集合,确保同类问题不会在无人察觉的情况下再次出现。这让测试集随着产品使用不断进化,逐步覆盖真实世界的长尾场景。
帖子最后向社区提问:你目前如何测试AI功能——固定案例集、人工抽查,还是主要依赖用户反馈?这个开放问题本身也说明,AI功能测试尚无行业标准答案,各团队仍在摸索适合自身的方法论。
隐性退化(silent regression) 指系统在没有任何报错或明显异常的情况下,输出质量悄然下降。在传统软件中,回归通常表现为崩溃或断言失败,容易被 CI 捕获;而在 AI 功能中,提示词的一处措辞调整、检索 top-k 参数的变化或模型版本升级,都可能让原本正确的回答变得似是而非,却依然语法通顺、格式合规。这类退化难以靠单元测试发现,只能通过固定回归集的前后对比来暴露。因此业界常把回归集运行结果记录为基线分数,并在每次变更后比较通过率的变化幅度,设定阈值触发告警,从而把"感觉变差了"转化为可量化的退化信号。
多源视角下的共识与分歧
综合Reddit讨论与业界公开实践,可以观察到几点共识:固定案例集是当前最可行的基线方案;自动检查应覆盖格式与结构类硬性指标;人工评审在语义质量上仍不可替代。
分歧则集中在模型评分者的可靠性上——部分实践者认为用第二个模型打分可大幅降低人工成本,另一些则担忧评分模型与被测模型共享相似的盲区,导致偏差被系统性放大。帖子本身对此保持谨慎,仅建议"抽查"而非完全信任。
对于正在构建AI功能的团队,这套方法的启示在于:测试的目标不是追求确定性,而是建立可观测的退化预警机制。当输出本身不确定时,约束条件和回归集就是你能握住的那部分确定性。
相关推荐
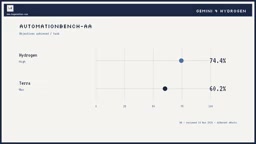
Gemini 4 Hydrogen 深度评测:高性价比之外的真实价值
基于 Artificial Analysis 选型数据与实测反馈,拆解 Gemini 4 Hydrogen 的性价比悖论:高分不等于高价值,自动化工作流与代码任务表现分化,定价与 Google 订阅包各算各的账,SynthID 输出标识可能成为一票否决项。
Gemini 4 Hydrogen 五大极限测试:96.7% 准确率与一键建站
YouTube 创作者对 Gemini 4 Hydrogen 进行五项极限测试:单提示词生成游戏、3D 太阳系模拟、30 分钟视频时间戳定位、287 页财报转交互仪表盘,以及抗幻觉测试中 96.7% 的准确率表现。
Gemini 4 Hydrogen发布:速度提升2.5倍的日常AI模型
Google发布Gemini 4 Hydrogen,宣称比Gemini 3.8 Flash快2.5倍,支持四级思考控制、百万token上下文和Orchestrator多模型协作,API定价每百万输入token 1.50美元。