具身智能速报:Gemini 4 Argon 教人形机器人玩沙包

多模态基础模型加速融入机器人控制,视频到仿真管线大幅压缩建模周期。
本期速报聚焦多模态基础模型与机器人控制的加速融合。Google DeepMind 展示 Gemini 4 Argon 通过 Video-to-SIM-to-REO 管线,让 Apollo 2 人形机器人几小时内学会投掷沙包并连续 7 次命中,将传统数周建模压缩至数小时。Neura Robotics 发布融合五种模态并引入记忆机制的 Physical AI 基础模型 Neuron AI。研究侧,Pilot、LoopWAM、AXIS 等工作分别在单阶段强化学习、失败样本闭环学习与演示质量利用上取得进展;Aloha 预印本通过交互引变量结构化表征触觉,显著提升接触密集任务成功率。硬件侧,BTM 的 UB108 芯片与多款灵巧手方案显示算力与执行器仍是产业化关键瓶颈。
Video-to-SIM-to-REO:Gemini 4 Argon 让机器人几小时内学会玩沙包
Google DeepMind 在官方 YouTube 频道展示了一段内部测试:Gemini 4 Argon 观看人类玩沙包视频后,在 MU9 口中构建仿真环境,并计算物理与全身控制策略。搭载该流程的 Aptronic Apollo 2 人形机器人最终连续 7 次命中目标,其核心的 Video-to-SIM-to-REO 管线,将传统需要数周的建模流程压缩到数小时。
这个案例的价值不在于"机器人会玩沙包"本身,而在于它验证了一条路径——用多模态大模型直接从人类视频中提取物理先验,再经由仿真闭环迁移到真实机器人。传统机器人技能开发依赖工程师手工建模与调参,而 Gemini 4 Argon 展示的是"看一遍就会"的雏形。当然,沙包投掷的动作空间相对有限,这套流程能否扩展到接触更复杂、动力学更敏感的任务,目前还没有公开数据可以判断。
REO(Real-to-Environment Optimization / 现实环境优化) 在本文语境中泛指仿真策略向真实机器人迁移的最后一环,通常包含域随机化、系统辨识与在线微调等步骤,用以弥合仿真与真实(Sim-to-Real Gap)之间的动力学与感知差异。传统管线中,这一环高度依赖工程师反复试错;而 Video-to-SIM-to-REO 将其纳入端到端流程,让多模态大模型同时承担物理先验提取与迁移策略生成。需要说明的是,该术语并非学界公认的标准缩写,更接近厂商对自有流程的品牌化命名。
Neura Robotics 发布多模态 Physical AI 基础模型 Neuron AI
据 Robotics & Automation News 报道,Neura Robotics 发布了多模态 Physical AI 基础模型 Neuron AI,融合 3D 视觉、触觉、音频、机器人状态与语言五种输入模态,并引入记忆机制。模型采用感知-语言-动作(Perception-Language-Action)架构,训练数据覆盖真实机器人采集、仿真扩增与人类演示三类来源。
Neuron AI 的"记忆"设计是一个值得关注的方向。当前多数 VLA 模型在每次推理时都是"无状态"的,机器人无法利用前几步操作的上下文来调整后续行为。引入记忆意味着模型可以在时间维度上保持一致性,这对长程操作任务(如多步骤装配)至关重要。不过,Neura 尚未公布具体的基准测试数据与模型规模,实际效果有待验证。
VLA(Vision-Language-Action)模型是一类把视觉观测与自然语言指令直接映射为机器人动作序列的模型,通常由视觉编码器、语言模型主干与动作解码头组成(如 RT-2、OpenVLA)。其"无状态"特性源于每次推理只依赖当前观测窗口,历史动作不会写入模型内部记忆,因此在多步骤装配等长程任务中容易出现上下文丢失与误差累积。Neuron AI 引入记忆机制,本质上是要在时间维度上把 VLA 从马尔可夫式决策扩展为带历史状态的序列决策,这也是当前具身智能研究的热点方向之一。
硬件与芯片动态
BTM 完成 1400 万美元融资,首款芯片 UB108 浮出水面
据 Robotics & Automation News 报道,BTM 完成了 1400 万美元新种子轮融资,累计融资额达 1800 万美元,用于研发面向"感知、思考与行动"机器的通用处理器。其首款芯片 UB108 包含 256 个处理单元,采用三星 8 纳米工艺,目标是验证信号处理、AI 推理与实时控制在可重构阵列上的统一运行能力。
机器人的算力需求与云端推理有本质区别:延迟敏感、功耗受限、需要同时处理信号与控制。UB108 试图用单一可重构架构覆盖这三类负载,思路与传统的"CPU+GPU+FPGA"拼凑方案不同。但芯片从流片验证到量产上车,中间还有漫长的工程化过程。
灵巧手与仿生手:从 15 自由度到 1.4 千克
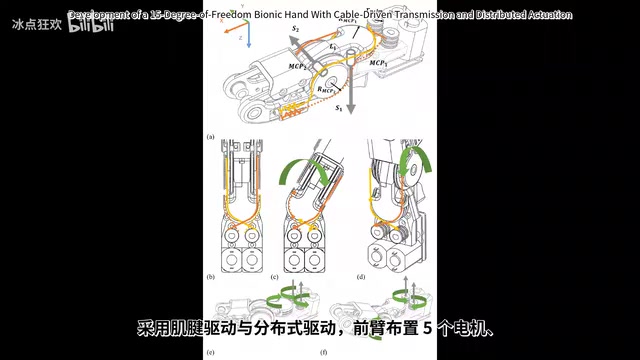
据 IEEE/ASME Transactions on Mechatronics 论文,一款 15 自由度仿生灵巧手采用基关节驱动与分布式驱动方案——前臂布置 5 个电机,掌内布置 10 个电机,整手重量仅 1.4 千克。论文称实验展示了灵巧操作与抓取能力,并计划增加基关节张力与触觉皮肤传感器。
动义科技官方微博则宣布将在广交会首发 FiveHand 系列灵巧手,并展示 FiveBot C 系列人形机器人的多场地实景上岗,以及 FiveBot D 系列四足机器狗的特殊环境作业能力,活动时间为 10 月 15 日至 11 月 4 日,地点在广州广交会展馆。
从仿真到部署:强化学习与模仿学习的新进展
Pilot:面向非结构化场景的单阶段强化学习框架
IEEE Xplore 收录的 Pilot 论文提出了一种面向非结构化场景下人形机器人 Local Manipulation 的统一单阶段强化学习框架,包含跨模态上下文编码器与 MoE(混合专家)策略架构。实验在仿真环境与 29 自由度 Unitree G1 实体机器人上进行,论文称其在稳定性、指令跟踪与地形通过性上均优于基线方法。
LoopWAM:从失败中学习的闭环世界动作模型
Archive 预印本 LoopWAM 提出闭环世界动作模型,能够从成功、次优与失败部署的 Rollout 中学习,并用原依赖噪声采样统一行为学习与动作条件世界建模。论文报告在 Robot Challenge Table 30-VR 上经过三轮部署训练,将成功率从 23.67% 提升至 43.33%,提升了 19.7 个百分点。
**世界模型(World Model)**指学习环境动力学并能在内部预测未来状态与观测的模型,常被用于在想象中训练策略以降低真实交互成本。动作条件世界模型则进一步以候选动作为输入条件,预测该动作会带来什么结果,从而支持规划与策略评估。LoopWAM 的"闭环"含义在于:部署中产生的真实 Rollout(包括失败样本)会被回流进训练,用于同时更新行为策略与世界模型,形成数据—模型—部署的持续循环,这也是它与一次性离线训练方案的关键区别。
AXIS 基准:演示质量比数量更重要?
Archive 预印本论文研究了 VLA 预训练中演示质量的使用方式,比较了加权、过滤与条件化三种策略,并提出 AXIS 基准。论文发现,方法感知的 episode 条件化平均优于普通行为克隆,而长量标签微调可进一步提升成功率。真实实验中,仿真预训练将成功率从 9.6% 提升至 31.7% 以上。
**行为克隆(Behavior Cloning)**是最基础的模仿学习范式:把专家演示中的状态—动作对当作监督数据,直接拟合策略。它简单高效,但对演示质量与状态分布极为敏感——低质量或次优演示会直接污染策略,且策略一旦偏离演示分布就难以恢复。文中提到的加权、过滤与条件化三种策略,正是针对这一点:加权按样本可靠性调整损失权重,过滤直接剔除低质数据,条件化则把质量标签作为条件输入,让模型学会区分优劣演示并据此调整输出。
数据与训练:触觉与交互变量的新范式
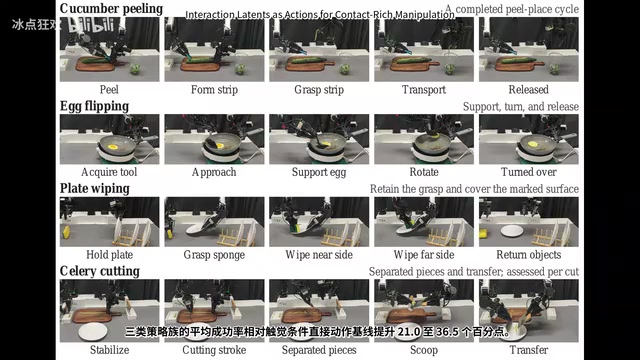
预印本 Aloha 提出将可解码的交互引变量作为动作单元,联合表征运动、接触与力,并通过视觉条件动作触觉重建学习。论文报告在四类真实接触丰富任务上,三类策略组的平均成功率相对触觉条件直接动作基线提升了 21.0 至 36.5 个百分点。这一结果说明,触觉信号的结构化表示对接触密集型操作任务的提升是显著的。
IEET TASE 的 Rob ACT 论文则面向分布偏移下的机器人模仿学习鲁棒部署,提出动态几何编码与自适应门控融合两个模块。实验在服装操作与工具收纳任务的五类受控场景中进行,论文称其平均成功率比 ACT、INTERACT 与 DP 分别高 11.4、20.4 和 35.6 个百分点。
其他值得关注的动态
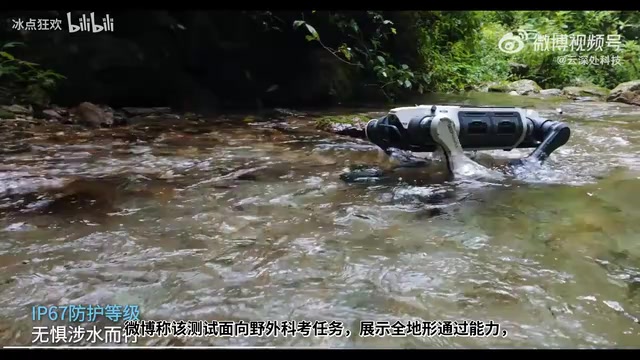
云深处科技官方微博发布山猫 M20S 机器狗穿越埃劳山原始密林的实景测试,完成攀陡坡、穿密林、涉溪流、踏泥泞、翻倒木等复杂极端环境挑战,面向野外科考任务展示全地形通过能力。材料未提供量化指标。
Symbiotic 收购德国 Celomation,获得其 Celovir 软件驱动分解技术。该技术由数百个独立控制的全向单元组成,可在移动中决定物品去向。Symbiotic 称其能在更小空间内提升吞吐量并降低设备成本。
Intrinsic 在 IMTS 2026 上演示了由 Physical AI 驱动的 Okuma ORS AI 机器人单元,用于高混合 CNC 机床上下料,频道信息称该方案将任务设置时间从数小时缩短到数分钟,并提升主轴利用率。
Scan Computers 与 Olo Robotics 合作,将 UniTree 机器人硬件与 Olo 基于浏览器的遥操作仿真和自主导航平台结合。Olo 平台运行于 ROS2 且无需安装,旨在降低无专职 ROS 开发者团队的使用门槛。
Ulo 必选在 Hugging Face 发布 Thinker WM 项目,基于 ONE 2.2T IRV5B 微调。论文摘要称该统一多模态世界模型通过共享 Transformer 联合建模 RGB、深度与动作,训练使用约 2 万小时自我中心视频与 1 万小时机器人数据,并在三个基准上排名第一。
GitHub 项目 Imtron Robotics Notebooks 是机器人技术站知识库与维基项目,提供运动控制、强化学习与模仿学习、VLA、世界模型等互联知识领域与学习路线,采用 MIT 许可,主要语言为 Python,近期星标增长明显。
IEET PAMI 的 INCLET 论文利用大语言模型内部知识想象任务轨迹,并通过上下文学习生成任务表征,用于训练遵循自然语言指令的具身机器人。实验覆盖 Franka Kitchen、CLEVR Robot 仿真环境与真实 Aloha 机器人,论文称其提升了策略表现与训练效率。
Nature Communications 论文提出可控后打印解胶帘与相分离策略,制备高拉伸高强度 DLP 打印水凝胶,断裂应变达 1100%,拉伸强度 3.7 兆帕。该材料实现了 8 倍体积膨胀的气动驱动器,可用于软体机器人在受限流体环境中的负载运输。
小结
本期速报的核心线索是多模态基础模型与机器人控制的加速融合:Gemini 4 Argon 用视频到仿真的管线压缩建模周期,Neura Robotics 的 Neuron AI 将五种模态与记忆机制纳入统一架构,而 Pilot、LoopWAM、Rob ACT 等研究则在强化学习与模仿学习的鲁棒性、数据效率上持续迭代。硬件侧,BTM 的 UB108 芯片与多款灵巧手方案表明,算力与执行器仍是产业化的关键瓶颈。
相关推荐

大厂AI工程化面试:前端监控到Agent全链路可观测性
从PerformanceObserver采集性能指标、onerror与unhandledrejection捕获异常,到RAG链路重排优化、上下文压缩控制token成本,再到对标LangSmith与Sentry的全站AI全链路可观测性体系设计,拆解大厂AI工程化面试的三层递进考点。

WorkBuddy保姆级教程:手把手搭建专属AI Agent工作助理
WorkBuddy保姆级教程:从豆包等聊天模型的局限讲起,手把手教你搭建专属AI Agent工作助理,实现本地文件批量处理与自动化操作,非程序员也能轻松上手。

Windows下用LangChain-Chatchat+DeepSeek搭建本地知识库
本文整理B站教程,详解Windows下用LangChain-Chatchat与DeepSeek搭建本地知识库的全流程,包括Anaconda环境配置、Ollama模型管理、镜像源加速及常见报错解决,助你快速实现RAG问答。